上一节:第四节 GPU 代码生成与动态形状 | 目录 | 下一节:第六节 参考文献与附录
文中参考文献编号 [n] 见第六节;章节号、定理号与习题号全章统一编号,跨节引用照常有效。
11 缓存、并行编译与回退
第 6 至第 9 节讨论了一个区域如何被翻译为内核与包装函数。本节讨论翻译过程本身的三个性质:翻译结果如何复用,翻译如何并行,翻译失败时程序的语义如何保持。最后沿一次完整的调用回顾全章。
11.1 内容寻址缓存
代码生成之后还要调用外部编译器,把 C++ 源码编译为共享库,把 Triton 源码编译为设备代码。这一步的耗时通常远大于 Stax 自身的工作,复用其结果的价值最大。
外部编译可以看作一个函数 $\mathrm{build}: (s, a) \mapsto o$,其中 $s$ 为源码,$a$ 为影响结果的其余因素(编译命令、目标指令集等),$o$ 为产物。若 $\mathrm{build}$ 是纯函数,即产物只依赖于 $(s, a)$,则对它做记忆化(memoization)是安全的:以 $(s, a)$ 为键保存 $o$,相同的键直接返回已保存的产物。
定义 11.1(内容寻址存储) 若存储中每个条目的位置由其内容唯一确定,即存在函数 $h$,使内容为 $c$ 的条目位于 $h(c)$,则称该存储是内容寻址的(content-addressed)。
Stax 以 $h(s, a) = \mathrm{SHA256}(s ,|, a)$ 的截断编码作为文件路径。附加分量 $a$ 中包括完整的编译命令,其中含有与指令集等级(8.1 节)对应的参数,因此以 AVX2 与 AVX-512 编译同一份源码得到两个不同的键。
命题 11.1 设 $\mathrm{build}$ 是 $(s, a)$ 的纯函数,$h$ 可视为取值于 $2^\ell$ 个元素的随机函数。则以 $h(s, a)$ 为键的缓存返回错误产物的概率不超过 $q^2 / 2^{\ell+1}$,其中 $q$ 为缓存中不同键的个数。特别地,缓存不需要任何失效机制。
证明 缓存返回错误产物,当且仅当存在 $(s, a) \ne (s’, a’)$ 使 $h(s, a) = h(s’, a’)$,且二者的产物不同。由生日界,$q$ 个随机值中出现碰撞的概率不超过 $\binom q2 2^{-\ell} < q^2 / 2^{\ell+1}$。若无碰撞,则相同的键对应相同的 $(s, a)$,由纯函数性对应相同的产物。编译器的任何改动只要改变了生成的源码或编译命令,键就随之改变,旧条目不再被读取,因而不需要失效。$\square$
Stax 取 $\ell = 255$,碰撞概率在任何实际规模下都可以忽略。命题 11.1 的实质性前提是纯函数性:$a$ 必须覆盖产物的全部决定因素。编译命令中的头文件与库以路径出现,其内容并不在键中;若它们被就地替换而路径不变,$\mathrm{build}$ 对 $(s, a)$ 就不再是纯函数,缓存可能返回过期的产物。这是一切以文本为键的构建缓存的共同局限,彻底的做法是把依赖文件的内容哈希也计入 $a$。
缓存由多个进程共享时,还须保证并发写入的正确性。由于相同的键对应相同的内容,写入是幂等的,只需保证读者不会看到写了一半的文件。Stax 采用两条规则:只在目标不存在时写入;先写入同目录下的临时文件,再以原子的更名操作使其就位。在 POSIX 文件系统上,同一文件系统内的更名是原子的,并发的读者看到的要么是不存在的文件,要么是完整的文件。共享库的构建以文件锁加双重检查保护,使多个进程同时请求同一内核时编译器只被调用一次。
至此,本章出现了三个层次的复用:第一级分派入口复用上一次的编译产物(2.4 节),特化缓存复用同一特化键下的编译产物(2.2 节),内容寻址缓存复用外部编译器的产物。前两者在进程内,以特化键为键;后者在磁盘上,以生成代码的内容为键。不同的特化版本可能生成相同的内核源码,它们在第三层共享同一个产物。启动配置的实测记录(9.6 节)也以内核源码为键,遵循同样的原理。
11.2 并行编译
一个区域通常生成多个内核,各内核的编译互不依赖,可以并行进行。设有 $n$ 个内核,编译耗时分别为 $c_1, \dots, c_n$,有 $P$ 个工作单元。
命题 11.2 任一贪心的列表调度(有工作单元空闲时即把任一未开始的任务交给它)的完成时间 $T$ 满足
$$\max\Bigl(\frac1P \sum_i c_i,\ \max_i c_i\Bigr) \le T \le \frac1P \sum_i c_i + \max_i c_i.$$
证明 下界显然。对上界,设最后完成的任务为 $j$,开始于时刻 $\tau$。在 $\tau$ 之前所有工作单元都在忙(否则 $j$ 会更早开始),故 $P\tau \le \sum_{i \ne j} c_i$,于是 $T = \tau + c_j \le \frac1P \sum_i c_i + \max_i c_i$。$\square$
这是 Graham 关于列表调度的经典结论 [26] 的特例,它说明贪心调度的完成时间不超过最优值的 2 倍。实际的加速比还受限于不能并行的部分:捕获、图变换、降级、调度与代码生成都在主线程中顺序完成,只有外部编译一步被并行化。
Stax 把并行编译安排在包装函数模块的加载过程中。由代码清单 8.1 与 9.6 可见,模块顶层对每个内核执行一条 async_compile 语句,向编译池提交一个任务并立即返回一个未来对象(future);模块末尾的 async_compile.wait(globals()) 等待全部任务完成,并把未来对象替换为可调用的内核。加载模块因而就是"先提交全部任务,再统一等待",call 被调用时各内核均已就绪。
工作单元的选择取决于编译过程中哪一部分占主导。C++ 内核的编译主体是外部编译器的子进程,等待子进程期间线程释放全局解释器锁(GIL),线程池即可获得并行性;Triton 内核的编译有相当一部分在 Python 中完成,受 GIL 限制,须使用进程池。
11.3 回退与语义契约
编译器对使用者的基本承诺是语义保持:对每个合法输入,编译产物与即时执行的结果在浮点误差范围内相同,且编译与否对调用方不可观察(3.7 节)。性能是第二位的承诺。编译路径上的失败按其能否在不违反第一条承诺的前提下处理,分为两类。
第一类是捕获失败,例如纯符号模式下遇到无法确定的控制流。此时编译器没有得到一个与原函数等价的图,任何回退都需要把区域切分并交回解释器执行,而 TensorPlay 不做这种切分(12.1 节),因此捕获失败直接以异常报告。区域要么整体被编译,要么不被编译。
第二类是后端失败,即降级、调度或代码生成中出现了未覆盖的形式或错误。此时编译器已经持有一个与原函数等价的图,可以直接解释执行该图,逐个调用算子。结果是正确的,但没有任何融合。Stax 默认采取这种回退,第一条承诺得以保持,第二条则被放弃。
回退的问题在于它是不可见的:使用者从结果上无法区分"编译成功"与"回退执行",可能把回退后的性能当作编译后的性能。严格模式(strict_native=True)把第二条承诺也变为可检验的契约:后端失败时抛出异常,而不是回退。基准测试与性能回归检查应在严格模式下进行。
另一项承诺涉及包装函数本身的开销。Python 包装函数每启动一个内核都要执行若干条 Python 语句,设每个内核的解释开销为 $t_{\mathrm{py}}$,则一次调用的主机开销约为 $n \cdot t_{\mathrm{py}}$。这一项与 9.9 节的 $n \cdot t_{\mathrm{launch}}$ 结构相同。Stax 可选地把包装函数生成为一个 C++ 翻译单元,对外只暴露一个以数据指针数组为参数的入口,使主机一侧每次调用的工作量与 $n$ 无关;在 GPU 上,CUDA Graphs 进一步消除了 $n \cdot t_{\mathrm{launch}}$。
11.4 错误的分层定位
编译路径是一串变换的复合 $\mathcal C = T_k \circ \cdots \circ T_1$,每个 $T_i$ 都应保持语义。编译结果与即时执行不一致时,须找出第一个破坏语义的 $T_i$。若能单独执行每个前缀 $T_i \circ \cdots \circ T_1$ 的结果,则不一致的前缀中最短的一个即指出出错的层次。TensorPlay 注册了若干与 Stax 共用前端的调试后端,正是这样的前缀:
backend="eager":执行捕获与图变换后的图,不经过 AOT 与 Stax;backend="aot_eager":在此基础上经过 AOT Autograd 与最小割划分(第 5 节),但前向图与反向图仍逐个调用算子执行;backend="stax":完整的编译路径。
算法 11.1 编译错误的分层定位
输入:函数 f,输入 x(训练区域另需上游梯度)
输出:出错的层次
1  ref ← f(x);训练区域另求 ref 的梯度
2  if compile(f, backend="eager")(x) 与 ref 不一致:      return 捕获或图变换(第 3、4 节)
3  if compile(f, backend="aot_eager")(x) 与 ref 不一致:  return AOT Autograd(第 [5](/zh/posts/tensorplay-stax-02/#5-自动微分与激活重物化) 节)
4  if compile(f, strict_native=True)(x) 抛出异常:         return 降级或代码生成未覆盖
5  if compile(f)(x) 与 ref 不一致:                       return 降级、调度或代码生成(第 [6](/zh/posts/tensorplay-stax-02/#6-降级与循环级中间表示) 至第 [9](/zh/posts/tensorplay-stax-04/#9-gpu-代码生成) 节)
6  return 无错误
前缀只有三个,线性检查即可;若层次更多,可在前缀序列上二分,把检查次数降为 $O(\log k)$。
“一致"的判定须留有浮点容差。前两个后端调用的算子与即时执行相同,结果应当逐位相同;Stax 的内核改变了求和的次序(命题 8.1 与 6.5 节),结果只在舍入误差范围内相同。容差应按 6.5 节的求和误差界选取:长度为 $n$ 的 float32 求和,顺序累加的误差界的系数约为 $(n-1)u$,分块累加约为 $2\sqrt n, u$,其中 $u = 2^{-24}$;两种次序的结果之差也在这一量级之内。超出这一量级的差异才提示真正的错误。
11.5 编译模式
tp.compile 的 mode 参数选择一组预设的优化选项,options 参数逐项覆盖。各模式的设计意图如表 11.1 所示。
表 11.1 编译模式
| 模式 | 预设的选项 | 设计意图 |
|---|---|---|
| default | 无 | 编译时间与运行性能的折中 |
| reduce-overhead | CUDA Graphs | 消除启动开销 $n \cdot t_{\mathrm{launch}}$(9.9 节) |
| max-autotune-no-cudagraphs | 扩大调优、坐标下降 | 以更长的编译时间换取更大的配置搜索空间(9.6 节) |
| max-autotune | 以上二者 | 兼顾两方面 |
解析的顺序是先取模式的预设,再以 options 中的键逐项覆盖,因此 mode="max-autotune", options={"stax.cudagraphs": False} 与 mode="max-autotune-no-cudagraphs" 等价。三类选项分别作用于本章模型的三个参数:CUDA Graphs 作用于 $n \cdot t_{\mathrm{launch}}$,调优作用于配置空间 $\Pi$ 中候选集合 $C$ 的大小,融合作用于内核数 $n$ 与访存量 $Q$。
11.6 端到端执行路径
图 11.1 汇总了 Stax 后端从算子级图到可执行产物的全过程。下面以例 1.1 与例 5.1 为线索,将全章各节串联起来。
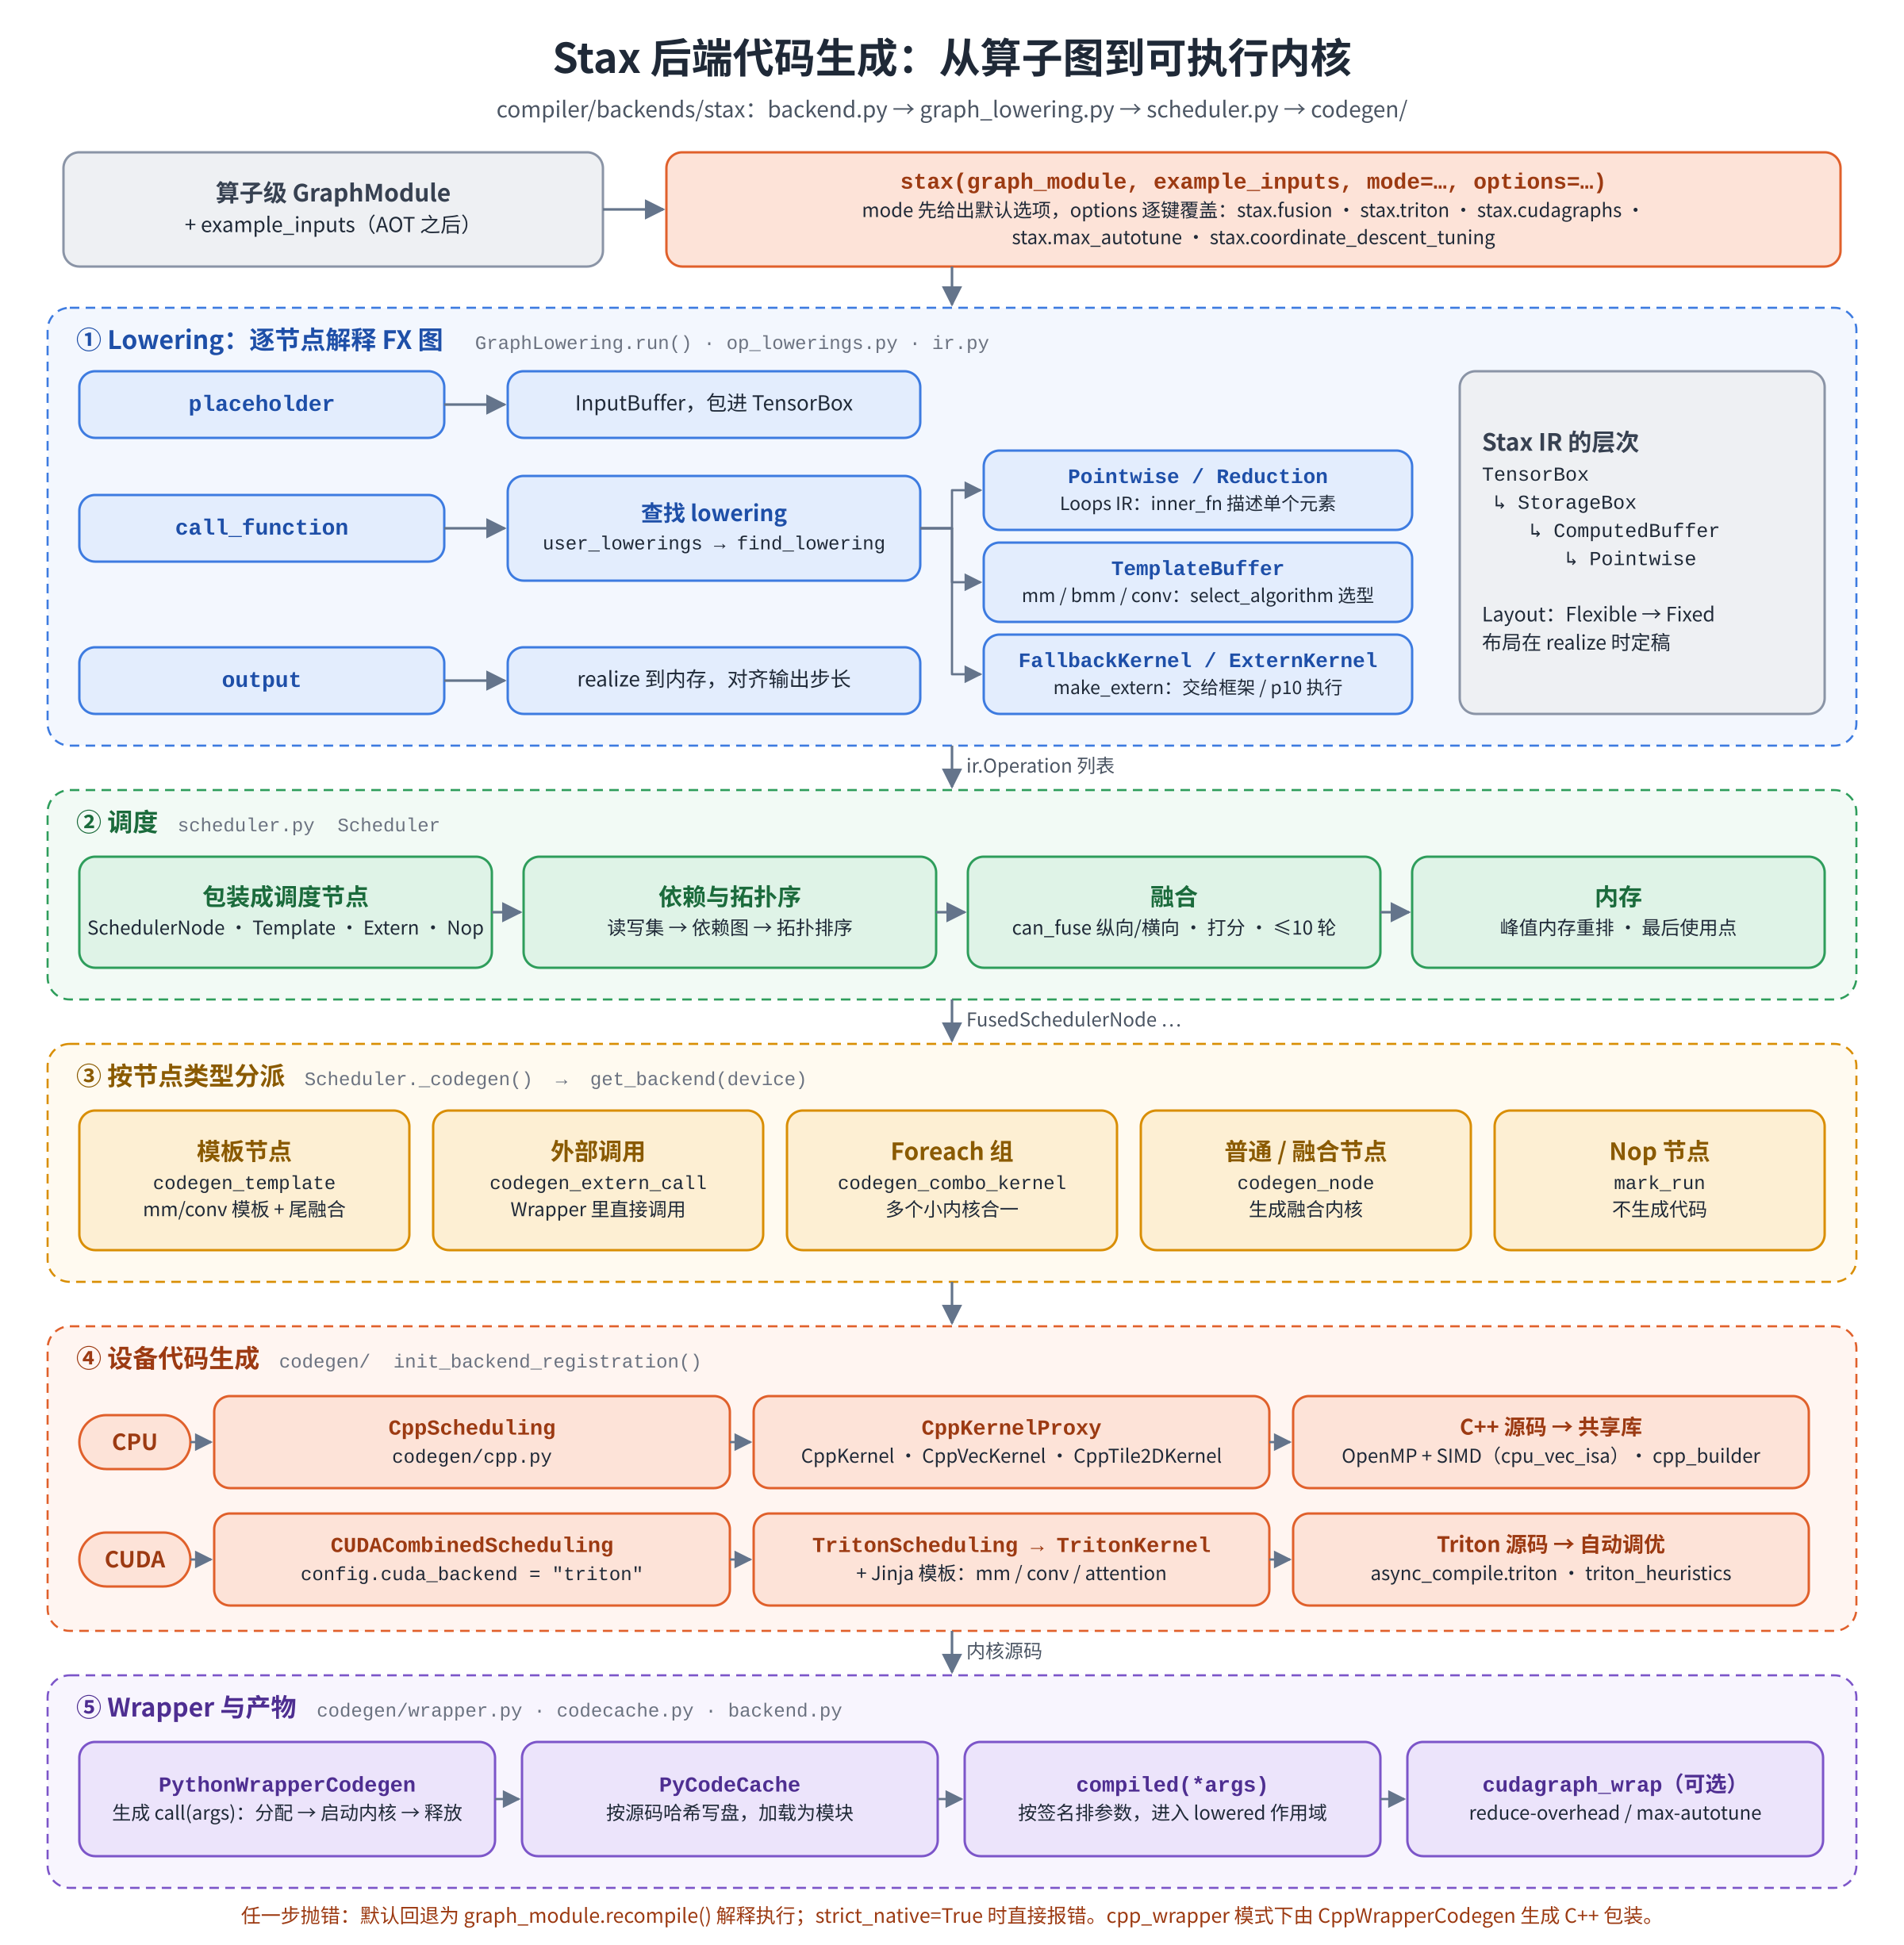
图 11.1 Stax 后端的流程:降级为循环级中间表示,调度与融合,按节点类型分派,生成 CPU 或 GPU 内核,最后生成包装函数并存入代码缓存。图底注明了失败时的回退规则。
首次调用 cf(x, w)(例 1.1,推理,CPU)依次经过以下步骤:
- 分派器的第一级入口尚未建立,计算特化键 $K$,特化缓存未命中(2.2、2.4 节);
- 提升自由张量(本例没有),以执行期代理追踪函数,得到代码清单 3.1 的图;抽取守卫回放子图,本例没有数据门,子图为空(第 3 节);
- 规范化、常量折叠、分解、公共子表达式消除、死代码消除与逐元素区域标注依次执行至不动点(第 4 节);
- 区域在分派器层重新追踪,得到代码清单 5.1 的算子级图;推理区域没有反向部分(5.1 节);
- 降级:四个算子的计算函数逐层复合,成为一个规约节点(代码清单 6.2,性质 6.1);
- 调度:只有一个节点,无融合可做;只分配一个 64 元素的输出,与命题 1.1 的下界一致(第 7 节);
- 代码生成:生成代码清单 1.1 的 C++ 内核与代码清单 8.1 的包装函数,经内容寻址缓存编译与加载(第 8 节,11.1、11.2 节);
- 编译产物登记入特化缓存,并记为第一级入口,执行并返回结果。
此后以同一组张量调用时,路径缩短为:第一级入口核对张量对象与版本号,进入包装函数的 call,检查输入的形状与步长,分配输出,调用内核。
训练的情形(例 5.1)在第 4 步有所不同。AOT 层追踪联合图,以最小割划分出前向图与反向图(5.3 至 5.5 节),前向图经第 5 至第 7 步编译,二者以 autograd.Function 的子类组合(5.6 节)。前向执行时保存 $h$;第一次调用 backward 时,反向图才经第 5 至第 7 步编译,所得内核由 $h$ 重算 erf,并与上游梯度相乘(代码清单 5.3 与 9.3)。在 GPU 上,第 7 步生成的是 Triton 内核(第 9 节);若开启了 CUDA Graphs,第 8 步登记的是 9.9 节所述的包装对象。
12 讨论
12.1 与 PyTorch 2 的比较
Stax 后端的若干类名,如 GraphLowering、Scheduler、CachingAutotuner、TritonKernel,以及 AOT 层的最小割划分器,与 PyTorch 2 [15] 中 TorchInductor 与 AOTAutograd 的对应部分相同,二者在降级、调度与代码生成上的结构基本一致。熟悉其中之一的读者,可以较低的成本阅读另一个。两者的主要差异在前端。
TorchDynamo 在 CPython 的帧求值接口上工作:它在函数执行前截获其字节码,对字节码作符号执行,将张量运算记录为图。遇到无法记录的部分,例如数据相关的分支或无法追踪的外部调用,它进行图中断(graph break):把函数切分为若干段,可捕获的段编译为图,其间的字节码交回解释器执行。它在符号执行中跟踪对 Python 对象的修改(如列表追加、属性赋值),并在图执行之后重放这些修改。
TensorPlay 的前端则在 Python 层以代理对象实际执行函数(第 3 节)。二者的比较如下:
- 数据相关的控制流。TorchDynamo 在该处中断图;TensorPlay 按样例数据选择分支并记为数据门,以守卫回放子图在每次调用时确认分支(3.4、3.5 节)。前者得到若干较小的图,后者得到一个按数据特化的完整的图;
- 捕获失败。TorchDynamo 以图中断容忍失败;TensorPlay 的捕获失败直接报错(11.3 节),区域要么整体被编译,要么不被编译;
- Python 副作用。TorchDynamo 在图外重放可识别的副作用;TensorPlay 的追踪执行一次函数,纯 Python 的副作用(如打印日志、向列表追加元素)只在捕获时发生一次,此后的调用直接执行编译产物,不再发生;
- 特化的粒度。二者都按形状、数据类型等元数据特化,也都按值特化 Python 标量。TensorPlay 另按数据门特化,特化程度更高,缓存中的版本可能更多(例 3.2)。形状方面,TorchDynamo 在同一维度先后出现不同大小时自动把它改为符号,TensorPlay 的
compile只提供整体的开关:dynamic=True时一开始就把所有大小不为 0 或 1 的维度视为符号,以守卫区分不同的分支与布局(10.4 节); - 守卫的构造。TensorPlay 的守卫是特化键的投影(2.3 节),每次未命中都能在守卫链中找到对应的条件。此外,TensorPlay 在守卫之前另设了一级按对象身份与版本号判定的 C 层路径(2.4 节),对以同一组缓冲区反复调用的场景开销最低。
12.2 与基于抽象值追踪的系统的比较
JAX [27] 同样以追踪构造计算图,但追踪时传入的是只携带形状与数据类型的抽象值。抽象值没有具体数据,Python 的 if 作用于追踪值时直接报错,数据相关的控制流须改写为 lax.cond、lax.while_loop 等结构化的控制流原语,由编译器在图内表示各个分支。TensorPlay 的执行期采样处于纯符号追踪与即时执行之间:追踪时同时持有符号与样例值,if 可以按样例值求值,代价是编译结果只对与样例走同一分支的输入有效,须以数据门守卫。
JAX 的 jit 按参数的抽象签名缓存编译结果,并允许以 static_argnums 将指定参数按值特化;TensorPlay 默认按值特化全部 Python 标量(2.2 节),需要避免时将其包装为 0 维张量。两种默认各有取舍:按值特化使标量常量可以在编译时参与折叠与化简,但标量频繁变化时将导致反复编译。
torch.fx [5] 的 symbolic_trace 是纯符号的代理追踪,与 TensorPlay 的追踪器在 execute=False 时的行为相同(3.4 节)。TensorPlay 的图表示,包括表 3.1 的六种操作码、GraphModule 及其生成的 Python 源码,也与 torch.fx 一致。
12.3 与算法调度分离的编译器的比较
Halide [16] 提出将算法(每个值如何由其他值计算)与调度(计算的次序、分块、并行化与存储位置)分开描述。算法部分将每个阶段写为从坐标到值的函数,这与 Stax 循环级中间表示中的 $\mathit{inner_fn}$(定义 6.1)是同一种表示。二者的区别在于调度由谁给出。Halide 的调度由程序员显式书写,或由自动调度器搜索;TVM [28] 沿用了这一分离,并以基于代价模型的搜索为算子寻找调度。Stax 不提供调度语言,调度决策由一组固定的启发式规则作出:是否实体化(6.6 节)、是否拆分规约(6.5 节)、如何融合(7.3 节)、如何分块与并行(第 8、9 节),只有 GPU 的启动配置经过实测选择(9.6 节)。这一做法的编译时间短,也不需要离线搜索,代价是在启发式规则未覆盖的情形下,性能可能低于搜索所能达到的水平。
同一思想有两个值得一提的发展。Tiramisu [51] 把算法与调度的分离放进多面体框架,调度以 7.7 节的仿射变换表示,其合法性由定理 7.2 一类的判据检查;TACO [50] 则面向稀疏张量代数,从张量的存储格式与下标表达式自动生成遍历非零元的循环,这是 Stax 的稠密循环模型没有覆盖的方向。Ansor [49] 在 TVM 的基础上自动生成调度的搜索空间,并以学习的代价模型引导搜索(9.6 节)。
TensorPlay 另提供了一个 TVM 后端,它把捕获图翻译为 TVM 的计算描述,由 TVM 完成调度与代码生成,可以作为两种调度来源的对照。
12.4 与 XLA 和 MLIR 的比较
XLA [35] 是最早被广泛使用的张量编译器之一,也是 JAX 的默认后端。它的输入是 HLO,一种以张量运算为节点、形状全部静态的图表示。与 Stax 相比,有三点值得注意。
第一,融合的单位。XLA 的融合在 HLO 图上进行,把可以合并的运算划入"融合计算”,以若干固定的融合类型(逐元素链的循环融合、以规约或转置为根的输入融合、矩阵乘的尾部融合等)判定合法性,每个融合计算再生成一个内核。Stax 先在循环级中间表示上以函数复合完成逐元素融合(6.3 节),再在调度节点之间按共享字节数贪心合并(第 7 节)。二者面对的是同一个问题,即定义 7.3 的划分问题,采用的都是启发式的近似;差别在于 Stax 的循环级表示使"规约后接广播"这类融合可以直接从下标关系判定(命题 7.2、7.3),而不必逐类列举。
第二,形状。HLO 要求静态形状,动态维度只以"有上界的形状"的形式出现:按上界分配,运行时携带实际大小。这与命题 10.3 的分桶是同一思路的极限情形,即只有一个桶。Stax 的符号形状(第 10 节)走的是另一条路:以守卫划分形状类,每类生成形状多态的代码。
第三,布局。XLA 有专门的布局分配阶段,在全图范围内为每个张量选择维度次序,并在需要时插入转置。Stax 只为中间缓冲区选择布局(6.4 节的灵活布局),输入与输出的布局由调用方决定。
MLIR [36] 不是一个编译器,而是构建编译器的框架。它的核心概念是方言:每种方言定义一组运算与类型,代表某一抽象层次,例如 linalg 表示结构化的张量运算,affine 表示仿射循环与下标,scf 表示一般的结构化控制流,gpu 与 nvvm 表示设备代码。编译即是方言之间的逐级降级,每一级可以复用框架提供的分析与变换,例如 affine 方言上的依赖分析与多面体变换(7.2 节)。
把表 1.2 与 MLIR 对照:Stax 的五层表示大致对应 MLIR 中"图方言 → linalg → 循环方言 → 设备方言"的降级链。区别在于,Stax 的各层是各自独立实现的 Python 数据结构,层与层之间的接口是约定而不是类型系统;MLIR 的各层共用同一套中间表示的基础设施,一个变换写一次即可作用于所有满足其接口的方言。前者的好处是简单、可以直接在 Python 中调试,这也是 TensorPlay 作为学习用框架的取舍;后者的好处是可组合,代价是更陡的学习曲线与更长的编译器构建时间。Triton 本身就构建在 MLIR 之上,因此 Stax 生成的 GPU 内核最终也经过 MLIR 的降级链。
12.5 设计要点
综合各节,Stax 编译栈有以下几条贯穿始终的设计:
- 即时编译是程序特化,守卫是特化键的投影。键与守卫出自同一份数据,二者的一致性由构造保证,而非由测试保证(2.1、2.3 节);
- 数据相关的控制流以特化处理,条件以反向切片抽取,并且必须先于死代码消除抽取(3.5 节);
- 图变换中的代数化简逐条对照 IEEE 754 语义:会改变 NaN、无穷或舍入结果的恒等式(如 $x \cdot 0 \Rightarrow 0$、重结合)一律不用,只在零的符号上不同的 $x + 0 \Rightarrow x$ 是唯一被接受的非精确改写;改写系统以良基度量保证终止(4.1、4.2 节);
- 推理与训练使用同一种算子级的图,保存与重算的取舍化为最小割问题(第 5 节);
- 值默认表示为函数,只有代价模型要求时才写入内存(6.3、6.6 节)。融合因此是默认行为,而不是需要逐对证明的例外;
- 规约的拆分、向量化与在线 softmax 都以幺半群的结合律为依据(6.5、8.1、9.5 节);
- 编译路径上的启发式决策(融合、实体化、并行深度、启动配置)都对应一个一般为 NP 难或只能黑盒求值的优化问题,Stax 以贪心或局部搜索给出近似解(7.2、9.6 节);
- 语义保持是第一位的承诺,回退保证它,严格模式把性能也变为可检验的契约(11.3 节);
- 模型先于测量,测量检验模型。每个优化都先以访存字节、误差界或代价的阶给出预测,再以实测对照;加速比须分解为结构因子与效率因子,不一致之处须归因(第 13 节)。
13 模型与测量
前面各节的结论大多来自模型:访存量的计数、屋顶线、误差界、代价的渐近阶。模型给出的是可以被否证的预言,测量的作用是检验它们。本节先建立测量本身的统计模型(13.1 节),再依次检验融合收益的访存模型(13.2 节)、求和的舍入误差模型(13.3 节)与编译开销的摊销模型(13.4 节),最后讨论这些检验在什么意义上有效(13.5 节)。
13.1 测量的统计模型
**实验设置。**硬件为一台云上的 4 核 Intel Xeon(2.8 GHz,AVX-512,每核 32 KB L1d、1 MB L2,共享 33 MB L3),软件为 TensorPlay 开发分支的 CPU 构建,Python 3.13,4 个线程。每个用例先预热 3 次,再计时 15 次,取中位数。编译版本一律使用 strict_native=True,保证测得的是 Stax 生成的内核而不是回退。全部用例在不同时段完整地测量了两轮,记为 A 与 B。
计时的读数受其他进程、中断、频率调节与缓存状态的干扰。干扰只会使一次执行变慢,不会使它变快,由此得到下面的模型。
定义 13.1(加性非负噪声) 一次计时的读数为 $T = t_0 + \varepsilon$,其中 $t_0$ 是无干扰时的耗时,$\varepsilon \ge 0$ 是干扰引入的延迟。各次读数的 $\varepsilon$ 独立同分布,且对任意 $\delta > 0$ 有 $\Pr[\varepsilon < \delta] > 0$。
命题 13.1 在定义 13.1 下,$n$ 次读数的最小值 $T_{(1)}$ 是 $t_0$ 的相合估计,且 $\Pr[T_{(1)} - t_0 \ge \delta] = \Pr[\varepsilon \ge \delta]^n$。
证明 $T_{(1)} - t_0 \ge \delta$ 当且仅当每次读数的 $\varepsilon \ge \delta$,由独立性得等式。由假设 $\Pr[\varepsilon \ge \delta] < 1$,右端随 $n \to \infty$ 趋于 0。$\square$
最小值估计的是"机器能做到什么",适合用来估计带宽、算力这类能力参数;中位数描述"通常会发生什么",对少数受到严重干扰的读数不敏感,适合比较两种执行方式的典型耗时。中位数还有一个不依赖分布的区间估计。
命题 13.2(中位数的无分布置信区间) 设 $X_1, \dots, X_n$ 独立同分布于中位数为 $m$ 的连续分布,$X_{(1)} \le \dots \le X_{(n)}$ 为次序统计量。对 $1 \le j < k \le n$,
$$\Pr\bigl[X_{(j)} \le m < X_{(k)}\bigr] = \sum_{i=j}^{k-1} \binom{n}{i} 2^{-n}.$$
证明 令 $K$ 为小于等于 $m$ 的读数个数。每个读数以概率 $1/2$ 不超过 $m$,故 $K \sim \mathrm{Binomial}(n, 1/2)$。$X_{(j)} \le m$ 当且仅当 $K \ge j$,$m < X_{(k)}$ 当且仅当 $K \le k - 1$,于是所求概率为 $\Pr[j \le K \le k-1]$。$\square$
取 $n = 15$、$j = 4$、$k = 12$,覆盖概率为 $96.5%$:第 4 小与第 12 小的读数构成中位数的 95% 置信区间,与读数服从何种分布无关。命题 13.2 要求各次读数独立同分布,而这一假定在不同时段之间并不成立:机器的负载随时间变化,两轮测量的中位数之差往往超出单轮的置信区间。本节因此只在同一轮之内比较两种执行方式,并把两轮的结果都列出来,以两轮之间的差别作为系统误差的量级。
**机器参数。**读带宽 $B$ 以按行求和一个 64 MiB 张量来测量。两轮测量与另外三次重复共得 7 个中位数,从 1.36 ms 到 3.18 ms 不等,差了一倍多。按命题 13.1,能力参数取最小值,$B \approx 49.4$ GB/s;算力 $P$ 取 2048 阶 float32 矩阵乘的最好结果,约 392 GFLOP/s。脊点 $P/B \approx 7.9$ FLOP/byte,本节的逐元素与规约用例的算术强度都在 1 以下,位于屋顶线的斜线段上(图 1.1 左)。以 copy_ 测得的速率只有 18.4 GB/s(按读写各一次计):写入一个不在缓存中的行时,处理器要先把它读进来(写分配),实际流量多于计数。以字节计数的模型因此普遍低估写入的代价。
13.2 融合收益的分解
1.1 节以访存字节预测融合的收益。下面的命题说明这一预测在什么意义上精确,又遗漏了什么。
定义 13.2(模型字节比与有效带宽) 设即时执行与编译执行按 1.1 节方法计数的主存字节数分别为 $b_e$、$b_c$,实测耗时为 $T_e$、$T_c$。称 $\rho = b_e / b_c$ 为模型字节比,称 $\beta_e = b_e / T_e$、$\beta_c = b_c / T_c$ 为两种执行方式的有效带宽。
命题 13.3(加速比的分解) 加速比 $S = T_e / T_c$ 满足
$$S = \rho \cdot \frac{\beta_c}{\beta_e}.$$特别地,若两种执行方式达到带宽上限的同一比例,则 $S = \rho$;$S > \rho$ 当且仅当编译后的内核比即时执行的内核更接近带宽上限。
证明 $S = \dfrac{b_e / \beta_e}{b_c / \beta_c} = \dfrac{b_e}{b_c} \cdot \dfrac{\beta_c}{\beta_e}$。$\square$
命题 13.3 是一个恒等式,它的价值在于把加速比拆成两个性质不同的因子。$\rho$ 由图的结构决定,是融合与实体化的决策(第 6、7 节)带来的收益,在编译之前即可算出,并且由命题 1.1 有上界;$\beta_c / \beta_e$ 是内核质量之比,取决于向量化、并行划分与访存模式(第 8 节),字节模型对它不作任何断言。一个优化声称的加速比,应当说明其中多少来自 $\rho$,多少来自 $\beta_c / \beta_e$。
表 13.1 列出六个用例。输入为 $8192 \times 2048$ 的 float32 张量(64 MiB,远大于 L3),softmax 一行用 $16384 \times 1000$。每格的两个数分别来自 A、B 两轮。
表 13.1 即时执行与编译执行的耗时与有效带宽(CPU,4 线程,中位数,A / B 两轮)
| 用例 | $\rho$ | 即时(ms) | 编译(ms) | $S$ | $\beta_e$(GB/s) | $\beta_c$(GB/s) |
|---|---|---|---|---|---|---|
例 1.1:(relu(x + w) * 2).sum(-1) | 4.00 | 16.6 / 15.6 | 3.38 / 3.94 | 4.91 / 3.95 | 32.3 / 34.4 | 39.7 / 34.0 |
例 7.1:x / x.sum(-1, keepdim=True) | 1.50 | 5.80 / 5.90 | 4.65 / 4.97 | 1.25 / 1.19 | 34.7 / 34.1 | 28.9 / 27.0 |
| softmax(五个算子手写,9.5 节) | 4.00 | 23.8 / 17.7 | 7.68 / 7.85 | 3.09 / 2.26 | 22.1 / 29.6 | 17.1 / 16.7 |
softmax(库算子 F.softmax) | 1.00 | 7.94 / 7.85 | 9.82 / 9.46 | 0.81 / 0.83 | 16.5 / 16.7 | 13.4 / 13.9 |
例 7.2:exp 后接 sum 与 amax | 2.00 | 14.0 / 14.6 | 7.34 / 8.53 | 1.90 / 1.72 | 28.8 / 27.5 | 27.5 / 23.6 |
| LayerNorm → GELU → 乘 0.5 | — | 16.0 / 17.6 | 10.7 / 11.1 | 1.50 / 1.58 | — | — |
例 7.2 的 $\rho$ 按 CPU 上的实体化决策计算(6.6 节):即时执行两次计算 exp,各读写一遍,再各被一个规约读一遍,共 $6N$ 个元素;编译后 exp 只算一次并写入缓冲区,两个规约融合为一趟读取,共 $3N$。
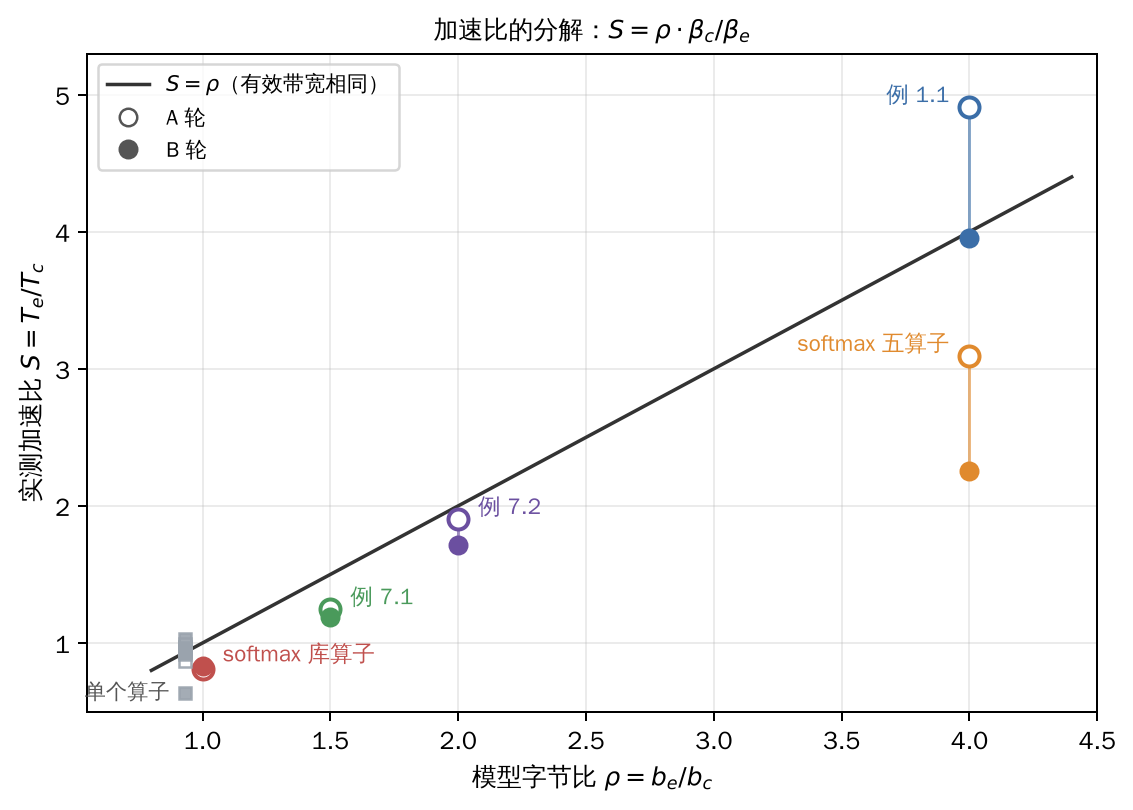
图 13.1 实测加速比 $S$ 与模型字节比 $\rho$。实线为 $S = \rho$,即两种执行方式的有效带宽相同;点在实线下方,说明编译后的内核离带宽上限更远。空心与实心分别为 A、B 两轮;$\rho = 1$ 处的点为表 13.1 中的库 softmax 与表 13.2 的五个单算子(方块,稍向左平移以免重叠)。
**结构因子决定量级。**在图 13.1 中,$\rho$ 从 1 到 4 变化时,$S$ 从约 0.8 增至约 4,二者大体沿 $S = \rho$ 分布。字节模型预测了加速比的量级与次序,这正是 1.1 节所需要的:判断一个融合值不值得做,要看能省下多少字节。
**效率因子决定偏差。**例 1.1 在 A 轮得到 $S = 4.91 > \rho$,原因是融合内核的有效带宽达到 $B$ 的 80%,而即时执行的两个逐元素内核只有 65%;B 轮二者都在 70% 左右,$S = 3.95 \approx \rho$。五算子 softmax 的 $\rho$ 同为 4,$S$ 却只有 3.09 与 2.26,原因在因子 $\beta_c / \beta_e$:融合内核只达到 $B$ 的 35%。它对每行先求最大值、再求指数和、最后做除法,三趟之间有数据依赖,一行之内无法流水;行长 1000 不是向量宽度 16 的倍数,每行末尾都有一段带掩码的尾部。这些都是第 8 节讨论的内核质量问题,字节模型没有计入。库 softmax 的 $\rho = 1$,编译器无法减少字节,$S$ 只剩下效率因子,而编译后的内核略慢于手写的库内核,于是 $S \approx 0.82$。
表 13.2 给出 $\rho = 1$ 的另一组例子:单个算子没有可消除的中间张量。
表 13.2 单个算子的耗时($8192 \times 2048$,ms,A / B 两轮)
| 算子 | 即时执行 | 编译 | $S$ |
|---|---|---|---|
exp | 4.66 / 4.54 | 4.81 / 4.71 | 0.97 / 0.96 |
x + 1 | 3.79 / 3.90 | 4.04 / 4.18 | 0.94 / 0.93 |
relu | 4.12 / 3.91 | 4.24 / 4.24 | 0.97 / 0.92 |
按行 sum | 3.15 / 1.36 | 3.18 / 2.14 | 0.99 / 0.63 |
按行 amax | 2.03 / 3.23 | 2.34 / 3.15 | 0.87 / 1.03 |
十个比值中有八个落在 0.87 至 1.03 之间:$\rho = 1$ 时编译不提供收益,生成的单个内核与库内核质量相近,略慢几个百分点。按行 sum 在两轮之间相差一倍以上(3.15 ms 与 1.36 ms),而同一时段内的 amax 访存量相同、耗时却反向变化,这正是 13.1 节所说的时段间系统误差,单轮的中位数掩盖不了它。
13.3 舍入误差的统计模型
6.5 节给出了求和的最坏情形误差界。对例 1.1,每行是 2048 个服从同一分布的非负数之和,行和约为 2300。顺序求和的界为 $(n-1) u \sum |a_i| \approx 0.28$,16 路分段求和约为 $0.020$,树形求和约为 $1.5 \times 10^{-3}$,而两轮测得编译结果与即时执行结果之差的最大值都是 $4.9 \times 10^{-4}$。最坏情形的界要求每一次舍入都取到最大值且符号相同,实际的舍入误差有正有负,会相互抵消。下面的模型刻画典型情形 [18]。
定理 13.1(求和误差的统计模型) 设 $\hat s_1 = a_1$,$\hat s_k = (\hat s_{k-1} + a_k)(1 + \delta_k)$,$k = 2, \dots, n$,其中各 $\delta_k$ 相互独立且与数据独立,$\mathbb E[\delta_k] = 0$,$\mathrm{Var}[\delta_k] = \sigma_\delta^2 \le u^2$。记部分和 $s_k = \sum_{i \le k} a_i$,则一阶近似下的误差 $E = \hat s_n - s_n$ 满足
$$E \approx \sum_{k=2}^{n} \delta_k s_k, \qquad \mathbb E[E] = 0, \qquad \mathrm{Var}[E] = \sigma_\delta^2 \sum_{k=2}^{n} s_k^2.$$若舍入误差在 $[-u, u]$ 上均匀分布,则 $\sigma_\delta^2 = u^2/3$。
证明 对 $n$ 归纳可得 $\hat s_n = \sum_{i} a_i \prod_{k = \max(i,2)}^{n} (1 + \delta_k)$。展开乘积并略去 $\delta$ 的二次及以上的项,得 $\hat s_n - s_n \approx \sum_{k=2}^{n} \delta_k \sum_{i \le k} a_i = \sum_{k=2}^{n} \delta_k s_k$。期望为零与方差公式由 $\delta_k$ 的独立性与零均值得出;均匀分布的方差为 $u^2/3$。$\square$
推论 13.1 设 $a_i$ 独立同分布,均值为 $\mu$、方差为 $\sigma^2$,求和分为 $W$ 路($W$ 为 2 的幂),每路顺序累加 $n/W$ 个数,最后以树形合并 $W$ 个部分和。则
$$\mathrm{Var}[E] \approx \frac{u^2}{3}\Bigl(\underbrace{\frac{n^3 \mu^2}{3 W^2} + \frac{n^2 \sigma^2}{2 W}}_{\text{各路累加}} + \underbrace{2 n^2 \mu^2 + n \sigma^2 \log_2 W}_{\text{树形合并}}\Bigr).$$均值非零且 $n \gg W^2$ 时,误差的标准差按 $n^{3/2}$ 增长;均值为零时按 $n$ 增长。
证明 每一路的第 $k$ 个部分和满足 $\mathbb E[s_k^2] = k^2 \mu^2 + k \sigma^2$。对 $k = 1, \dots, n/W$ 求和得 $\frac{(n/W)^3}{3} \mu^2 + \frac{(n/W)^2}{2} \sigma^2$(保留最高阶),乘以路数 $W$ 得第一部分。树形合并的第 $\ell$ 层($\ell = 1, \dots, \log_2 W$)有 $W/2^\ell$ 次加法,每次的结果是 $2^\ell n/W$ 个数之和,其二阶矩为 $(2^\ell n \mu / W)^2 + 2^\ell n \sigma^2 / W$;逐层求和得 $\frac{n^2\mu^2}{W}(2W - 2) + n\sigma^2\log_2 W \approx 2n^2\mu^2 + n\sigma^2 \log_2 W$。两部分代入定理 13.1 即得。$\square$
合并项能否忽略取决于 $n$ 与 $W$ 的关系:均值非零时它与主项之比约为 $6W^2/n$,只有 $n \gg W^2$ 时才是低阶项;均值为零时比值约为 $2W\log_2 W / n$,通常可以忽略。
把推论 13.1 用于两个用例,取 $u = 2^{-24}$,$W = 16$(AVX-512 的 float32 通道数)。
例 1.1:$a_i = 2,\mathrm{relu}(z)$,$z \sim \mathcal N(0, 2)$,$\mu = 2\sqrt{2}/\sqrt{2\pi} \approx 1.13$。此时 $6W^2/n \approx 0.75$,合并项不能忽略,两部分合计,每行误差的标准差约为 $1.7 \times 10^{-4}$。假定编译结果与即时执行结果各有独立、同分布的误差(二者都按 16 路累加),二者之差的标准差再乘以 $\sqrt 2$,约为 $2.4 \times 10^{-4}$;8192 行中的最大值约为 3.9 个标准差,即 $9.5 \times 10^{-4}$。实测为 $4.9 \times 10^{-4}$,恰为行和量级($2^{11}$ 至 $2^{12}$)上 float32 相邻数间距的 2 倍:误差本身是量化的。预测与实测同一量级,预测偏大约 2 倍,与下面例 7.1 的情形一致。
例 7.1:$a_i \sim \mathcal N(0, 1)$,$\mu = 0$,行和误差的标准差约为 $u n / \sqrt{6W} \approx 1.25 \times 10^{-5}$。归一化把行和中的误差直接传给每个输出,相对误差约为 $|E| / |s|$,在行和绝对值最小的一行达到最大。两轮的最小行和分别为 0.0152 与 0.0050,预测的最大相对误差(含 $\sqrt 2$)为 $1.2 \times 10^{-3}$ 与 $3.5 \times 10^{-3}$,实测为 $6.3 \times 10^{-4}$ 与 $1.4 \times 10^{-3}$。量级与随最小行和变化的方向都与预测一致;实测约小 2 倍,与内核把规约循环展开为多组向量累加器(等效的 $W$ 大于 16)相符,因为标准差正比于 $1/\sqrt W$。
例 7.1 也说明了条件数的作用。归一化的相对条件数为 $\kappa = \sum|x_i| / |\sum x_i|$,B 轮的最坏一行约为 $3 \times 10^5$。表 13.1 所用的另一组随机输入上,最大绝对误差在 A、B 两轮分别为 0.16 与 2.9,看似是错误,实则是病态输入对正常舍入误差的放大。11.4 节说"一致"的判定须留有容差,这里是一个具体的例子:容差必须相对于问题的条件数来定,固定的绝对容差会把病态的输入误判为编译错误。
其余用例的误差在 $10^{-6}$ 以下。训练用例(例 5.1,$x \in \mathbb R^{4096\times1024}$、$W \in \mathbb R^{1024\times1024}$)中,编译与即时执行的梯度相对误差为 $1.8 \times 10^{-7}$,约为 $3u$。
13.4 编译开销的摊销
设编译一个特化版本的一次性代价为 $C$,此后每次调用的耗时为 $t_c$,即时执行为 $t_e$。
命题 13.4(盈亏平衡点) 若 $t_e > t_c$,则调用 $m$ 次之后编译的总耗时不超过即时执行,当且仅当
$$m \ge m^* = \frac{C}{t_e - t_c}.$$
证明 $C + m t_c \le m t_e$ 移项即得。$\square$
例 1.1 在 $8192 \times 2048$ 上冷编译的首次调用为 5.6 至 5.9 s,每次调用节省 11.6 至 13.2 ms,$m^* \approx 420$ 至 $510$。$C$ 可以再分解:在发布版 1.1.0 上,以 $64 \times 128$ 的输入在新进程中冷编译例 1.1 需 5.2 至 5.5 s;以同一个缓存目录再启动新进程,首次调用降为约 1.2 s。差额约 4 s 是外部 C++ 编译器的时间,被 11.1 节的内容寻址缓存省去;剩下的约 1.2 s 是捕获、图变换、降级、调度与代码生成,每个新进程都要重做。缓存命中时,$m^*$ 降为约 100。
命题 13.4 针对单个特化版本。一个工作负载若产生 $K$ 个不同的特化键,总的一次性代价为 $KC$,$K$ 的大小由第 2 节与第 10 节的特化策略决定。
命题 13.5(特化版本数的期望) 设各次调用的形状独立地取自分布 $p$,即形状 $s$ 的概率为 $p_s$。按具体形状特化时,$m$ 次调用产生的特化版本数 $K_m$ 满足
$$\mathbb E[K_m] = \sum_s \bigl(1 - (1 - p_s)^m\bigr).$$若改为按命题 10.3 以 2 的幂为桶、大小取值于 $[m_0, M_0]$,则对任意 $m$ 都有 $K_m \le \lceil \log_2 M_0 \rceil - \lfloor \log_2 m_0 \rfloor + 1$。
证明 $K_m = \sum_s \mathbf 1[\text{形状 } s \text{ 至少出现一次}]$,由期望的线性性,$\mathbb E[K_m] = \sum_s \Pr[s \text{ 至少出现一次}] = \sum_s (1 - (1 - p_s)^m)$。分桶时每个桶至多产生一个版本,由命题 10.3,桶数不超过右端。$\square$
例如序列长度在 1 至 512 之间均匀分布时,按具体形状特化,1000 次调用后的版本数期望约为 $512(1 - (511/512)^{1000}) \approx 440$,摊销几乎不可能;分桶后至多 10 个版本;动态形状(第 10 节)在守卫不失败时只有一个版本。
调用开销。$C$ 以秒计,每次调用的固定开销则以微秒计。对 8 个元素的 x * 2 + 1,即时执行(两个算子)每次 3.6 μs;编译版本以同一个张量反复调用时为 12.0 至 12.7 μs,走 2.4 节的第一级入口,只核对对象身份与版本号;每次传入新张量时为 22.0 至 22.6 μs,须计算签名并查找特化缓存。
命题 13.6(融合的最小规模) 设一条由 $k$ 个逐元素算子组成的链作用于 $N$ 个 float32 元素,每个算子读一个张量、写一个张量。即时执行每个算子的固定开销为 $\tau_e$,编译后每次调用的固定开销为 $\tau_c$,两种执行方式的有效带宽同为 $\beta$。则编译执行更快,当且仅当
$$N > N^* = \frac{(\tau_c - k \tau_e)\,\beta}{8 (k - 1)}.$$
证明 即时执行耗时 $k\tau_e + 8kN/\beta$,编译执行耗时 $\tau_c + 8N/\beta$。二者之差为 $8(k-1)N/\beta - (\tau_c - k\tau_e)$,移项即得。$\square$
取 $k = 2$、$\tau_e = 1.8$ μs、$\beta = B$:同一张量反复调用时 $N^* \approx 5 \times 10^4$,每次传入新张量时 $N^* \approx 1.1 \times 10^5$,即数百 KB。小张量常驻缓存,实际带宽高于 $B$,$N^*$ 只会更大。编译器因此适用于计算量远大于调用开销的区域;对于由大量小算子组成的程序,应当把它们放进同一个编译区域,使 $k$ 增大而 $\tau_c$ 只付一次。
13.5 检验的有效性
一次检验能在多大程度上支持一个模型,取决于它的有效性。按实验方法学的惯例,可以分三个方面考察;并行计算中报告性能的常见陷阱与规范见 [37]。
构造有效性问的是测到的量是否就是模型所说的量。字节模型的 $b$ 是主存流量,而一个内核的实际流量还包含写分配(13.1 节)与缓存未命中的重读;用例的输入远大于 L3,正是为了让主存流量占主导。strict_native=True 保证测得的是生成的内核,而不是回退到即时执行的结果。
内部有效性问的是观察到的差别是否确由所研究的因素引起。同一轮内两种执行方式紧接着先后计时,减小了时段间漂移的影响,但没有完全排除它;交替计时(每次读数在两种方式之间轮换)是更好的设计;但两轮之间的差别(表 13.1、表 13.2)说明单轮的中位数不足以支撑 10% 量级的结论。只有在两轮中方向一致、且远大于两轮之差的效应,例如 $\rho = 4$ 与 $\rho = 1$ 之间的差别,才可以视为确立。
外部有效性问的是结论能否推广。数据只来自一台共享的云主机,没有固定处理器频率;只有 CPU,第 9 节关于 GPU 的结论没有经过测量;用例都是单个小函数,没有覆盖完整的模型。训练用例两种执行方式每步都在 650 至 730 ms 之间,远超两次矩阵乘与 GELU 的前向、反向内核之和(不到 80 ms),耗时由自动微分引擎的固定开销主导,不在字节模型的适用范围内,本节因此不对它报告加速比。
在这些限制之内,测量支持本章的三个模型:融合的收益由模型字节比决定量级,偏差由有效带宽之比解释(命题 13.3);舍入误差远小于最坏情形的界,其量级与随条件数变化的方向都由统计模型给出(推论 13.1);编译的一次性代价以秒计、调用开销以微秒计,二者通过命题 13.4 与命题 13.6 决定编译适用的场合。
本章小结
本章以 TensorPlay 的 Stax 编译栈为对象,讨论了把张量程序编译为高效内核的各个环节,以及支撑每个环节的理论。
即时编译是程序特化。以样例输入追踪函数,得到的图只对特化键相同的输入有效(命题 2.1);特化键由签名、形状与数据门三部分构成,守卫是它的投影,因而每次重编译都能给出不成立的条件(推论 2.1)。数据相关的控制流同样以特化处理:分支条件依赖的计算以反向切片抽取为守卫回放子图,抽取必须先于死代码消除(命题 3.1、推论 3.1)。
图变换是一个改写系统,以良基度量保证终止(命题 4.1)。浮点数不满足实数的代数律,代数化简须逐条对照 IEEE 754 语义:会改变 NaN、无穷或舍入结果的恒等式不用,只改变零的符号的 $x + 0 \Rightarrow x$ 是唯一被接受的例外。公共子表达式消除是值编号,死代码消除是逆向可达性,二者都可以在线性时间内完成。算子级分解只展开不属于后端基的算子,其终止性同样来自一个良基的深度(命题 4.3);函数化以散射逆消除原地修改与视图别名,使图成为纯函数(命题 4.4),调度阶段的原地复用再把存储收回。
训练区域经反向模式自动微分得到联合图,其代价不超过前向的常数倍(定理 5.1,常数对常用的初等函数不超过 5)。在前向保存哪些值、在反向重算哪些值,可以化为重物化网络上的最小割(命题 5.1),由最大流最小割定理以多项式时间求解;存储受限时,二项式检查点以对数级的存储与重算倍数反演一条链(定理 5.4)。前向模式以对偶数传播切向量,适用于输出多、输入少的情形;编译路径目前只支持一阶反向,二阶求导会明确报错(5.7 节)。
降级把每个值表示为从下标到值的函数,逐元素运算的融合即函数复合(性质 6.1);视图是下标空间上的仿射变换(命题 6.2);规约的拆分与并行化以幺半群的结合律为依据,浮点情形下的代价是不同的舍入误差界。核心语言的指称语义把这些说法变成了定理:内联与实体化、公共子表达式消除逐位保持语义(定理 6.1、6.2),规约的重排只保持实数语义(定理 6.3)。是否把一个值写入内存,由重算代价与访存代价的比较决定。循环体经过规范化,相邻循环在满足步长条件时合并(命题 6.3);区间域上的值域分析是可靠的(命题 6.4),据此省去可以证明多余的越界检查,并选择 32 位下标。
调度在依赖图上寻找融合方案。融合以迭代空间的兼容为前提(定义 7.2),纵向融合的正确性由读写下标的一致保证(命题 7.2)。最优融合是 NP 难的(定理 7.1),Stax 采用以共享字节数为首要收益的贪心算法,并以命题 7.1 维持无环性。多重循环的交换、偏斜与分块的合法性由距离向量判定(定理 7.2、7.3),一维仿射调度的存在性可由 Farkas 引理化为线性规划(命题 7.5)。缓冲区的复用是区间图上的存储分配问题,使峰值内存最小的拓扑序则是 NP 完全的(命题 7.4,由路径宽度归约),Stax 在若干启发式次序中择优。
代码生成把同一份循环级描述打印为 CPU 或 GPU 上的程序。CPU 上,向量化的合法性来自迭代的独立性或规约的结合律(命题 8.1),分块使缓存行被完整利用,并行深度的选择兼顾负载均衡与固定开销。GPU 上,利特尔法则给出了掩盖访存延迟所需的并发度;softmax 的单趟形式依赖于 $(m, d)$ 二元组上的幺半群(命题 9.1);启动配置的选择是黑盒优化,坐标下降给出局部最优(命题 9.2),随机搜索给出分位数保证(命题 9.3);矩阵乘的分块在渐近意义下达到由 Loomis–Whitney 不等式证明的 I/O 下界(定理 9.1)。
动态形状是对特化键中形状分量的粗化,其可靠性要求编译产物对整个等价类有效(命题 10.1)。符号形状把追踪中对大小的判断记为形状守卫,守卫或被声明的范围蕴含,或成为运行时断言;后端中一切依赖于大小的决策都须对整个范围成立,或被守卫限定。Stax 的 CPU 与 GPU 内核共用同一套符号降级,同一个键下的多个产物以各自的守卫区分,训练时前向与反向产物都可跨尺寸复用。
编译结果的复用是对纯函数的记忆化,内容寻址使缓存无需失效(命题 11.1);并行编译的完成时间由列表调度的界给出(命题 11.2)。贯穿全章的约束是语义保持:每个变换都必须保持程序的语义,回退保证了这一点,严格模式则把性能也变为可检验的契约。
第 9.10 节讨论了注意力:在线 softmax 的三元组使注意力可以像规约一样分块,块掩码把稀疏性提升到块的粒度,score_mod 与 mask_mod 以子图的形式嵌入模板。第 13 节以实测检验了全章的模型:加速比等于模型字节比与有效带宽之比的乘积(命题 13.3),前者决定量级,后者解释偏差;求和误差的统计模型给出了比最坏情形界小两到三个数量级、与实测相符的预测(定理 13.1);编译的盈亏平衡点与融合的最小规模由两个简单的代价模型给出(命题 13.4、13.6)。
本章未涉及自定义算子、分布式训练中的计算与通信重叠,以及卷积模板,读者可结合附录 A 的源码索引自行阅读。
习题
难度标记:★ 直接应用正文的结论;★★ 需要完整的推导或证明;★★★ 开放性问题或研究型问题,可能需要查阅文献。带有提示或解答的习题见附录 C。
★ 设例 1.1 中 $x$、$w$ 的形状为 $n\times128$,数据类型为 float32。(1)分别求即时执行与完全融合执行的访存字节数与算术强度,作为 $n$ 的函数。(2)证明融合执行达到命题 1.1 的下界。(3)若去掉
sum(-1),下界变为多少?融合节省的比例如何变化?★ 对例 2.1 的
g(x, k) = x * k,(1)说明若特化键中不含 $k$ 的值,编译产物在哪些输入上违反命题 2.1 的结论。(2)给出一种改写,使 $k$ 成为动态部分,并说明改写后常量折叠失去了什么。★ 构造一个例子:若守卫与特化键分别维护,键已不同而全部守卫成立,说明此时会发生什么错误。再指出推论 2.1 的证明在哪一步用到了"守卫是键的投影"。
★★ (1)证明算法 3.1 的时间复杂度为 $O(|V| + |E|)$。(2)设例 3.2 的守卫回放子图在死代码消除之后抽取,求第二次调用的结果,并说明这一错误为何不能被 2.3 节的守卫察觉。
★ 设 $x$ 为任意 float32 值(含 $\pm 0$、$\pm\infty$、NaN 与次正规数)。对以下各式判断改写在 IEEE 754 语义下是否精确成立,不成立者给出反例:(1)$x \cdot 1 \Rightarrow x$;(2)$x + 0 \Rightarrow x$;(3)$x - 0 \Rightarrow x$;(4)$x \cdot 0 \Rightarrow 0$;(5)$x - x \Rightarrow 0$;(6)$x / 2 \Rightarrow x \cdot 0.5$;(7)$x / 3 \Rightarrow x \cdot (1/3)$。
★★ 给出一组改写规则,使 4.1 节的不动点迭代不终止,并指出它违反了命题 4.1 的哪一条件。若在规则集中同时加入 $a + b \Rightarrow b + a$ 与常量折叠,应如何选择度量 $\mu$ 才能保证终止?
★★ 设算子级分解表中有规则 $o_1 \Rightarrow o_2 + o_3$、$o_2 \Rightarrow o_1 \cdot c$,且 $o_1, o_2 \notin \mathcal B$。(1)说明命题 4.3 中的深度为何没有定义,递归分解会发生什么。(2)若把 $o_2$ 加入后端的基,深度是否有定义?
★★ 对例 4.4 中的
y[0].add_(1),(1)写出select与select_scatter的定义,验证命题 4.4 的两个条件。(2)若改为y.t()[0].add_(1),函数化后的图应包含哪些节点?(3)说明为什么在函数化之前做公共子表达式消除可能出错。★★ 在例 5.1 中将 gelu 换为 relu,并假定 relu 的反向读取 relu 的输出。(1)按定义 5.2 重新构造重物化网络,求最小割。(2)与表 5.1 比较,保存的值有何不同?前向需要多写出多少字节?
★★ 设前向中的值 $v$ 是一次规约的结果且被反向读取,即 $v \in U \cap B$(5.4 节第 3 种情形)。(1)由定义 5.1 证明 $v$ 属于任意可行保存集。(2)在定义 5.2 的网络中验证同一结论:说明为什么任意有限容量的割都必须割断 $v_{\mathrm{in}} \to v_{\mathrm{out}}$。
★★ (1)设 $x$ 的布局为形状 $(4, 6)$、步长 $(6, 1)$,求
x.t()的布局,并由 6.4 节的条件判断x.t().reshape(24)能否表示为一组步长。(2)证明:对任意布局,先切片再转置与先转置再切片得到的 $(t’, o’)$ 相同。★ 设循环体有三层循环,范围为 $(4, 8, 16)$,两个访存的下标分别为 $128 i_0 + 16 i_1 + i_2$ 与 $i_0 + 4 i_1 + 32 i_2$。按命题 6.3 判断哪些相邻循环可以合并,并说明先重排循环次序能否使合并成为可能。
★★ (1)按定义 6.4 求 $(3i + 5) \bmod 128$ 与 $\lfloor i / 4 \rfloor - 1$($i \in [0, 511]$)的区间,并判断哪一个可以省去越界检查。(2)构造一个下标表达式,使其运行时的取值总在 $[0, 127]$ 中,而区间分析无法证明这一点。这与命题 6.4 矛盾吗?
★★ 设一段元素的个数、均值与二阶中心矩为 $(n, \mu, M_2)$。(1)写出两段的合并运算,证明它满足结合律与交换律 [17]。(2)比较这一合并与"分别求 $\sum x$ 与 $\sum x^2$ 再相减"的数值稳定性,说明后者在 $\mu^2 \gg \mathrm{Var}(x)$ 时为何失效。
★★ 对 9.10 节的三元组 $(m, \ell, \mathbf a)$:(1)详细证明合并运算满足结合律与交换律,并说明单位元是什么。(2)设前向保存了 $\mathrm{LSE}i = m_i + \log \ell_i$,证明反向时 $P{ij} = \exp(S_{ij} - \mathrm{LSE}i)$,并说明为什么只保存 $m_i$ 或只保存 $\ell_i$ 都不够。(3)由 $dP = dO, V^{\mathsf T}$ 与 softmax 的导数,写出 $dS$ 的表达式,说明它只需要 $P$ 的一个块与 $D_i = \sum_j dO{ij} O_{ij}$。
★ 设 $n = 2^{20}$。按 6.5 节,分别求顺序求和、$k = 16$ 的分段求和、$k = 1024$ 的分段求和与树形求和的误差界系数,并说明为什么向量化的累加器个数 $W$ 不宜过小。
★★ (1)对图 $a \to c \to b$、$a \to b$,验证合并 $a$ 与 $b$ 产生环。(2)构造一个依赖图与收益函数,使算法 7.1 的贪心结果的代价严格大于最优融合方案的代价。
★★ 设所有中间缓冲区大小相同。证明:按生存期左端点排序、每次分配编号最小的空闲槽位的贪心算法所用的槽位数等于 $\max_\tau |L(\tau)|$,从而达到定义 7.5 的下界。举例说明缓冲区大小不同时这一结论不成立。
★ 构造两个节点 $a \to b$,使二者迭代空间兼容、共享数据,但 $b$ 读取 $a$ 的输出时下标为 $w(i+1)$。说明按命题 7.2 的次序融合会读到什么值,以及调度器为何拒绝这一融合。
★ 设依赖图由两条链 $a \to c$、$b \to d$ 组成,$a$、$b$ 的输出各占 4 个单位,在其唯一的使用者执行后释放;$c$、$d$ 是图的输出,各占 1 个单位,不释放。枚举全部拓扑序,按定义 7.5 求各自的峰值内存,并说明 7.5 节的最小峰值优先规则选出哪一个次序。
★ (1)按算法 8.1,求三层循环 $4\times4096\times16$ 在 $P = 8$、$m = 512$ 时的并行深度;若 $P = 64$,结果如何?(2)在 $q \in [2P, 3P]$ 中,$\lceil q/P \rceil / (q/P)$ 何时取最大值?最大值是多少?
★ 设全局内存延迟为 $\lambda$、带宽为 $B$,每个 SM 驻留 $w$ 个线程束,每个线程每次发出 16 字节的读取。由利特尔法则,求每个线程至少须同时在途多少次读取才能使带宽饱和。以 9.1 节的数值与 $w = 32$、132 个 SM 计算之,并说明这一结果对块大小的选择意味着什么。
★ 对形状为 $n\times L$ 的 float32 张量按行做 softmax。(1)求 9.5 节融合内核与五个独立内核的访存字节数之比。(2)当 $L$ 超过持久化规约的上限时,两趟形式与在线形式各需读取输入几次?
★★ 在 $\Pi = {1, 2, 4, 8}^2$ 上构造一个代价函数 $t$,使算法 9.2 从某个初始点出发停在一个非全局最优的配置上。
★ 对 $m = n = k = 4096$ 的 float32 矩阵乘,设每个程序实例的片上存储至多容纳 $S = 48 \times 1024$ 个元素,取 $B_M = B_N = T$、$B_K = 32$。(1)求满足容量约束的最大的 2 的幂 $T$。(2)求此时的主存传输量与算术强度,并与 $I_{\max}$ 比较。(3)对 $\mathrm{relu}(AB + \mathbf b)$,求尾部融合节省的字节数占矩阵乘传输量的比例。
★ 设一个区域由 $n$ 个内核组成,每个内核的设备执行时间均为 $t$。由 9.9 节的模型,求 CUDA Graphs 的加速比关于 $n$、$t$、$t_{\mathrm{launch}}$ 与 $t_{\mathrm{graph}}$ 的表达式,并求其上界。
★ 9.9 节指出,CUDA Graphs 重放的输出位于图专用的内存池中。说明在每一步把输出追加到列表的训练循环中,开启 CUDA Graphs 后列表的内容为何不正确,并说明这与命题 2.1 所述的特化有何关系。
★★ 设函数含分支
if x.shape[0] % 8 == 0:,以第 0 维为 64 的样例导出,声明该维为 $n \in [1, 1024]$。(1)写出所得的形状守卫,说明它属于 10.2 节的哪一种情形。(2)若改用具体形状的compile,以第 0 维为 $1, 2, \dots, 64$ 依次调用,会产生多少个特化版本?按命题 10.3 分桶后又是多少?★ 设形状为 $(n, 128)$ 的 float32 张量按行求和,$n \in [1, 2^{24}]$。(1)求下标表达式的最大值,判断能否使用 32 位下标。(2)若 $n$ 没有声明上界,后端可以采取哪两种做法?各自的代价是什么?(3)说明规约拆分的段数为何只能按提示值选择,以及这对正确性与性能各有什么影响。
★★ (1)证明命题 11.1 中的生日界。(2)构造一个情形,使 $\mathrm{build}$ 对 $(s, a)$ 不是纯函数,从而缓存返回过期的产物,并说明如何扩充 $a$ 以排除之。
★★ 证明命题 11.2 的上界可以改进为 $\frac1P \sum_i c_i + (1 - \frac1P) \max_i c_i$,并构造一组任务说明这一界是紧的。
★★★ 比较执行期代理追踪(TensorPlay)、字节码级捕获(TorchDynamo)与抽象值追踪(JAX)在数据相关控制流、Python 副作用、特化程度与编译失败的处理四个方面的差异,并以程序特化的观点解释这些差异。
★★ 设 $a$ 的第 $i$ 次迭代写出 $B[i]$,$b$ 的第 $i$ 次迭代读取 $B[i-1]$($i \ge 1$)。(1)求依赖距离,按命题 7.3 判断顺序融合与并行融合是否合法。(2)若改为读取 $B[i+1]$ 呢?(3)对(1)的情形,说明在 GPU 上可以如何改写,使融合后的内核仍然正确(提示:让每个程序实例多计算一个元素)。代价是什么?
★★ 表 13.2 中,单个算子编译后的加速比多在 0.87 至 1.03 之间。(1)按命题 13.3,$\rho = 1$ 时 $S$ 等于什么?(2)按行
sum在 B 轮得到 $S = 0.63$。在定义 13.1 的模型下,说明这一个数为什么不足以证明编译后的内核更慢,并设计一个能够判定的实验(提示:交替计时,并对两种方式的读数之差应用命题 13.2)。(3)设写分配使写入的实际流量为计数的 1.5 倍。对例 1.1 重新计算 $\rho$,并与表 13.1 中 A 轮的 $S = 4.91$ 比较。★ 对命题 9.4:(1)设 $g_m = g_n = 16$、$W = 24$,分别求按行编号与 $G = 4$、$G = 8$ 时同时读取的输入块数。(2)$G$ 不整除 $W$ 时,命题的结论应如何修改?(3)同时运行的实例数 $W$ 由什么决定?它与 9.6 节的哪些配置参数有关?
★ 设 $N = 8192$,$d = 128$,片上存储 $M = 100 \times 1024$ 个元素,float16。(1)按定理 9.2 估算逐算子注意力与分块注意力的主存访问量之比。(2)若再考虑反向,逐算子实现需要保存 $P$,分块实现只保存 LSE,求二者保存的字节数之比。
★ 滑动窗口注意力只允许 $|q - k| \le w$ 的位置参与。设序列长度 $N$,块大小 $B$,$w$ 是 $B$ 的整数倍。(1)求完整块、部分块与空块的个数。(2)与因果掩码相比,块掩码节省的计算比例是多少?(3)若 $w$ 不是 $B$ 的整数倍,部分块的个数如何变化?
★★ 设 $f: \mathbb R^{1000} \to \mathbb R^{10}$,计算 $f$ 的代价为 $W$。(1)分别以前向模式与反向模式求完整的雅可比矩阵,代价各是多少?(2)若只需要 $J v$ 与 $u^{\mathsf T} J$ 各一个呢?(3)说明为什么编译后的区域不支持二阶导数,以及要支持它,AOT 层须多做什么。
★★ 设
n = x.nonzero().shape[0],随后有分支if n > 0:。(1)说明这一判断为什么不能像 10.2 节的形状守卫那样按样例求值并记录。(2)若用户确知x至少有一个非零元素,应如何改写程序使它可以编译?(3)这与命题 10.4 有何关系?★ (1)FP8 张量核心的标称算力约为 BF16 的 2 倍。按 9.8 节的方法,求 H100 上 FP8 方阵乘达到计算受限所需的最小阶数。(2)取 $B_M = B_N = 128$、$B_K = 128$、FP8,求每个流水级占用的片上存储,以及 228 KB 共享内存下
num_stages的上限。★★ 对命题 13.2:(1)验证 $n = 15$、$j = 4$、$k = 12$ 时覆盖概率为 $96.5%$。(2)以最小值与最大值 $[X_{(1)}, X_{(n)}]$ 作为中位数的置信区间,求使覆盖概率不低于 99% 的最小 $n$。(3)13.1 节指出,不同时段之间读数不再同分布。设共测 $r$ 轮,每轮 $n$ 次,各轮的中位数 $m_1, \dots, m_r$ 独立同分布,给出"总体中位数"的一个置信区间,并说明它与把 $rn$ 个读数合在一起应用命题 13.2 有何不同。
★★★ 对定理 13.1:(1)在同一模型下求两两配对的树形求和($n = 2^L$)的误差方差,分 $\mu = 0$ 与 $\mu \ne 0$ 两种情形,与推论 13.1 的 $W$ 路分段求和比较其关于 $n$ 的增长阶。(2)取 $n = 2048$、$\mu = 0$、$\sigma = 1$,比较顺序求和、16 路分段求和与树形求和的误差标准差。(3)Kahan 补偿求和的一阶误差项与 $n$ 无关。说明定理 13.1 的推导在哪一步不再适用,以及补偿求和为何不能与任意的重结合(6.5 节)同时使用。
★★ 对命题 13.5:(1)设大小 $s \in {1, \dots, 512}$ 服从截断的齐普夫分布 $p_s \propto 1/s$,数值计算 $\mathbb E[K_{1000}]$,与均匀分布的约 440 比较。(2)证明 $\mathbb E[K_m]$ 是 $m$ 的凹函数,并且 $\mathbb E[K_m] \le \min(m, |{s : p_s > 0}|)$。(3)分桶把大小 $s$ 补齐到不小于它的 2 的幂,每次调用的计算量至多翻倍。设编译代价为 $C$,大小为 $s$ 的一次调用耗时 $\alpha s$。写出 $m$ 次调用下按具体形状特化与分桶的期望总耗时,并给出分桶更优的条件。
★★ 对命题 13.6:(1)推广到第 $i$ 个算子读 $r_i$ 个张量、写一个张量的情形,求 $N^$。(2)若 $N$ 足够小、全部数据常驻 L2,有效带宽为 $\beta_2 > B$,$N^$ 如何变化?对本节的机器,L2 容量给出的 $N$ 上限与 $N^$ 相比如何?(3)由 13.4 节的数据,估计一条由 5 个逐元素算子组成的链的 $N^$,并说明 $k$ 增大时编译为何越来越有利。
★★★ (研究题)定理 7.1 允许任意给定的禁止对。(1)证明:若全部节点的迭代空间两两兼容且不存在非法的依赖距离,最小代价的融合方案可以在多项式时间内求出。(2)Stax 的禁止对由迭代空间的等价类(定义 7.2)与依赖距离(命题 7.3)决定。证明或否证:在这一受限的问题类上,最小代价融合仍是 NP 难的(提示:考虑两种迭代空间交替出现、并以规约连接的依赖图,并查阅 [55])。
★★ 对定理 5.1:(1)只含加法与乘法的程序,反向模式的总代价至多是前向的几倍?(2)设 $f(x) = \prod_{i=1}^n x_i$ 以 $n - 1$ 次乘法计算。写出反向趟,验证它以 $O(n)$ 次运算求出全部 $n$ 个偏导数;若逐个独立地计算每个偏导数,代价是多少?(3)说明为什么前向模式求同一个梯度需要 $\Theta(nW)$ 次运算,这与命题 5.2 有何关系。
★★ 对定理 9.1:(1)取习题 25 的参数($m = n = k = 4096$,$S = 48 \times 1024$),求下界的数值,并与习题 25 中分块的传输量比较。二者相差约多少倍?差距来自哪里?(2)设有 $P$ 个处理器,各有容量为 $S$ 的快速存储,全部乘积平均分配。证明某个处理器的传输次数不少于 $\dfrac{mnk}{2\sqrt3,P\sqrt S} - S$。(3)说明定理为什么不适用于 Strassen 算法,以及 Strassen 算法的 I/O 下界应当如何陈述。
★★ 对命题 7.4 的归约:(1)取 $H$ 为 4 个顶点的路径 $P_4$ 与 4 个顶点的圈 $C_4$,分别求 $\mathrm{vs}(H)$,构造 $D$,并求全部拓扑序中峰值的最小值,验证它落在证明给出的区间中。(2)若依赖图是一棵树(每个节点至多一个使用者),说明峰值最小的拓扑序可以在多项式时间内求出(提示:Sethi–Ullman 编号)。
★★ 对 6.9 节:(1)证明 $\mathrm{view}{\pi_1}(\mathrm{view}{\pi_2}(e)) \equiv \mathrm{view}_{\pi_2 \circ \pi_1}(e)$,并与命题 6.2 的仿射复合对照。(2)在核心语言中加入以显式状态 $\sigma$ 为参数的随机数运算 $\mathrm{rand}(\sigma)$,其语义同时返回新的状态。说明定理 6.2(1)在什么条件下对它成立。(3)给出一个程序,删去其中不被使用的绑定会改变它的可观察行为,并据此写出精化关系的定义。
★★ 对 7.7 节:设二重循环的距离向量为 $(1, 0)$、$(0, 1)$、$(1, -1)$。(1)由定理 7.2 判断循环交换是否合法;循环带是否完全可置换?(2)求一个幺模的偏斜变换,使变换后的循环带完全可置换,从而可以分块。(3)用引理 7.1 的思路,求一个一维仿射调度 $\theta(i, j) = c_1 i + c_2 j$,使每个距离向量满足 $c \cdot \delta \ge 1$;说明一维调度下哪些迭代可以并行执行。
★★ 对定理 5.4:(1)计算 $\beta(3, 3)$,并对链长 6、$s = 3$、$t = 2$ 写出一个完整的反演次序。(2)链长 $l = 1000$ 时,分别对 $t = 2, 3, 4$ 求所需的最少槽位数 $s$。(3)把(2)的结果与定理 5.3 的均匀分段(每步至多计算两次、存储 $2\sqrt l$)比较。
★★ 对命题 9.3:(1)取 $q = \delta = 0.01$,求所需的样本数 $N$。(2)构造一个代价函数,使坐标下降(算法 9.2)从某个初始点出发停在最慢的 10% 之中,而随机搜索以高概率避开它。(3)实测带有噪声时,命题 9.3 的结论如何修改?设计一个按连续减半分配测量次数的方案 [54],并估计它所需的总测量次数。
编程实验
以下实验以 TensorPlay 的源码为对象,每个约需 4 至 8 小时。实验 1、2 只需要安装包;实验 3 至 5 需要从源码以可编辑方式安装(pip install -e . --no-build-isolation,见仓库的 CLAUDE.md);实验 6 需要 CUDA 设备。每个实验的提交物都包括代码、数据与一页以内的分析,分析须把测量结果与本章的模型对照。
实验 1 屋顶线与归因。(1)在你的机器上测量读带宽与矩阵乘算力,画出实测的屋顶线(13.1 节)。(2)复现表 13.1 与表 13.2,把每个用例画在屋顶线上。(3)对每个用例,先按 1.1 节的方法写出模型预测的加速比,再与实测比较;相差超过 20% 的,用单算子基线或改变问题规模的办法找出原因。(4)把输入规模从 $2^{10}$ 个元素逐步增大到 $2^{26}$ 个,画出加速比随规模变化的曲线,解释曲线在 L2、L3 容量附近的变化。附录 B 给出了起点代码。
**实验 2 阅读生成的代码。**设置环境变量 TP_CACHE_DIR 指向一个空目录,编译例 1.1、例 7.1、例 7.2 与一个你自己的函数。生成的包装函数以 .py 文件保存在该目录下按内容哈希命名的子目录中(11.1 节),C++ 内核以字符串的形式嵌在其中。(1)对每个函数找到包装函数,标出其中的每一次分配、每一次内核调用与每一次释放,与 7.5 节的生存期分析对照。(2)对例 7.2,验证 CPU 上 exp 被实体化而 GPU 上不被实体化的结论(6.6 节),指出生成代码中的证据。(3)对同一个方阵依次传入 x 与 x.t(),缓存目录中会出现两份包装函数。比较二者 assert_size_stride 中的步长与内核中的下标表达式,说明它们为什么不同。
**实验 3 添加一条降级规则。**在 tensorplay/compiler/backends/stax/op_lowerings.py 中找一个目前作为回退内核执行、但本质上是逐元素运算的算子(可先用 TP_STAX_LOWER_DEBUG=1 与 strict_native=True 找出无法降级的算子)。(1)以 register_lowering 与 6.2 节的 pointwise 辅助函数为它写一条降级规则,计算函数只使用 ops 接口。(2)为它写测试,覆盖广播、非连续输入、零元素张量与特殊值($\pm 0$、$\pm\infty$、NaN),与即时执行逐元素比较。(3)测量它与相邻逐元素运算融合前后的耗时,与命题 1.1 的预测比较。
**实验 4 改变融合的打分。**融合的收益函数位于 tensorplay/compiler/backends/stax/choices.py 的 score_fusion,合法性判定为同一文件中的 can_fuse(7.3 节)。(1)构造一个函数,使算法 7.1 在两种合法的融合之间作出选择(习题 17 的构造可以作为起点)。(2)修改收益函数的字典序,例如把距离 $\delta$ 提到字节数之前,观察融合结果与峰值内存的变化。(3)关闭横向融合,测量例 7.2 的耗时变化。(4)写一份报告,说明你认为哪一种打分更好,以及你的证据在多大范围内成立。
**实验 5 动态形状的守卫。**参照 test/stax/test_stax_symbolic_shapes.py 中的计数后端,统计 tp.compile(fn, dynamic=True) 生成的产物个数。(1)复现例 10.4 的两个结论:形状分支生成 2 个产物,大小 0、1 与一般大小生成 3 个产物。(2)shape_guards.build_input_guard 返回的检查函数带有 source 属性,打印它,逐条解释其中的每一个条件来自哪一项假定(10.4 节)。(3)构造一个函数,使其产物个数随输入大小的种类线性增长,然后用 10.4 节的方法把它改写为常数个。
实验 6 注意力的变体(需要 CUDA)。(1)以 omni_attention 实现滑动窗口注意力(习题 37),用 BlockMask.sparsity() 检查块掩码的稀疏度,并与你在习题 37 中的计算对照。(2)对 $N = 1024, 2048, \dots, 16384$,测量手写的逐算子注意力、F.scaled_dot_product_attention 与 omni_attention 的耗时与峰值显存,按定理 9.2 解释峰值显存随 $N$ 的增长方式。(3)在 score_mod 中加入一个依赖于可学习张量的偏置,验证反向能对它求导,并比较带与不带 score_mod 的耗时。
上一节:第四节 GPU 代码生成与动态形状 | 目录 | 下一节:第六节 参考文献与附录