上一节:第三节 调度、融合与 CPU 代码生成 | 目录 | 下一节:第五节 缓存、讨论、模型与测量;小结与习题
文中参考文献编号 [n] 见第六节;章节号、定理号与习题号全章统一编号,跨节引用照常有效。
9 GPU 代码生成
在 CUDA 设备上,矩阵乘、卷积等模板节点交给模板代码生成器(9.8 节),其余的逐元素、规约与融合节点生成为 Triton [23] 内核。本节先介绍 GPU 的执行模型与 Triton 的编程模型,再依次讨论逐元素内核、规约内核的三种形态、多规约融合、启动配置的选择、矩阵乘与 CUDA Graphs。
9.1 执行模型与编程模型
GPU 由若干流多处理器(streaming multiprocessor,SM)组成。每个 SM 同时驻留多个线程块,线程以 32 个为一组构成线程束(warp),同一线程束中的线程在同一时刻执行同一条指令。GPU 的设计思想是以并发掩盖延迟:一次全局内存访问的延迟为数百个时钟周期,在此期间 SM 切换去执行其他就绪的线程束。
这一思想可以用利特尔法则(Little’s law)定量表述。设全局内存的延迟为 $\lambda$,带宽为 $B$,为使带宽饱和,任一时刻在途的访存字节数须达到
$$Q_{\text{在途}} = \lambda \cdot B.$$以 $\lambda \approx 600\ \mathrm{ns}$、$B = 3.35\ \mathrm{TB/s}$ 估算,约需 2 MB 的在途访存,分摊到 132 个 SM 上,每个 SM 约 15 KB。驻留的线程束越多、每个线程发出的独立访存越多,越容易达到这一并发度。SM 上同时驻留的线程束数受寄存器与共享内存的限制:每个线程使用的寄存器越多,可驻留的线程束越少。这是 9.4 与 9.6 节中块大小与线程束数之间权衡的根源。
访存的效率还取决于合并(coalescing):同一线程束中的 32 个线程若访问一段连续且对齐的地址,硬件将其合并为少数几次内存事务;若地址分散,则每个线程各需一次事务,有效带宽成倍下降。这与 8.2 节 CPU 上缓存行的分析同理。
CUDA C 以单个线程为编程单位,程序员需要显式处理线程束、共享内存与合并访存。Triton 以线程块为编程单位:一个内核被启动为若干个程序实例(program instance),每个实例处理一块数据,块内的并行与访存合并由 Triton 编译器负责。
定义 9.1(程序实例与块) Triton 内核以一个网格(grid)启动,网格的每个点为一个程序实例,以
tl.program_id(axis)取得其坐标。实例内的计算以块(block)为单位表达:tl.arange(0, BLOCK)生成长度为BLOCK的下标向量,tl.load(ptr + offsets, mask)按向量下标读取,mask为假的位置不访问内存;tl.store同理。块大小须为编译期常量(tl.constexpr)且为 2 的幂。
在这一模型下,Stax 的循环级中间表示可以较直接地映射为内核:迭代范围的每一维对应一个下标向量,inner_fn 中的每个 ops 调用对应一条块级运算,越界的位置以掩码屏蔽。块大小不由代码生成决定,而是作为内核参数留待实测选择(9.6 节)。
9.2 内核的结构
代码清单 9.1 为例 1.1 在 CUDA 设备上生成的 Triton 内核,即 1.1 节代码清单 1.2 的完整形式(保留了全部下标变量的定义),以便逐段对照。
代码清单 9.1 例 1.1 的 Triton 内核(省略了导入语句与装饰器参数)
@triton_heuristics.persistent_reduction(size_hints={'x': 64, 'r0_': 128}, ...)
@triton.jit
def triton_per_fused_0(in_ptr0, in_ptr1, out_ptr0, xnumel, r0_numel, XBLOCK : tl.constexpr):
    xnumel = 64
    r0_numel = 128
    R0_BLOCK: tl.constexpr = 128
    rnumel = r0_numel
    RBLOCK: tl.constexpr = R0_BLOCK
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[:, None]
    xmask = xindex < xnumel
    r0_index = tl.arange(0, R0_BLOCK)[None, :]
    r0_offset = 0
    r0_mask = tl.full([R0_BLOCK], True, tl.int1)[None, :]
    roffset = r0_offset
    rindex = r0_index
    r0_1 = r0_index
    x0 = xindex
    tmp0 = tl.load(in_ptr0 + (r0_1 + 128*x0), xmask, eviction_policy='evict_first', other=0.0)
    tmp1 = tl.load(in_ptr1 + (r0_1 + 128*x0), xmask, eviction_policy='evict_first', other=0.0)
    tmp2 = (tmp0 + tmp1)
    tmp3 = tl.full([1, 1], 0, tl.int32)
    tmp4 = tl.maximum(tmp3, tmp2, tl.PropagateNan.ALL)
    tmp5 = tl.full([1, 1], 2.0, tl.float32)
    tmp6 = (tmp4 * tmp5)
    tmp7 = tl.broadcast_to(tmp6, [XBLOCK, R0_BLOCK])
    tmp9 = tl.where(xmask, tmp7, 0)
    tmp10 = tl.sum(tmp9, 1)[:, None].to(tl.float32)
    tl.store(out_ptr0 + (x0), tmp10, xmask)
内核由四部分组成。
(1)签名与常量。参数依次为输入指针、输出指针、各维的元素数与块大小。形状静态已知时,元素数在函数体开头被改写为常量(xnumel = 64),使 Triton 编译器能据此化简掩码与地址计算。
(2)下标与掩码。逐元素维 x 与规约维 r0_ 各对应一个下标向量。xindex 的形状为 [XBLOCK, 1],r0_index 的形状为 [1, R0_BLOCK],二者广播后构成一个 XBLOCK × R0_BLOCK 的二维块:每个程序实例处理 XBLOCK 行,每行全部 128 个元素。xmask 屏蔽超出 64 行的位置;规约维长度 128 恰为块大小,代码生成器判定其掩码恒真,直接写为 tl.full(..., True, ...)。
(3)计算。tmp0 至 tmp6 与代码清单 6.2 中 inner_fn 的各个 ops 调用一一对应。ops.load 成为带掩码的 tl.load,下标表达式 128*i0 + r0_0 原样成为地址偏移;ops.relu 成为 tl.maximum(0, x, tl.PropagateNan.ALL),其中 PropagateNan.ALL 保证输入为 NaN 时输出也为 NaN,与即时执行的语义一致。eviction_policy='evict_first' 提示硬件这些数据只读一次,可优先从 L2 缓存中逐出。
(4)规约与写回。被掩码屏蔽的位置先以 tl.where 置为规约的单位元 0,再以 tl.sum 沿第 1 维求和,最后以 tl.store 写回 XBLOCK 个结果。
与代码清单 1.1 的 CPU 内核相比,二者来自同一个循环级中间表示,差别只在打印方式:CPU 内核以显式循环遍历两个维度,Triton 内核以块级向量运算一次处理一个 XBLOCK × 128 的块,循环由网格与块内并行代替。
9.3 逐元素内核与二维分块
逐元素内核没有规约维,只有一个或多个逐元素维。代码清单 9.2 为例 6.1(x.t() + y)的内核。
代码清单 9.2 例 6.1 的 Triton 内核(省略了导入语句与装饰器参数)
@triton_heuristics.pointwise(size_hints={'y': 256, 'x': 512}, tile_hint=TileHint.DEFAULT, ...)
@triton.jit
def triton_poi_fused_0(in_ptr0, in_ptr1, out_ptr0, ynumel, xnumel, YBLOCK : tl.constexpr, XBLOCK : tl.constexpr):
    ynumel = 256
    xnumel = 512
    yoffset = tl.program_id(1) * YBLOCK
    yindex = yoffset + tl.arange(0, YBLOCK)[:, None]
    ymask = yindex < ynumel
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[None, :]
    xmask = xindex < xnumel
    x1 = xindex
    y0 = yindex
    tmp0 = tl.load(in_ptr0 + (256*x1 + y0), xmask & ymask)
    tmp1 = tl.load(in_ptr1 + (x1 + 512*y0), xmask & ymask)
    tmp2 = (tmp0 + tmp1)
    tl.store(out_ptr0 + (x1 + 512*y0), tmp2, xmask & ymask)
两个输入的下标分别为 256*x1 + y0 与 x1 + 512*y0:前者沿 y 连续,后者沿 x 连续。若采用一维分块,即把 $256\times512$ 个输出看作一个长度为 131072 的向量切块,则相邻线程读取的 $x^{\mathsf T}$ 元素在内存中相隔 256 个 float,访存无法合并。二维分块以 YBLOCK × XBLOCK 的矩形为单位:块内沿 y 的相邻元素对第一个输入连续,沿 x 的相邻元素对第二个输入与输出连续,Triton 编译器可以在块内重排访存,使两侧都得到合并的访问。网格因此为二维,program_id(1) 对应 y,program_id(0) 对应 x,元数据中的网格类型为 Grid2D。
是否采用二维分块,由 SIMD 层的分块选择决定:对每种候选的维度切分,按其能使多少字节的访存合并来打分,取得分最高且维数不超过上限的方案(默认至多三维)。例 1.1 的两个输入均沿规约维连续,一维即可;例 6.1 的两个输入连续方向不同,故选二维。
代码清单 9.3 为例 5.1 中 GELU 反向的逐元素内核,可与代码清单 5.3 的 CPU 版本对照(5.5 节的代码清单 5.4 是它的节选)。
代码清单 9.3 例 5.1 的反向逐元素内核(GPU,省略了导入语句与装饰器参数)
@triton_heuristics.pointwise(size_hints={'x': 2048}, ...)
@triton.jit
def triton_poi_fused_0(in_ptr0, in_ptr1, out_ptr0, xnumel, XBLOCK : tl.constexpr):
    xnumel = 2048
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[:]
    xmask = xindex < xnumel
    x0 = xindex
    tmp0 = tl.load(in_ptr0 + (0))
    tmp1 = tl.broadcast_to(tmp0, [XBLOCK])
    tmp2 = tl.load(in_ptr1 + (x0), xmask)
    tmp3 = tl.full([1], 0.7071067811865476, tl.float32)
    tmp4 = (tmp2 * tmp3)
    tmp5 = libdevice.erf(tmp4)
    tmp6 = tl.full([1], 1.0, tl.float32)
    tmp7 = (tmp6 + tmp5)
    tmp8 = tl.full([1], 0.5, tl.float32)
    tmp9 = (tmp8 * tmp7)
    tmp10 = (tmp2 * tmp2)
    tmp11 = tl.full([1], -0.5, tl.float32)
    tmp12 = (tmp11 * tmp10)
    tmp13 = libdevice.exp(tmp12)
    tmp14 = tl.full([1], 0.3989422804014327, tl.float32)
    tmp15 = (tmp14 * tmp13)
    tmp16 = (tmp2 * tmp15)
    tmp17 = (tmp9 + tmp16)
    tmp18 = (tmp1 * tmp17)
    tl.store(out_ptr0 + (x0), tmp18, xmask)
in_ptr0 为上游梯度。由于前向的输出 loss 是标量,上游梯度只有一个元素,内核以 tl.load(in_ptr0 + (0)) 读取后广播到整个块。in_ptr1 为前向保存的 $h$。tmp9 为 $\Phi(h)$,tmp15 为 $\varphi(h)$,tmp17 为 $\Phi(h) + h\varphi(h)$,即 $\mathrm{GELU}’(h)$,与 5.5 节的推导逐项对应。erf 与 exp 调用 libdevice 中的设备函数。
9.4 规约内核的三种形态
规约内核按规约维的长度采用三种形态。
(1)持久化规约(persistent reduction)。若规约维足够短,一个程序实例可以把整行读入寄存器,一次规约完成,不需要循环,也不需要累加器跨迭代保存。代码清单 9.1 即为此种形态,内核名前缀为 per。是否采用持久化规约由以下规则决定:规约沿连续维进行(INNER)时,长度不超过 1024;其他情形下,长度不超过 64,且长度的上下界须为同一个 2 的幂。块大小 R0_BLOCK 取不小于规约长度的最小 2 的幂,超出部分以掩码屏蔽。
(2)循环规约(looped reduction)。规约维较长时,每个程序实例以步长 R0_BLOCK 沿规约维循环,在寄存器中维护一个 XBLOCK × R0_BLOCK 的累加器,循环结束后再沿第 1 维规约为每行一个值。内核名前缀为 red。
(3)规约拆分。输出数过少时,降级阶段已将规约拆为两层(6.5 节),代码生成相应地产生两个内核。
代码清单 9.4 为例 6.2 的两个内核,前者为循环规约,后者为持久化规约。
代码清单 9.4 例 6.2 的两个 Triton 内核(省略了导入语句与装饰器参数)
@triton_heuristics.reduction(size_hints={'x': 128, 'r0_': 8192}, reduction_hint=ReductionHint.INNER, ...)
@triton.jit
def triton_red_fused_0(in_ptr0, out_ptr0, xnumel, r0_numel, XBLOCK : tl.constexpr, R0_BLOCK : tl.constexpr):
    xnumel = 128
    r0_numel = 8192
    rnumel = r0_numel
    RBLOCK: tl.constexpr = R0_BLOCK
    xoffset = tl.program_id(0) * XBLOCK
    xindex = xoffset + tl.arange(0, XBLOCK)[:, None]
    xmask = xindex < xnumel
    r0_base = tl.arange(0, R0_BLOCK)[None, :]
    rbase = r0_base
    x0 = xindex
    _tmp3 = tl.full([XBLOCK, R0_BLOCK], 0, tl.float32)
    for r0_offset in tl.range(0, r0_numel, R0_BLOCK):
        r0_index = r0_offset + r0_base
        r0_mask = r0_index < r0_numel
        roffset = r0_offset
        rindex = r0_index
        r0_1 = r0_index
        tmp0 = tl.load(in_ptr0 + (r0_1 + 8192*x0), r0_mask & xmask, eviction_policy='evict_first', other=0.0)
        tmp1 = (tmp0 * tmp0)
        tmp2 = tl.broadcast_to(tmp1, [XBLOCK, R0_BLOCK])
        tmp4 = (_tmp3 + tmp2)
        _tmp3 = tl.where(r0_mask & xmask, tmp4, _tmp3)
    tmp3 = tl.sum(_tmp3, 1)[:, None]
    tl.store(out_ptr0 + (x0), tmp3, xmask)

@triton_heuristics.persistent_reduction(size_hints={'x': 64, 'r0_': 2}, reduction_hint=ReductionHint.INNER, ...)
@triton.jit
def triton_per_fused_1(in_ptr0, out_ptr0, xnumel, r0_numel, XBLOCK : tl.constexpr):
    xnumel = 64
    r0_numel = 2
    R0_BLOCK: tl.constexpr = 2
    ...
    tmp0 = tl.load(in_ptr0 + (r0_1 + 2*x0), r0_mask & xmask, eviction_policy='evict_first', other=0.0)
    tmp1 = tl.broadcast_to(tmp0, [XBLOCK, R0_BLOCK])
    tmp3 = tl.where(r0_mask & xmask, tmp1, 0)
    tmp4 = tl.sum(tmp3, 1)[:, None].to(tl.float32)
    tl.store(out_ptr0 + (x0), tmp4, xmask)
第一个内核的迭代范围为 $64\times2 = 128$ 个输出,每个输出规约 8192 个元素。下标 r0_1 + 8192*x0 将 $[64, 2]$ 两维合并为一维 x0:这是代码生成对连续维度的合并,因为 16384*i0 + 8192*i1 恰等于 8192*(2*i0 + i1)。循环体内只有一条 tl.load,而代码清单 6.4 中同一位置读取了两次:内核内的公共子表达式消除将两次读取合并,x * x 成为 tmp0 * tmp0。累加器 _tmp3 在循环外以单位元初始化,循环内以 tl.where 只在有效位置累加,循环后沿块的第 1 维求和。
第二个内核的规约维长度为 2,采用持久化规约。两个内核之间的部分和缓冲区为 $64\times2$ 个 float,共 512 字节。
9.5 多规约融合
规约内核可以融合多个规约以及它们之间的逐元素运算。softmax 是典型的例子:
$$\mathrm{softmax}(x)_j = \frac{e^{x_j - m}}{\sum_k e^{x_k - m}},\qquad m = \max_k x_k.$$减去行最大值 $m$ 是为了避免指数溢出。按定义计算需要两次规约(max 与 sum)与若干逐元素运算。代码清单 9.5 为 F.softmax(x, -1) 在 $x$ 形状为 $256\times1000$ 时生成的内核。
代码清单 9.5 softmax 的 Triton 内核(省略了导入语句与装饰器参数)
@triton_heuristics.persistent_reduction(size_hints={'x': 256, 'r0_': 1024}, reduction_hint=ReductionHint.INNER, ...)
@triton.jit
def triton_per_fused_0(in_ptr0, out_ptr2, xnumel, r0_numel, XBLOCK : tl.constexpr):
    xnumel = 256
    r0_numel = 1000
    R0_BLOCK: tl.constexpr = 1024
    ...
    r0_mask = r0_index < r0_numel
    ...
    tmp0 = tl.load(in_ptr0 + (r0_1 + 1000*x0), r0_mask & xmask, eviction_policy='evict_first', other=0.0)
    tmp1 = tmp0.to(tl.float32)
    tmp2 = tl.broadcast_to(tmp1, [XBLOCK, R0_BLOCK])
    tmp4 = tl.where(r0_mask & xmask, tmp2, float("-inf"))
    tmp5 = triton_helpers.max2(tmp4, 1)[:, None].to(tl.float32)
    tmp6 = tmp1 - tmp5
    tmp7 = libdevice.exp(tmp6)
    tmp8 = tl.broadcast_to(tmp7, [XBLOCK, R0_BLOCK])
    tmp10 = tl.where(r0_mask & xmask, tmp8, 0)
    tmp11 = tl.sum(tmp10, 1)[:, None].to(tl.float32)
    tmp12 = (tmp7 / tmp11)
    tmp13 = tmp12.to(tl.float32)
    tl.store(out_ptr2 + (r0_1 + 1000*x0), tmp13, r0_mask & xmask)
整个 softmax 成为一个持久化规约内核。规约长度 1000 不超过 1024,块大小取 1024,后 24 个位置以 r0_mask 屏蔽。两次规约使用不同的单位元:求最大值时屏蔽位置填 $-\infty$,求和时填 0。每行只从全局内存读取一次、写回一次,最大值、指数与求和均在寄存器中完成。
若 softmax 以 amax、减法、exp、sum、除法五个独立内核实现,设 $x$ 有 $N$ 个元素、$n$ 行,则五个内核依次读取 $N$、$N + n$、$N$、$N$、$N + n$ 个元素,写出 $n$、$N$、$N$、$n$、$N$ 个元素,合计约 $8N$。融合后每行只读 1000 个元素、写 1000 个元素,合计 $2N$,按命题 1.1 已达到下界。这一结果来自三个层次的配合:降级阶段将 softmax 展开为两个规约与逐元素运算,调度阶段将它们融合为一个节点,持久化规约使中间结果不必离开寄存器。
规约长度若超过持久化规约的上限,一行无法同时驻留在寄存器中,按定义计算须遍历该行两次:第一次求 $m$,第二次求 $\sum_k e^{x_k - m}$。在线 softmax [24] 把二者合为一次遍历,其依据仍是 6.5 节的幺半群结构。对一段元素,记二元组 $(m, d)$,其中 $m$ 为最大值,$d = \sum_k e^{x_k - m}$。两段的合并定义为
$$(m_1, d_1) \oplus (m_2, d_2) = \bigl(M,\ d_1 e^{m_1 - M} + d_2 e^{m_2 - M}\bigr),\qquad M = \max(m_1, m_2).$$单个元素 $x$ 对应 $(x, 1)$,单位元为 $(-\infty, 0)$。
命题 9.1 上述 $\oplus$ 满足结合律与交换律。对一行元素按任意顺序、任意分段合并,所得的 $(m, d)$ 均为该行的最大值与 $\sum_k e^{x_k - m}$。
证明 由归纳法,若 $(m_i, d_i)$ 是第 $i$ 段的正确结果,则 $d_i e^{m_i - M} = \sum_{k \in \text{段 } i} e^{x_k - M}$,于是合并结果的第二分量为 $\sum_{k} e^{x_k - M}$,第一分量为两段的最大值,正是并集的正确结果。正确结果只依赖于元素的集合,故合并与顺序、分段无关,结合律与交换律随之成立。$\square$
由命题 9.1,在线 softmax 可以像求和一样循环累加、拆分与向量化。对短行,两趟形式与一趟形式的访存相同,Stax 在持久化规约中采用两趟形式。
内核名的前缀表示其形态:poi、red、per、tem 分别表示逐元素、循环规约、持久化规约与模板。
9.6 启动配置的选择
代码清单 9.1 至 9.5 中,块大小 XBLOCK、R0_BLOCK 均为内核参数,线程束数与流水级数则由装饰器给出。这些参数合称启动配置。网格大小由配置推出,例如一维网格含 $\lceil \texttt{xnumel} / \texttt{XBLOCK} \rceil$ 个程序实例;例 1.1 若取 XBLOCK = 8,则启动 8 个实例,每个实例处理 8 行。
配置的选择受 9.1 节的两个因素制约。块越大,每个实例发出的独立访存越多,有利于达到利特尔法则要求的在途访存量,但每个线程占用的寄存器也越多,SM 上可驻留的线程束越少;块越小,实例越多,调度开销与边界掩码的比例越高。对持久化规约还有一个硬约束:整行须驻留在寄存器中,故 XBLOCK 与规约长度之积不能过大。两方面的权衡与具体设备、具体形状有关,难以写成闭式。
定义 9.2(配置空间) 设内核有 $p$ 个可调参数,第 $i$ 个参数在有限集合 $A_i$ 中取值,配置空间为 $\Pi = A_1 \times \cdots \times A_p$。代价函数 $t : \Pi \to \mathbb R_{>0} \cup {\infty}$ 为配置在给定输入上的实测耗时,不可编译或资源超限的配置记为 $\infty$。
$t$ 只能通过实测求值,没有可用的解析形式,因此配置选择是一个黑盒优化问题。$|\Pi|$ 随 $p$ 指数增长,穷举每个配置都需要一次编译与多次启动,代价过高。Stax 分两步处理:先由启发式规则按内核形态、size_hints 与规约方向生成一个小的候选集合 $C \subseteq \Pi$,在 $C$ 上实测取最优;再可选地以坐标下降在该点附近微调。
算法 9.1 启动配置的实测选择
输入:候选配置集合 C,首次调用的实参 args
输出:选定的配置 c*
1  if 缓存中存在与本内核源码及 C 对应的记录: return 记录中的配置
2  if |C| = 1: return C 中唯一的配置
3  for c in C:
4      编译 c;若发生寄存器溢出: t(c) ← ∞
5      else: 在 args 上预热后重复启动,取耗时的统计值作为 t(c)
6  c* ← argmin_{c ∈ C} t(c)
7  记录 c*;return c*
候选的规模通常只有 1 到 6 个。第 4 行把寄存器溢出的配置直接排除:溢出的寄存器被放到局部内存中,每次访问都经过存储层次,其开销通常远大于候选之间的差异。第 1 行与第 7 行使测量只在首次调用时发生,记录以内核源码的哈希为键,源码不变则结论不变,其原理与 11.1 节的内容寻址缓存相同。
坐标下降在当前配置的邻域中搜索。对每个参数,邻域由将其乘 2 或除 2 得到的配置组成,其余参数不变。
算法 9.2 坐标下降
输入:初始配置 c,阈值 ε > 0
输出:配置 c
1  repeat
2      improved ← false
3      for i = 1 to p:
4          for c' in {c 的第 i 个参数乘 2,c 的第 i 个参数除 2}:
5              if c' ∈ Π 且 t(c') < (1 − ε) · t(c):
6                  c ← c';improved ← true
7  until not improved
8  return c
命题 9.2 设 $t$ 是确定的函数(同一配置的每次求值给出同一结果),且 $t(c_0) < \infty$。算法 9.2 在至多 $\min\bigl(|\Pi|,\ \lceil \log(t(c_0)/t_{\min}) / {-\log(1-\varepsilon)} \rceil\bigr)$ 次接受之后终止,其中 $t_{\min} = \min_\Pi t$。终止时的配置 $c$ 满足:对任一只在一个坐标上相差 2 倍的邻居 $c’$,$t(c’) \ge (1 - \varepsilon), t(c)$。
证明 每次接受使 $t$ 至少乘以 $1 - \varepsilon$,故被接受的配置两两不同,接受次数不超过 $|\Pi|$;又 $t(c_0)(1-\varepsilon)^s \ge t_{\min}$,得 $s \le \log(t(c_0)/t_{\min}) / {-\log(1-\varepsilon)}$。每一轮外层循环若没有接受即终止,故算法有限步终止。终止时最后一轮检查了所有邻居且无一被接受,即得所述性质。$\square$
命题 9.2 给出的是局部最优性。$t$ 在 $\Pi$ 上一般不是单峰的,例如块大小跨过寄存器容量的界限时耗时会突变,坐标下降可能停在远离全局最优的点上。命题 9.2 假定 $t$ 是确定的,而实测的耗时带有噪声。设每次测量为 $\hat t(c) = t(c)(1 + \eta)$,噪声 $|\eta| \le \eta_{\max}$。若 $\varepsilon > 2\eta_{\max}/(1+\eta_{\max})$,则 $\hat t(c’) < (1-\varepsilon)\hat t(c)$ 蕴涵 $t(c’) < t(c)$,即每次接受的确是真实的改进,被接受的配置仍两两不同,终止性随之保持;局部最优性则只在相差超过约 $\varepsilon + 2\eta_{\max}$ 的意义下成立。阈值过小时,噪声可能使算法接受一个实际更慢的配置,甚至在两个配置之间反复切换。Stax 取 $\varepsilon = 10^{-3}$,并以多次重复取统计值来压低 $\eta_{\max}$(算法 9.1 第 5 行);GPU 上单次计时的相对噪声常在 1% 量级,此时上述条件并不满足,坐标下降的结论应理解为启发式的,而不是命题 9.2 意义下的保证。
随机搜索提供了另一种不依赖 $t$ 的形状的保证。
命题 9.3(随机搜索的分位数保证 [53]) 设从 $\Pi$ 中独立、均匀地抽取 $N$ 个配置,取实测最快者 $\hat c$。令 $t_q$ 为第 $\lceil q|\Pi| \rceil$ 快的配置的耗时,$G_q = {c : t(c) \le t_q}$($0 < q \le 1$;有并列时 $G_q$ 可能多于 $\lceil q|\Pi| \rceil$ 个)。则 $\Pr[\hat c \in G_q] \ge 1 - (1 - q)^N$;要使这一概率不低于 $1 - \delta$,取 $N \ge \ln(1/\delta) / q$ 即可。
证明 每次抽样落入 $G_q$ 的概率不小于 $\lceil q|\Pi|\rceil / |\Pi| \ge q$,$N$ 次都不落入的概率至多 $(1-q)^N$。只要有一次落入 $G_q$,最快者就在 $G_q$ 中($t$ 确定时)。由 $\ln(1-q) \le -q$,$(1-q)^N \le e^{-qN} \le \delta$ 当 $N \ge \ln(1/\delta)/q$。$\square$
例如 $q = \delta = 0.05$ 时 $N = 60$ 即可:以 95% 的概率找到最好的 5% 之一,与参数个数 $p$ 和 $t$ 是否单峰都无关。代价是这一保证只是相对于分位数的,它不保证接近全局最优的耗时。两类方法因此互补:随机搜索给出不依赖形状的全局保证,坐标下降(命题 9.2)在其结果附近作局部改进。Stax 以启发式规则生成的小候选集合,可以理解为把概率质量集中在经验上好的区域,等效于增大了 $q$。更一般的做法有两个方向:以连续减半(successive halving)与 Hyperband 在候选之间分配测量的次数,尽早淘汰明显较差者 [54];以学习的代价模型代替实测,只对模型预测的前若干名作实测,TVM 与 Ansor 采用了这一做法 [28, 49]。
9.7 GPU 包装函数
GPU 上的包装函数与 CPU 上的结构相同,区别在于设备上下文与流。代码清单 9.6 为例 6.2 的包装函数。
代码清单 9.6 例 6.2 的包装函数(省略了变量名前缀 GraphLowering_)
triton_red_fused_0 = async_compile.triton('triton_red_fused_0', '''...''', device_str='cuda')
triton_per_fused_1 = async_compile.triton('triton_per_fused_1', '''...''', device_str='cuda')
async_compile.wait(globals())

def call(self, args):
    primals_1, = args
    args.clear()
    assert_size_stride(primals_1, (64, 16384), (16384, 1), 'input')
    with tp.cuda.device(0):
        tp.cuda.set_device(0)
        buf1 = empty_strided_cuda((64, 2), (2, 1), tensorplay.float32)
        raw_stream0 = get_raw_stream(0)
        triton_red_fused_0.run(primals_1, buf1, 128, 8192, stream=raw_stream0)
        del primals_1
        buf2 = empty_strided_cuda((64, ), (1, ), tensorplay.float32)
        triton_per_fused_1.run(buf1, buf2, 64, 2, stream=raw_stream0)
        del buf1
    return (buf2, )
所有设备操作位于 tp.cuda.device(0) 的上下文中。两个内核按程序顺序提交到同一个 CUDA 流,流内的操作按提交顺序执行,第二个内核读取 buf1 无需显式同步;依赖图中的边 $a \to b$ 由提交顺序实现,这是单流执行对 7.1 节依赖关系的满足方式。启动调用只传入实参与各维元素数,网格在启动时按选定的配置计算。del primals_1 与 del buf1 在最后一次使用之后释放引用,释放的显存回到缓存分配器,供后续分配复用,这对应 7.5 节的生存期分析。
9.8 矩阵乘模板与尾部融合
矩阵乘与卷积不经过循环级中间表示,而是在降级时构造一个候选集合,在代码生成前从中选择一个实现。候选包括框架自带的矩阵乘(以外部调用的形式出现在包装函数中)与若干 Triton 矩阵乘模板。外部调用对编译器不透明,模板则是可以被改写的源码,这一区别决定了下文的尾部融合只能发生在模板上。
矩阵乘与逐元素运算的性质不同。设 $A \in \mathbb R^{m \times k}$、$B \in \mathbb R^{k \times n}$,$C = AB$ 需要 $2mnk$ 次浮点运算,而输入输出共 $mk + kn + mn$ 个元素。以 $b$ 记元素的字节数,算术强度的上限为
$$I_{\max} = \frac{2mnk}{b\,(mk + kn + mn)}.$$当 $m = n = k$ 时,$I_{\max} = 2n / (3b)$,随 $n$ 线性增长。按屋顶线模型 [1],足够大的矩阵乘是计算受限的,这与逐元素运算 $O(1)$ 的算术强度形成对照。
$I_{\max}$ 只有在片上存储足以复用数据时才能达到。分块矩阵乘把 $C$ 划分为 $B_M \times B_N$ 的块,每个程序实例计算一块:沿 $k$ 维以 $B_K$ 为步长循环,每步把 $A$ 的 $B_M \times B_K$ 子块与 $B$ 的 $B_K \times B_N$ 子块读入片上存储,在寄存器中累加。每个实例共读取 $(B_M + B_N),k$ 个元素,全部实例合计
$$Q = b\Bigl(\frac{mnk}{B_N} + \frac{mnk}{B_M} + mn\Bigr),$$算术强度约为 $\dfrac{2 B_M B_N}{b,(B_M + B_N)}$,取 $B_M = B_N = T$ 时为 $T/b$。块越大,复用越充分,但片上存储须容纳 $(B_M + B_N) B_K$ 个输入元素与 $B_M B_N$ 个累加器。若片上存储为 $S$ 个元素,则 $T = O(\sqrt S)$,主存传输量为 $\Omega(mnk / \sqrt S)$。这一传输量在渐近意义下不可改进,这是洪加威与孔祥重以红蓝卵石博弈首先证明的 [25]。下面给出 Irony、Toledo 与 Tiskin 的较短证明 [40],它依赖于一个关于投影的组合不等式。
引理 9.1(Loomis–Whitney 不等式 [39]) 设 $T \subset \mathbb Z^3$ 为有限集,$T_{12}$、$T_{13}$、$T_{23}$ 分别为它在三个坐标平面上的投影,则
$$|T|^2 \le |T_{12}|\,|T_{13}|\,|T_{23}|.$$
证明 对每个 $x$,令 $T_x = {(y, z) : (x, y, z) \in T}$,$\alpha_x = |{y : (x, y) \in T_{12}}|$,$\beta_x = |{z : (x, z) \in T_{13}}|$。$T_x$ 含于这两个集合的笛卡儿积,故 $|T_x| \le \alpha_x \beta_x$;$T_x$ 又与 $T_{23}$ 的一个子集一一对应,故 $|T_x| \le |T_{23}|$。于是 $|T_x| \le \sqrt{\alpha_x \beta_x, |T_{23}|}$,求和并用柯西–施瓦茨不等式:
$$|T| = \sum_x |T_x| \le \sqrt{|T_{23}|}\sum_x \sqrt{\alpha_x \beta_x} \le \sqrt{|T_{23}|}\,\sqrt{\textstyle\sum_x \alpha_x}\,\sqrt{\textstyle\sum_x \beta_x} = \sqrt{|T_{23}|\,|T_{12}|\,|T_{13}|}.\ \square$$考虑两级存储:快速存储至多容纳 $S$ 个字,慢速存储容量不限;运算的操作数必须在快速存储中;每次读入或写出一个字计为一次传输。称一个算法为标准矩阵乘,若它对每个三元组 $(i, j, l) \in [m] \times [n] \times [k]$ 恰好计算一次乘积 $a_{il} b_{lj}$,并把它累加进 $c_{ij}$ 的某个部分和中,部分和只被相加,不被丢弃。
定理 9.1(矩阵乘的 I/O 下界 [25, 40]) 任何标准矩阵乘的传输次数满足
$$Q \ge \frac{mnk}{2\sqrt 3\, \sqrt S} - S.$$
证明 把执行过程按传输切分为若干段,每段恰含 $S$ 次传输(最后一段可以更少),共 $h = \lceil Q / S \rceil$ 段。考察一段中计算的乘积所对应的三元组之集 $\mathcal T$,以 $\mathcal T_{il}$、$\mathcal T_{lj}$、$\mathcal T_{ij}$ 记它在三个坐标平面上的投影。每个参与运算的 $a_{il}$ 或者在本段开始时已在快速存储中,或者在本段内读入,故 $|\mathcal T_{il}| \le 2S$;同理 $|\mathcal T_{lj}| \le 2S$。每个被累加的部分和 $c_{ij}$,或者在本段开始时已在快速存储中(至多 $S$ 个),或者在本段内读入,或者在本段内新建;新建的部分和在段末或者仍在快速存储中(至多 $S$ 个),或者已被写出,或者已被并入另一个同下标的部分和(此时该下标已被另一个部分和计入)。读入与写出合计不超过 $S$ 次,故 $|\mathcal T_{ij}| \le 3S$。由引理 9.1,$|\mathcal T| \le \sqrt{2S \cdot 2S \cdot 3S} = 2\sqrt 3, S^{3/2}$。全部 $mnk$ 个乘积分布在 $h$ 段中,故 $mnk \le h \cdot 2\sqrt3, S^{3/2} \le (Q/S + 1), 2\sqrt3, S^{3/2}$,整理即得。$\square$
与分块算法比较:取 $B_M = B_N = T$ 且 $2T B_K + T^2 \le S$,分块的传输量约为 $2mnk/T = \Theta(mnk/\sqrt S)$,与定理 9.1 的下界只差常数因子,分块因而在渐近意义下是最优的。定理不适用于 Strassen 类算法,它们不计算全部 $mnk$ 个乘积。模板中 $B_M$、$B_N$、$B_K$ 与线程束数一起构成 9.6 节的配置空间。
当 $k$ 远大于 $m$ 与 $n$ 时(Stax 的判据为 $k \ge 128 \cdot \max(m, n)$),输出块数 $\lceil m/B_M \rceil \lceil n/B_N \rceil$ 太少,不足以占满所有 SM。此时可把 $k$ 维分为 $s$ 段,各段独立计算部分积,再对 $s$ 个部分积求和。由于矩阵加法是交换幺半群运算,这与 6.5 节规约拆分的依据相同,并行度提高到原来的 $s$ 倍,代价是 $s$ 个 $m \times n$ 部分积的额外读写。
选中 Triton 模板时,模板之后的逐元素运算可以作为尾部(epilogue)融入模板内核。以 $\mathrm{relu}(AB + \mathbf b)$ 为例,若分别执行,矩阵乘写出 $C$,逐元素内核再读入 $C$ 与 $\mathbf b$ 并写出结果,多出约 $2mn$ 个元素的传输;融合后,加偏置与 relu 在累加器写回之前、数据仍在寄存器中时完成,额外传输只剩读取 $\mathbf b$ 的 $n$ 个元素。这一节省相对于矩阵乘本身的传输量 $Q$ 的比例,在 $k$ 较小、矩阵乘接近访存受限时最为显著。尾部融合要求后一节点不含规约、不含别名或原地修改,否则其迭代空间与模板的输出块不能一一对应。
上面的 I/O 分析只考虑单个程序实例与主存之间的传输。实际设备上同时驻留着数百个实例,它们共享 L2 缓存;同一时刻运行的实例若读取相同的输入块,这些块只需从主存读一次。实例的编号方式因此影响 L2 的命中率。
命题 9.4(分组编号) 设输出 $C$ 被划分为 $g_m \times g_n$ 个块,同时运行的实例为编号连续的 $W$ 个,$W \le g_m g_n$。按行顺序编号时,这 $W$ 个实例读取 $A$ 的 $\lceil W / g_n \rceil$ 个行块与 $B$ 的 $\min(W, g_n)$ 个列块。若按高度为 $G$ 的行组编号,即先在组内沿列向下、再沿行向右($G$ 整除 $W$,$W/G \le g_n$),则读取 $G$ 个行块与 $W/G$ 个列块。后者在 $G = \sqrt W$ 时取最小值 $2\sqrt W$。
证明 按行顺序编号时,编号 $0$ 至 $W-1$ 依次铺满前 $\lceil W/g_n \rceil$ 行;当 $W \ge g_n$ 时覆盖全部 $g_n$ 列,否则覆盖 $W$ 列。按组编号时,组内每 $G$ 个连续编号占据同一列的 $G$ 个行块,$W$ 个编号恰好覆盖 $G$ 行、$W/G$ 列。最后,$G + W/G \ge 2\sqrt W$,当且仅当 $G = \sqrt W$ 时取等。$\square$
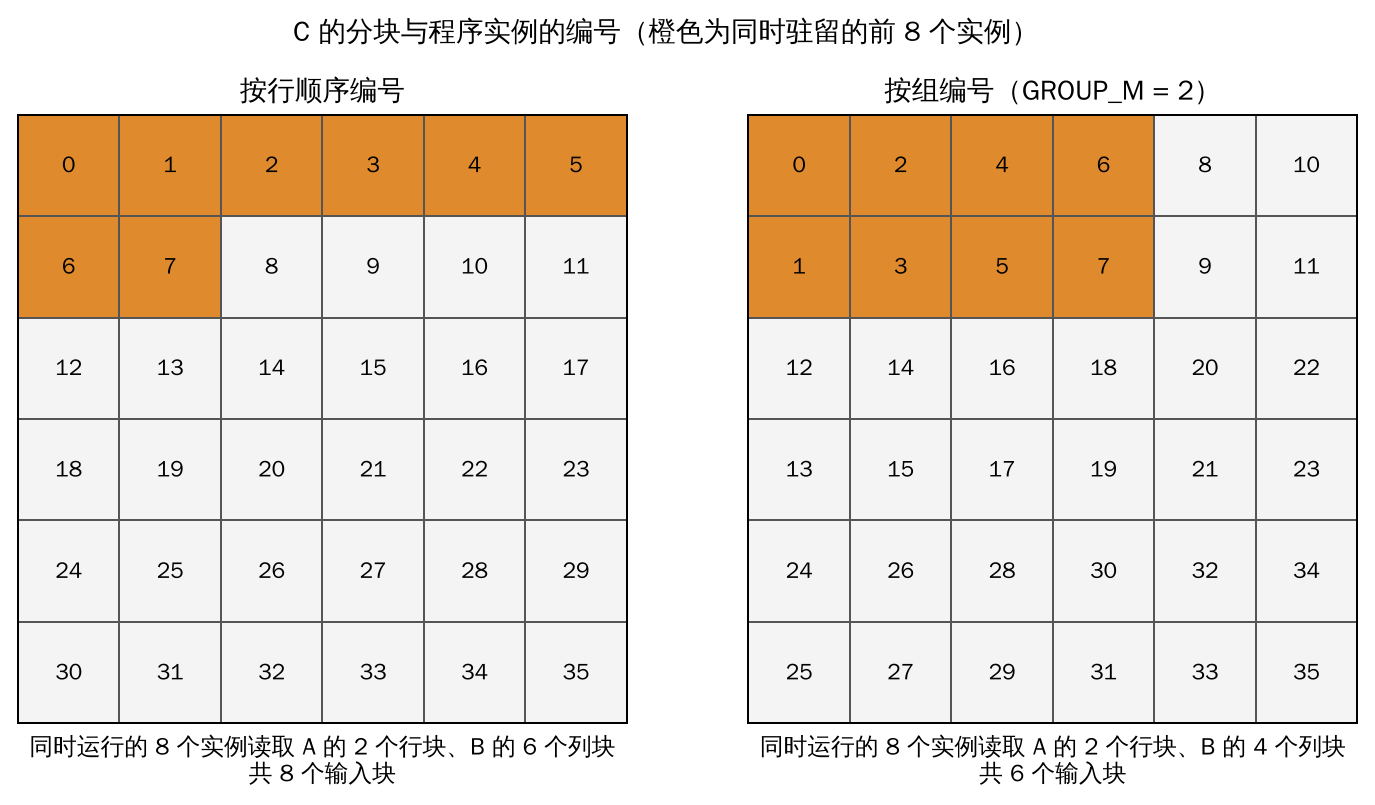
图 9.1 $6 \times 6$ 个输出块的两种编号方式。橙色为同时运行的前 8 个实例。按行编号时它们读取 $A$ 的 2 个行块与 $B$ 的 6 个列块;按 $G = 2$ 分组时只读取 2 个行块与 4 个列块。
以 $g_m = g_n = 32$、$W = 128$ 为例(约每个 SM 一个实例):按行编号需要 $4 + 32 = 36$ 个输入块,取 $G = 8$ 时只需 $8 + 16 = 24$ 个,接近下界 $2\sqrt{128} \approx 22.6$。Stax 的矩阵乘模板以 GROUP_M = 8 编号,由模板开头的几行实现:
width = GROUP_M * grid_n
group_id = pid // width
group_size = min(grid_m - group_id * GROUP_M, GROUP_M)
pid_m = group_id * GROUP_M + (pid % group_size)
pid_n = (pid % width) // group_size
group_size 处理最后一组不足 $G$ 行的情形。这一重排不改变任何实例的计算,只改变它们的启动次序,因此不影响结果,只影响缓存行为。
**张量核心与混合精度。**模板的内层循环是
acc = tl.dot(a, b, acc, allow_tf32=ALLOW_TF32, out_dtype=ACC_TYPE)
tl.dot 在操作数为 float16、bfloat16 或 float8 时由 Triton 编译为张量核心的矩阵乘累加指令;累加器类型 ACC_TYPE 恒为 float32,这与 6.2 节"半精度运算以 float32 进行"的原则一致。float32 操作数只在 ALLOW_TF32 为真时才走张量核心:TF32 把操作数的尾数截为 10 位,单次舍入的相对误差由 $2^{-24}$ 增大到约 $2^{-11}$,累加仍在 float32 中进行。是否允许由全局的矩阵乘精度设置决定,而不是由模板自行决定。
张量核心改变了矩阵乘在屋顶线上的位置。H100 上 BF16 稠密张量核心的标称算力约为 989 TFLOPS,脊点约为 $989 / 3.35 \approx 295$ FLOP/byte,是 FP32 非张量核心脊点的 15 倍(图 1.1 右)。按 $I_{\max} = 2n/(3b)$,$b = 2$ 的方阵乘要达到计算受限,至少需要 $n \ge 3 \times 295 \approx 885$;更小的矩阵乘即使用上了张量核心,仍受带宽限制。这也是尾部融合在张量核心时代更有价值的原因:矩阵乘本身越快,其后逐元素运算的访存占比越高。
**软件流水。**内层循环每一步都要把 $A$、$B$ 的一对子块从主存读入片上存储,再交给 tl.dot。若读取与计算串行,每一步都要等待一次完整的访存延迟。流水级数 num_stages 为 $s$ 时,片上为每个操作数准备 $s$ 份缓冲区,第 $t$ 步计算时,第 $t+1$ 至 $t+s-1$ 步的读取已经在途。按 9.1 节的利特尔法则,在途字节须达到 $\lambda B$ 才能使带宽饱和,增加 $s$ 正是增加每个实例的在途访存量。约束来自片上存储容量:每级占用 $(B_M + B_N) B_K b$ 字节。取 $B_M = B_N = 128$、$B_K = 64$、BF16,每级 32 KB;H100 每个 SM 可配置约 228 KB 的共享内存,扣除尾部所需后 $s$ 至多为 6 左右。$s$ 与块大小、线程束数一起进入 9.6 节的配置空间,由实测选择。
Hopper 及以后的设备另有张量内存加速器(TMA),以一条指令搬运整个子块并在完成时通知计算线程。Stax 为此提供了持久化的 TMA 模板(triton_persistent_tma_mm):网格大小取 SM 数,每个实例循环处理多个输出块,使一个块的尾部与下一个块的读取重叠。
9.9 CUDA Graphs
每次内核启动都有一段由主机完成的固定开销 $t_{\mathrm{launch}}$,量级为微秒。主机发出启动与设备执行内核是异步的,设一个区域由 $n$ 个内核组成,第 $k$ 个的设备执行时间为 $t_k$,则区域的执行时间约为
$$T \approx \max\Bigl(n \cdot t_{\mathrm{launch}},\ \sum_{k=1}^{n} t_k\Bigr).$$当内核短小、$n \cdot t_{\mathrm{launch}} > \sum t_k$ 时,设备在两次启动之间空闲,执行时间由主机决定。融合减少了 $n$,但不能消除这一项。CUDA Graphs 将一串内核启动录制为一张图,此后以一次调用整体提交,执行时间变为 $T_{\mathrm{graph}} \approx t_{\mathrm{graph}} + \sum t_k$,其中 $t_{\mathrm{graph}}$ 与 $n$ 基本无关。
录制的对象是一串确定的启动:每次启动的内核、网格与实参(包括设备指针)都被固定下来。重放与重新执行原程序等价,须满足以下条件:
- 原程序在新输入上执行的内核序列、网格与形状与录制时相同,即控制流与形状不依赖于数据。输出形状依赖数据的算子(如
nonzero、unique、masked_select)以及把设备上的值读回主机的算子(如item、tolist)都违反这一条件; - 新输入位于录制时的地址上,或者在重放前被复制到这些地址;
- 区域内的计算全部在同一块 GPU 上,不包含主机端的计算,也不跨设备。
这三条与第 2 节的特化有相同的结构:录制是对"内核序列与地址"的特化,条件 1 与 2 是其守卫。Stax 在包装前静态检查条件 1 与 3,并要求非动态形状模式;不满足时放弃包装,产物照常执行。条件 2 在每次调用时检查:实参的个数、形状与数据指针与录制时一致则重放,否则本次直接执行编译产物。录制或重放出错时,包装对象转入回退状态,此后始终直接执行编译产物。
重放的输出位于图专用的内存池中,下一次重放会写入同样的地址,因此调用方需要跨调用保留的结果须自行复制。
9.10 注意力
注意力是现代模型中最重要的一类算子组合。设单个头的查询、键、值为 $Q \in \mathbb R^{N\times d}$、$K, V \in \mathbb R^{N\times d}$,
$$S = \frac{QK^{\mathsf T}}{\sqrt d},\qquad P = \mathrm{softmax}(S)\ (\text{按行}),\qquad O = PV.$$按定义逐个算子执行时,$S$ 与 $P$ 都是 $N \times N$ 的矩阵,须写回主存再读出。序列长度 $N$ 远大于头维 $d$(常见的 $d$ 为 64 或 128,$N$ 为数千至数十万)时,这两个中间矩阵的访存远超输入输出本身。
定理 9.2(注意力的 I/O 复杂度 [33]) 设片上存储可容纳 $M$ 个元素,$d \le M \le Nd$。逐个算子计算注意力需要 $\Theta(Nd + N^2)$ 次主存访问;分块的单趟算法需要 $\Theta(N^2 d^2 / M)$ 次。并且,对 $[d, Nd]$ 中的一切 $M$,没有精确计算注意力的算法能在渐近意义下少于 $\Theta(N^2 d^2/M)$ 次。
证明梗概 逐个算子时,$S$ 与 $P$ 各写出并读入一次,贡献 $\Theta(N^2)$。分块算法把 $Q$ 按行分为大小 $B_r = \Theta(M/d)$ 的块,每块常驻片上,再沿 $K$、$V$ 的行方向分块扫描;每个 $Q$ 块须读完全部 $K$、$V$,即 $\Theta(Nd)$,共有 $N/B_r = \Theta(Nd/M)$ 个 $Q$ 块,总计 $\Theta(N^2 d^2/M)$。与逐算子实现的 $\Theta(N^2)$ 相比,比值为 $d^2/M$:片上容量 $M$ 远大于 $d^2$ 时,分块算法的访问量少 $M/d^2$ 倍。例如 $d = 64$、$M \approx 10^5$ 时约少 24 倍;$d = 128$ 时 $d^2 = 16384$,同样的 $M$ 只少约 6 倍,这也是头维越大、分块的收益越小的原因。下界的证明见 [33]。$\square$
分块算法能够成立,依据的正是 9.5 节的在线 softmax。对一行 $q$ 与一段键值 ${(k_j, v_j)}$,维护三元组
$$(m,\ \ell,\ \mathbf a) = \Bigl(\max_j s_j,\ \sum_j e^{s_j - m},\ \sum_j e^{s_j - m} v_j\Bigr),\qquad s_j = q \cdot k_j / \sqrt d .$$两段的合并为
$$(m_1, \ell_1, \mathbf a_1) \oplus (m_2, \ell_2, \mathbf a_2) = \bigl(\mu,\ \ell_1 e^{m_1 - \mu} + \ell_2 e^{m_2 - \mu},\ \mathbf a_1 e^{m_1 - \mu} + \mathbf a_2 e^{m_2 - \mu}\bigr),\qquad \mu = \max(m_1, m_2),$$扫描结束后 $o = \mathbf a / \ell$。按命题 9.1 的同一论证,这一运算满足结合律与交换律,只是第二、三分量都以同一个因子 $e^{m_i - \mu}$ 重新缩放。(这里以 $\mu$ 记最大值,以免与片上容量 $M$ 混淆。)于是注意力可以像规约一样沿键的方向分块、累加与拆分:$S$ 与 $P$ 只以 $B_r \times B_c$ 的块出现在片上,从不写回主存(图 9.2)。
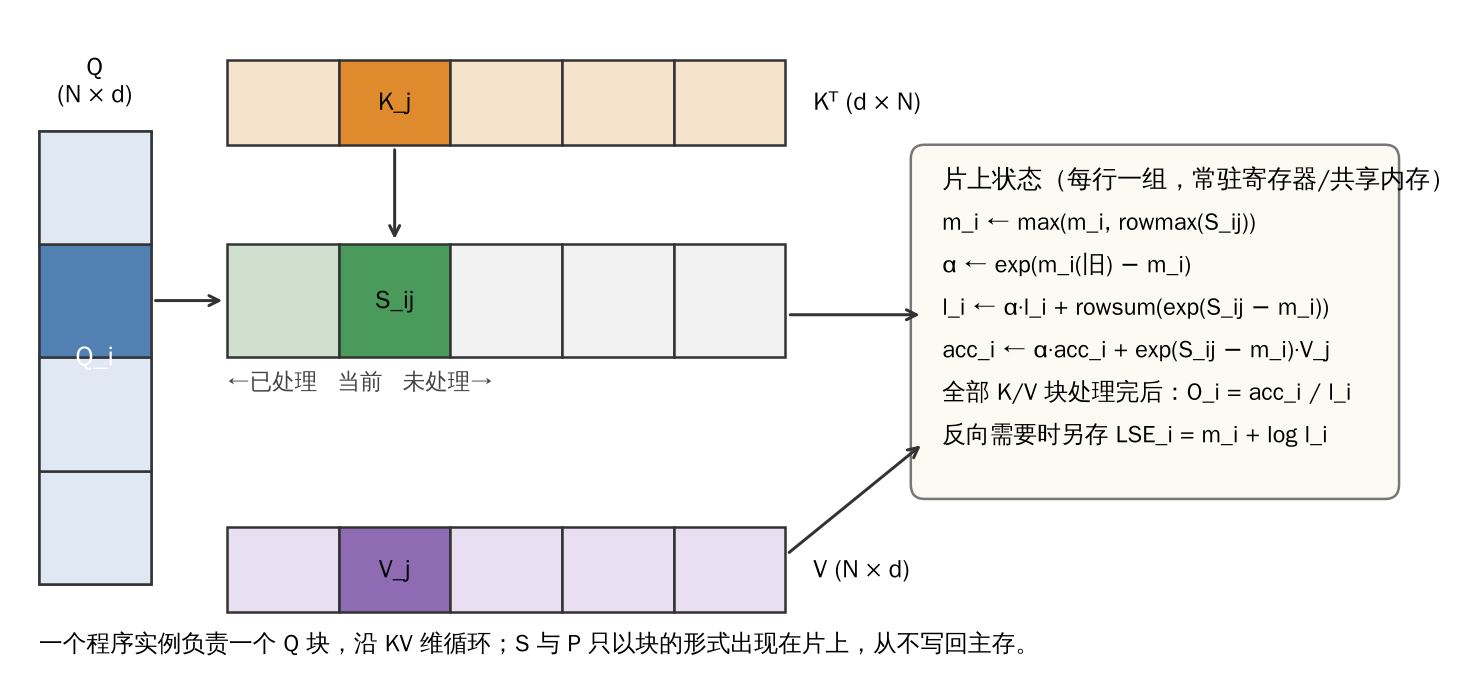
图 9.2 分块注意力的单个程序实例。实例负责一个 $Q$ 块,沿键值方向逐块计算 $S_{ij}$,并以在线 softmax 更新片上状态 $(m_i, \ell_i, \mathrm{acc}_i)$。
**反向与重物化。**反向需要 $P$。保存 $P$ 要 $\Theta(N^2)$ 的存储,正是分块算法想要避免的。做法与第 5 节相同:不保存 $P$,只保存每行的 $\mathrm{LSE}i = m_i + \log \ell_i$($\Theta(N)$ 个数),反向时由 $Q$、$K$ 与 LSE 重算 $P{ij} = \exp(S_{ij} - \mathrm{LSE}_i)$。这是 5.4 节"以计算换存储"的一个极端例子:重算的代价是一次额外的 $QK^{\mathsf T}$,换来的是存储从平方降为线性。不同之处在于,这一决策写在注意力的模板里,而不是由最小割在联合图上自动作出:最小割只能在已有的节点之间选择保存哪些,无法发明"保存 LSE 而不保存 $P$“这种新的中间量。
**Stax 中的注意力。**注意力有两条进入 Stax 的路径。
第一条是模式匹配。用户手写的 softmax(q @ k.transpose(-2, -1) / s) @ v 一类写法,在算子级的图上被识别出来,改写为 scaled_dot_product_attention 算子,再交给专门的实现。Stax 维护 30 个这样的模式(graph_passes/fuse_attention.py),覆盖缩放写在乘法或除法上、带或不带 dropout、带加性掩码、键先转置或后转置等变体,其中一部分只在推理时启用。模式匹配的局限也很明显:用户的写法只要稍有不同,例如在 softmax 之前加一个位置偏置,就不再匹配,退回逐算子的融合,$S$ 与 $P$ 仍要写回主存。
第二条是 omni_attention,它把"注意力的变体"本身变为可编程的接口。用户以两个函数描述变体:score_mod(score, b, h, q_idx, kv_idx) 修改每个分数,mask_mod(b, h, q_idx, kv_idx) 判定一个位置是否参与。
代码清单 9.7 以 omni_attention 表达带 ALiBi 偏置的因果注意力
from tensorplay.nn.attention.omni_attention import omni_attention, create_block_mask

def causal(b, h, q_idx, kv_idx):
    return q_idx >= kv_idx

def alibi(score, b, h, q_idx, kv_idx):
    slope = tp.exp2(-(h + 1).to(tp.float32))       # 每个头一个斜率
    return score - slope * (q_idx - kv_idx)

block_mask = create_block_mask(causal, B=None, H=None, Q_LEN=4096, KV_LEN=4096, device="cuda")
out = tp.compile(omni_attention)(q, k, v, score_mod=alibi, block_mask=block_mask)
编译时,score_mod 与 mask_mod 各被追踪为一张小图,降级为循环级的计算函数,再作为子图嵌入注意力模板:分数块 $S_{ij}$ 算出之后、在线 softmax 之前,模板对块中的每个元素调用这段计算函数。这与 9.8 节矩阵乘的尾部融合是同一种机制,只是融合点在模板的中间而不是末尾。反向模板同样嵌入这两个函数,并对 score_mod 自动求导。
mask_mod 若逐元素求值,被屏蔽的位置仍要算出分数再丢弃,没有节省任何计算。create_block_mask 因此在调用注意力之前预先处理掩码:它在全部 $N^2$ 个位置上求值一次 mask_mod,得到稠密的布尔掩码,再按块(默认 $128 \times 128$)归约,把每个块分为三类:全部可见的完整块、部分可见的部分块、全部屏蔽的空块,并以类似 BCSR 的格式记录每个 $Q$ 块需要访问的 KV 块编号(kv_num_blocks、kv_indices,完整块另记于 full_kv_num_blocks、full_kv_indices)。模板只遍历非空块,并且只在部分块上调用 mask_mod(图 9.3)。
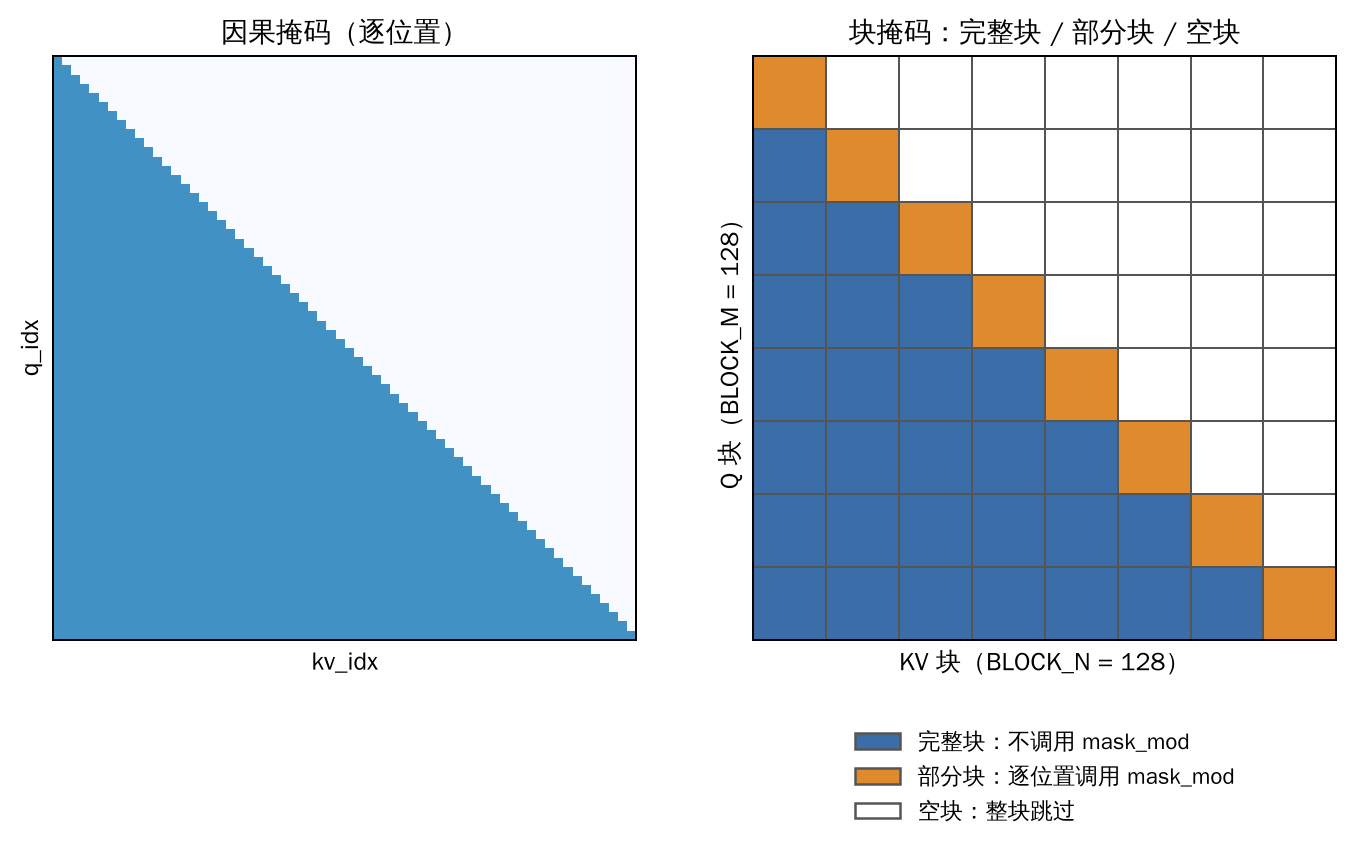
图 9.3 因果掩码的块结构。左:逐位置的掩码。右:$8 \times 8$ 个块中,对角线上的 8 个为部分块,下三角的 28 个为完整块,上三角的 28 个为空块。
对因果掩码,设每边有 $n$ 个块,需要计算的块占 $(n+1)/(2n)$,约为一半;其中只有对角线上的 $n$ 个块需要求值 mask_mod,占全部块的 $1/n$。构造块掩码要付出一次 $O(N^2)$ 的求值,但构造结果的大小只有 $O(n^2)$;它与具体的 $Q$、$K$、$V$ 无关,同一个掩码可以在多层、多步之间复用,构造的代价因而被摊薄。
注意力模板有几种实现,按设备与形状选择:通用的 Triton 模板(omni_attention.py.jinja);查询很短的解码场景下,沿 KV 方向拆分以增加并行度的解码模板(拆分的依据仍是在线 softmax 的结合律,与 6.5 节的规约拆分相同);基于 CuTe DSL 的 FlashAttention 模板(实验性);以及 CPU 上的 C++ 模板。用户可以通过 kernel_options={"BACKEND": ...} 指定其一,指定的实现不可用时报错而不是静默回退,这与 11.3 节严格模式的取向一致。
10 动态形状
前面各节都把形状当作特化键的一部分(2.2 节):形状不同的输入得到不同的特化版本,每个版本内的形状是常量。这使降级与代码生成可以把形状代入下标、循环范围与各种启发式判据之中。代价是,形状经常变化的程序,例如批大小或序列长度随输入变化的程序,每遇到一种新形状就要重新编译一次。本节讨论如何让一个编译产物覆盖一类形状,以及这对编译栈的各层提出了什么要求。
10.1 形状的抽象层次
定义 10.1(形状抽象) 形状抽象是形状空间上的一个等价关系,特化键中的形状分量取输入形状所在的等价类。按由细到粗的次序,常见的形状抽象有三种:
- 具体形状:两个形状等价当且仅当相等;
- 符号形状:指定某些维度为可变,其余维度取具体值,可变维度在声明的范围内满足同一组约束的形状彼此等价;
- 秩:两个形状等价当且仅当维数相同。
抽象越粗,一个特化版本覆盖的输入越多,编译次数越少;但编译器在每个版本内能利用的形状信息也越少。粗化并不总是允许的,命题 2.1 给出了约束。
命题 10.1(泛化的可靠性) 设形状分量取某一形状抽象下的等价类。以此为键复用编译产物是可靠的,当且仅当每个编译产物对其等价类中的一切形状都与原函数等价。
证明 命题 2.1 的结论只对键相同的输入成立。键相同的输入可以具有等价类中的任何形状,因此产物须对整个等价类有效;反之,若产物对整个等价类有效,复用即与重新编译得到相同的结果。$\square$
命题 10.1 说明,泛化特化键只是问题的一半,另一半是编译产物本身须对一类形状有效,即生成的代码是形状多态的。前者是前端的事,后者涉及编译栈的每一层。
10.2 符号形状与形状守卫
符号形状为每个可变维度引入一个符号 $s$,它带有两个附加信息:追踪时样例输入的实际大小,称为提示值;以及声明的取值范围 $[l, u]$。追踪中对形状的算术保持符号形式,例如把 $s \times 128$ 的张量展平,得到的长度是 $128 s$。当 Python 代码需要对一个符号作出判断,例如分支 if x.shape[0] > 32,追踪器按提示值求出真假,沿相应的分支继续,并把所作的判断记为一个约束。这与 3.4 节对数据相关控制流的处理相同,只是判断的对象由张量的数据换成了张量的形状,所记录的约束正是 King 意义下的路径条件 [6]。
定义 10.2(形状守卫) 追踪过程中对符号所作的全部判断构成一个合取式 $\Gamma(s_1, \dots, s_k)$,称为形状守卫。编译产物对满足 $\Gamma$ 且各符号在声明范围内的一切形状有效。
追踪结束后,每条守卫要对照声明的范围加以判定。判定用的正是 6.8 节的区间推理,结果有三种:
- 范围蕴含该守卫,例如声明 $s \in [2, 4096]$ 而守卫为 $s \ge 1$,守卫被删去;
- 范围中有一部分值违反该守卫,而声明者要求整个范围有效,编译报错,并给出能使声明成立的更窄的范围;
- 其余情形,守卫被保留为编译产物在运行时的断言。
例 10.1 以 tensorplay.export 导出
def f(x, w):
    y = (F.relu(x + w) * 2).sum(-1)
    return y / x.shape[0]
声明 x 与 w 的第 0 维为同一个符号 $n \in [2, 4096]$。导出的图为(省略了计数注释):
add = x + w
relu = tensorplay_nn_functional_relu(add)
mul = relu * 2
sum_0 = mul.sum(-1)
getattr_0 = getattr_1(x, 'shape')
getitem = getattr_0[0]
truediv = sum_0 / getitem
_assert_dims_equal = tensorplay_export__trace__assert_dims_equal(w, 0, x, 0, 'n')
_assert_dim_range = tensorplay_export__trace__assert_dim_range(w, 0, 2, 4096, 'n')
return truediv
x.shape[0] 没有被替换为样例中的 64,而是作为图中的节点保留下来,每次调用时读取实际的大小。图的末尾是两条运行时断言:x 与 w 的第 0 维相等,且在 $[2, 4096]$ 之内。以第 0 维为 10 的输入调用,结果的形状为 $(10,)$。
例 10.2 若函数中有分支 if x.shape[0] > 32:,而声明 $n \in [2, 4096]$,样例的 64 使追踪进入真分支,守卫为 $n > 32$。该守卫被范围中的一部分值违反,导出报错:
Constraints violated (n)! The captured program holds only for some of the declared sizes:
  - Not all values of n in [2, 4096] satisfy the guard n > 32, which the program was captured under
Suggested fixes:
    n = Dim('n', min=33, max=4096)
按建议把声明改为 $n \in [33, 4096]$ 后,守卫被范围蕴含,导出成功,图中只保留真分支,末尾的范围断言变为 $[33, 4096]$。
符号形状还带来一个特殊的困难:大小为 1 的维度。广播的语义依赖于维度是否等于 1。设 $x$、$y$ 的第 0 维分别为符号 $p$、$q$,x + y 的结果形状为:$p = q$ 时为 $p$;$p = 1$ 时为 $q$;$q = 1$ 时为 $p$;否则报错。若不加限制,每个二元运算都要对符号作情形分析。
命题 10.2 若可变维度的取值都不小于 2,则 $p$ 与 $q$ 可以广播当且仅当 $p = q$,结果的大小为 $p$。
证明 $p, q \ge 2$ 时,$p = 1$ 与 $q = 1$ 两种情形都不发生,只剩 $p = q$ 一种可能。$\square$
TensorPlay 的导出在作这类判断时,假定每个可变维度至少为 2,由此按命题 10.2 得到 $p = q$,并把它记为守卫。由于这一假定本身没有被声明,守卫按上面的第 3 种情形保留为运行时断言。
例 10.3 导出 b(x, y) = x + y,两个输入的第 0 维各自声明为可变。所得的图为:
add = x + y
getattr_0 = getattr_1(x, 'shape')
getitem = getattr_0[0]
getattr_2 = getattr_1(y, 'shape')
getitem_0 = getattr_2[0]
eq = getitem == getitem_0
_assert_shape_guard = tensorplay_export__trace__assert_shape_guard(eq, True, 'x.size()[0] == y.size()[0]')
return add
广播规则引入的守卫 $p = q$ 成为一条运行时断言。另一种处理方式是把 0 与 1 两个大小一律按具体值特化,只对 2 及以上的大小使用符号,PyTorch 2 采用这一做法 [15]。二者的差别在于大小为 1 的输入:前者在运行时断言失败,后者为其另编译一个版本。TensorPlay 的导出采用前者;compile 的动态模式采用后者(10.4 节)。
10.3 后端的符号化
前端得到符号形状的图之后,后端须生成对整个范围有效的代码。这影响到第 6 至第 9 节的几乎每一个决策。
第一,下标表达式成为符号的多项式。形状为 $(s, 128)$ 的连续张量,步长为 $(128, 1)$,下标为 $128 i_0 + i_1$;形状为 $(128, s)$ 时,步长为 $(s, 1)$,下标为 $s, i_0 + i_1$,系数本身是符号。命题 6.3 的合并条件 $a_j = s_{j+1} a_{j+1}$ 此时须在符号意义下判定。
第二,循环范围成为运行时参数。内核的元素数不能再写为常量,须作为参数传入;由于 $s$ 是否为块大小的整数倍未知,边界掩码不能省去。
第三,依赖于大小的判断须对整个范围成立。这类判断是三值的:对范围内的一切取值都成立、都不成立、或无法确定。设下标表达式在各循环变量取最大值时的值为各符号的非负系数多项式 $e(s_1, \dots, s_k)$,它关于每个符号单调不减,于是
$$\max_{s_i \in [l_i, u_i]} e(s_1, \dots, s_k) = e(u_1, \dots, u_k).$$32 位下标的判据 $\max e < 2^{31}$ 因此只需代入各符号的上界。若某个符号没有上界,判据无法确定,只能使用 64 位下标,或者加入一条守卫 $e < 2^{31}$,把超出的形状排除在该版本之外。持久化规约(9.4 节)要求规约长度不超过上限,同样须对范围的上界判定;规约拆分的段数(算法 6.1)与实体化的阈值依赖于具体的大小,则只能按提示值选择,所选的方案对范围内的一切形状都正确,但未必都最优。
第四,启动配置按提示值实测。算法 9.1 的测量在提示值对应的形状上进行,所选配置对其他形状同样正确,性能则不作保证。CUDA Graphs 要求形状固定(9.9 节的条件 1),与符号形状不相容。
由此可见,符号形状以正确性为先:凡是依赖于大小的优化,要么对整个范围成立,要么被守卫限定,要么退回保守的做法。形状多态的产物换来了更少的编译次数,代价是常量下标、无掩码的循环与按形状定制的配置。
10.4 TensorPlay 中的处理
TensorPlay 的 compile 默认采用具体形状。参数 dynamic=True 把特化键中的形状分量粗化为秩。按命题 10.1,这一粗化是否可靠取决于后端能否生成形状多态的产物,因此 TensorPlay 按后端是否声明支持符号捕获(supports_symbolic_shapes)分两种处理。
不支持符号捕获的后端,例如 11.4 节的调试后端,区域仍按 3.3 节的执行期采样追踪,并附加一条修正:若函数读取了某个输入的 shape、len 或 ndim,该输入的完整形状重新进入特化键,因为追踪时读得的大小已作为常量写入了图。这类后端逐个调用算子执行,产物本身就是形状多态的。
Stax 声明支持符号捕获,dynamic=True 下的处理分为捕获、降级、守卫与缓存四步。
捕获。 区域由符号形状追踪器捕获:每个输入张量的每个维度引入一个符号,提示值取样例中的大小。大小为 0 或 1 的维度不引入符号,按具体值特化,即 10.2 节末尾所说的第二种做法。读取 shape、size() 与 numel() 得到的是符号表达式,形状算术保持符号形式,例如 x.reshape(x.size(0), -1) 中推断出的维度是运行时的整除。对形状的判断按提示值求值,沿相应的分支继续,并记为定义 10.2 的守卫。于是读取形状不再使完整形状进入特化键;只有嵌套在元组、列表等容器中的张量输入,以及输出元数据为具体值的外部调用,仍以具体形状特化。
降级。 降级在一个形状环境中进行,下标、循环范围与步长都是 10.3 节所说的符号表达式。CPU 内核(C++)与 GPU 内核(Triton)共用同一套降级规则与形状环境,因此二者同时获得形状多态性:每次调用时,生成的内核从实参中绑定大小与步长。切片保留符号的长度、步长与偏移,包括正步长、负的边界以及由输入大小计算出的边界;整数索引与 select 以守卫保证下标落在范围内;返回的视图与输入共享存储。
守卫。 每个产物带有一个守卫函数,它是两部分的合取:
- 捕获守卫:追踪中对形状所作的判断(定义 10.2 的 $\Gamma$),以及按具体值特化的维度(大小为 0 或 1);
- 输入守卫:降级中作出的布局假定,包括每个输入的秩与存储偏移,各维的大小与步长等于相应的符号表达式,每个符号维度不小于 2,以及降级过程中形状环境记录的守卫与运行时断言。
两部分都在编译时生成为一个只读取元数据的 Python 函数,不持有样例张量。前向捕获时提示值相同的维度共用一个符号,这一相等本身是输入守卫的一部分,不会被未经检查地假定。
缓存。 动态模式下的特化键不含大小,同一个键下可以挂多个产物,各对应一组不同的守卫。调用时先取键对应的产物检查其守卫;不成立时,在同键的其他产物中寻找守卫成立的一个;都不成立才重新编译。所有产物都计入特化次数的上限;达到上限后,除非设置了 fullgraph(此时报错),新编译的产物照常执行,但不再存入缓存,每次未命中都要重新编译,直到累计编译次数的上限(2.4 节)。
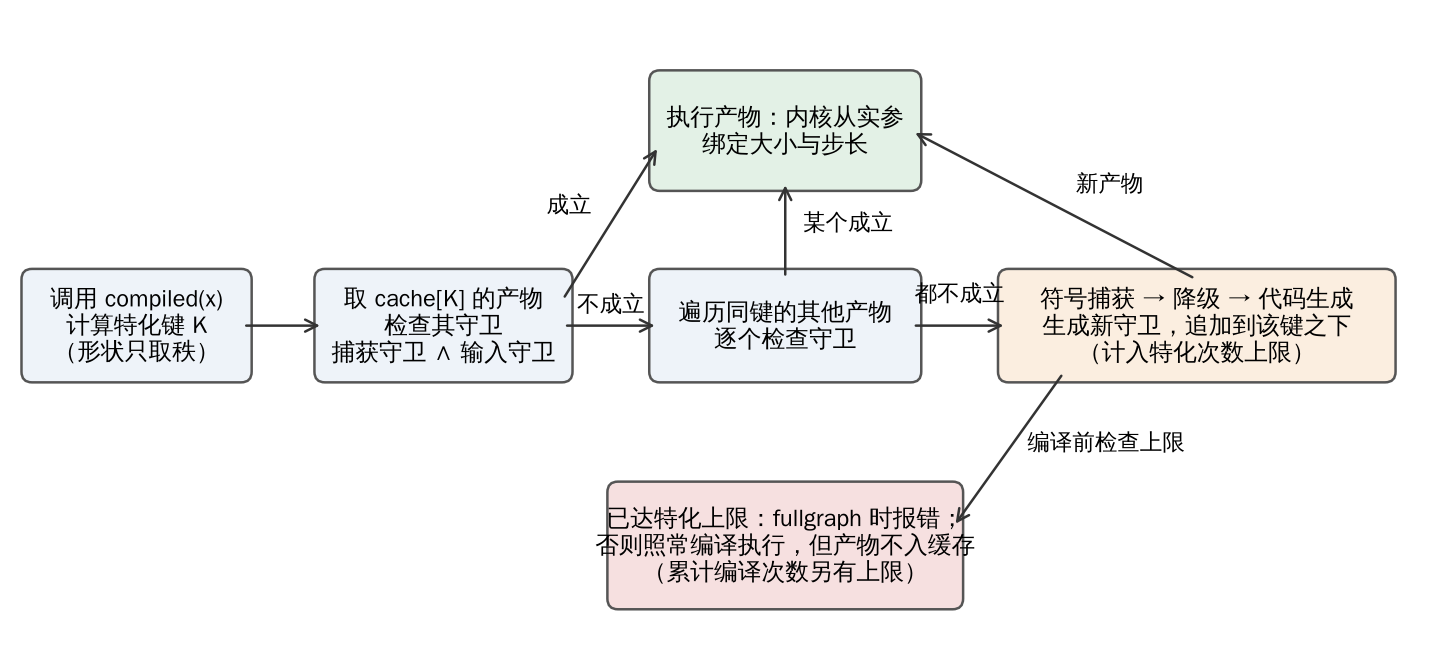
图 10.1 动态模式下一次调用的分派。同一个特化键下可以有多个产物,各带一组守卫。
例 10.4 对
def fn(x):
    return x + 1 if x.shape[0] > 4 else x * 2

compiled = tp.compile(fn, dynamic=True, strict_native=True)
for n in (3, 7, 2, 9, 4, 11):
    compiled(tp.arange(n, dtype=tp.float32))
六次调用只生成两个产物。$n = 3$ 时捕获,守卫为 $n \le 4$;$n = 7$ 时该守卫不成立,重新捕获,得到守卫为 $n > 4$ 的版本;此后各次调用都命中这两者之一。同理,lambda x: x * 2 + 1 依次以大小 3、1、0、7、1、0、11 调用,生成三个产物,分别对应 $n \ge 2$、$n = 1$ 与 $n = 0$;对一个连续张量与它的转置交替调用,步长关系不同,生成两个产物。
训练。 训练区域经 5 节的联合图与划分,前向与反向各降级为一个形状多态的产物,兼容的尺寸共用这一对产物。反向需要的维度不以常量写入,而作为符号标量值由前向保存;每次前向调用保存自己的维度,供之后对应的反向调用使用。反向图的各输入维度相互独立,即使它们在样例上的值恰好相等也不合并为同一符号。梯度公式(config/derivatives.yaml 与 TPX 的原生节点)相应改为按符号大小计算,涵盖逐元素运算、sum 与 mean 规约、广播、reshape 与 expand、squeeze、切片与 select、unflatten、对角线与 repeat;方差与标准差的梯度,包括同时输出均值的情形,以运行时的维度计算规约计数。产物退回解释执行时,TPX 的原生梯度同样按运行时的维度计算。
仍会退回按尺寸特化的情形有三类:梯度公式保存了具体的形状元数据、标量操作数或由形状派生的算子参数,例如 (x / x.shape[0]).sum(),这些值变化时选择另一个带守卫的版本;方差的修正项大于 1 时,为保持对非正自由度的判断而特化;广播方式或步长布局不同时,如例 10.4 所示,选择另一个产物。
回退与限制。 不加 strict_native=True 时,无法生成代码的区域以解释方式执行其图,捕获守卫照常检查;加上之后改为报错(11.3 节)。CUDA Graphs 要求形状固定,动态模式下不作包装(9.9 节)。符号捕获也可以通过 make_graph(..., tracing_mode="symbolic") 单独使用,但该入口尚不支持无存储的伪张量追踪,也不支持输出大小依赖于数据的算子。10.2 节的导出仍是另一条路径:它按声明的范围判定守卫,并把大小为 1 的情形留作运行时断言。
在具体形状的模式下,以及对上述仍须特化的维度,限制编译次数的常用方法是分桶:把可变的维度向上补齐到少数几个预先选定的大小。
命题 10.3 设可变维度的取值在 $[m, M]$ 中,$m \ge 1$,以 2 的幂为桶,把大小 $n$ 补齐为 $2^{\lceil \log_2 n \rceil}$。则特化版本至多为 $\lceil \log_2 M \rceil - \lfloor \log_2 m \rfloor + 1$ 个,且补齐后的大小小于 $2n$。
证明 补齐后的大小取值于 ${2^j : \lfloor \log_2 m \rfloor \le j \le \lceil \log_2 M \rceil}$,个数如所述。又 $2^{\lceil \log_2 n \rceil} < 2^{\log_2 n + 1} = 2n$。$\square$
补齐的元素须以掩码或单位元处理,使其不影响结果,例如在规约中填以单位元,在注意力中以掩码屏蔽。命题 10.3 给出了编译次数与冗余计算之间的一种权衡:桶的公比越小,冗余越少,版本越多。
10.5 依赖于数据的形状
前面讨论的符号都来自输入的形状,追踪时有样例中的提示值可用。另有一类算子,其输出形状取决于输入的数据:nonzero 的输出行数是非零元素的个数,unique 的输出长度是不同值的个数,masked_select 的长度是掩码中真值的个数。这类大小在追踪时可以从样例算出,但样例上的值没有任何代表性:下一次调用的非零个数与这一次毫无关系。
处理这类大小的标准做法是引入无提示的符号 $u$(PyTorch 2 称为 unbacked symbol):它只携带已知的约束,例如 $0 \le u \le N$,而不带样例值。对 $u$ 的任何判断都不能按样例求值,只能有两种结果:由已知约束推出(例如 $u \ge 0$ 时 u >= 0 恒真),或者无法确定。无法确定的判断不能变成守卫,因为守卫是按样例取值记录的路径条件,而 $u$ 没有样例;它只能报错,或者要求用户以 tensorplay._assert 一类的断言显式给出约束,把判断变为一条运行时检查。
命题 10.4 设符号 $u$ 只携带约束集合 $\mathcal C$。若编译器只在 $\mathcal C \models \varphi$ 或 $\mathcal C \models \neg\varphi$ 时作出判断 $\varphi$,否则拒绝编译,则对一切满足 $\mathcal C$ 的 $u$,编译产物的执行路径与原程序相同。
证明 编译器作出的每个判断在满足 $\mathcal C$ 的一切 $u$ 上取同一真值,因此产物所沿的路径对这些 $u$ 都是原程序实际会走的路径。由命题 2.1 的论证,产物与原程序等价。$\square$
命题 10.4 的条件比形状守卫严格得多:形状守卫允许"按样例作出判断、事后检查”,无提示的符号只允许"事前就能证明的判断"。这使依赖于数据的形状在后端中处处受限。例如,x[nonzero(x)] 之后的逐元素运算,其循环范围为 $u$,可以照常生成带掩码的循环;但若后续代码要比较 $u$ 与某个常数以选择规约策略,比较无法确定,编译器只能取对一切 $u$ 都正确的保守方案。
TensorPlay 目前的处理更简单。Stax 的降级把 nonzero、unique、bincount 等算子注册为回退内核(6.1 节),由框架原样执行,其输出形状在运行时确定;回退内核之后的部分仍可编译,但其中依赖该大小的形状只能按具体值特化。10.4 节的符号捕获入口不支持输出大小依赖于数据的算子(make_graph(..., tracing_mode="symbolic") 对它们报错)。对这类算子,9.9 节的 CUDA Graphs 同样不适用,因为输出大小在录制时无法固定。
上一节:第三节 调度、融合与 CPU 代码生成 | 目录 | 下一节:第五节 缓存、讨论、模型与测量;小结与习题