上一节:第二节 自动微分与降级 | 目录 | 下一节:第四节 GPU 代码生成与动态形状
文中参考文献编号 [n] 见第六节;章节号、定理号与习题号全章统一编号,跨节引用照常有效。
7 调度与融合
降级完成后,每个写入内存的缓冲区都是一个潜在的内核。调度器(scheduler)决定这些缓冲区按什么顺序计算、哪些合并为同一个内核,并为代码生成提供依赖与生命周期信息。6.3 节的函数复合已经完成了逐元素运算之间的融合;本节讨论的融合发生在已实体化的缓冲区之间,例如规约与其后的广播运算、读取同一输入的多个规约。
7.1 依赖
调度器为每个缓冲区建立一个调度节点,以记录读写的处理器执行其计算函数(6.7 节),得到它读取与写入的位置。
定义 7.1(依赖) 节点 $b$ 对节点 $a$ 的依赖记为 $a \to b$,表示 $b$ 必须在 $a$ 之后执行。依赖有三种:内存依赖记录被访问的缓冲区、访问的下标表达式与各循环变量的范围;整体依赖只记录缓冲区,用于无法分析下标的外部调用;弱依赖不传递数据,只约束先后,用于保证读取一个缓冲区的节点排在原地改写它的节点之前。
内存依赖中的下标是融合判定的依据:若 $b$ 读取 $a$ 写出的位置,且二者的下标表达式在同一循环变量下相同,则 $b$ 的每次迭代所需的数据恰由 $a$ 的同一次迭代产生,二者可以合并为一个循环,中间值不必离开寄存器或缓存。每个节点还记录其迭代分组,即(逐元素范围,规约范围)二元组。
迭代分组决定了两个节点能否共用一个循环嵌套。
定义 7.2(迭代空间的兼容) 设节点的迭代分组为 $(n, r)$,其中 $n$ 为逐元素迭代的元素数,$r$ 为每个输出所规约的元素数,逐元素节点的 $r = 1$。称两个节点的迭代空间兼容,若下列条件之一成立:
- 二者同为规约,且 $n_1 = n_2$、$r_1 = r_2$;
- 二者同为逐元素节点,且 $n_1 = n_2$;
- 一个为逐元素节点 $(N, 1)$,另一个为规约 $(n, r)$,且 $N = n$,或 $N = n r$ 且逐元素节点的迭代范围可以拆分为 $n \times r$ 的两组。
条件 3 的两种情形分别对应规约前后的两类逐元素运算。$N = n$ 时,逐元素运算每个输出做一次,例如对行和取倒数;$N = nr$ 时,逐元素运算与规约遍历同样多的元素,例如例 7.1 中对每行的每个元素除以行和。后者要求逐元素节点的迭代范围能按规约的形状拆开:例 7.1 中 $64 \times 128$ 的逐元素节点恰好可以拆为 64 个输出、每个 128 个元素。GPU 后端以元素数判定兼容;CPU 后端保留完整的各维范围,按外层循环是否一致判定(例 7.1、例 7.2)。
原地修改以重命名处理:若某个内核改写了缓冲区 buf0 并产生 buf1,则其后对 buf0 的使用均视为对 buf1 的使用。这与 SSA 的构造同理,使依赖图保持无环。
例 7.1 设 k(x) = x / x.sum(-1, keepdim=True),$x$ 的形状为 $64\times128$。降级后有两个节点,融合前的依赖如下(CPU,省略了前缀与部分字段):
op0: SchedulerNode(ComputedBuffer)                     # 按行求和
op0.writes = [MemoryDep('buf1', c0, {c0: 64})]
op0.met_dependencies = [MemoryDep('primals_1', c0, {c0: 8192})]
op0.group.iteration = ((64,), (128,))

op1: SchedulerNode(ComputedBuffer)                     # 逐元素相除
op1.writes = [MemoryDep('buf2', c0, {c0: 8192})]
op1.unmet_dependencies = [MemoryDep('buf1', c0, {c0: 64})]
op1.met_dependencies = [MemoryDep('primals_1', c0, {c0: 8192})]
op1.group.iteration = ((64, 128), ())
op0 是规约,迭代分组为 64 个输出、每个规约 128 个元素;op1 是逐元素运算,迭代分组为 $64\times128$、无规约。op1 对 buf1 的依赖尚未满足,因此必须排在 op0 之后。依赖中的下标已被规范化:primals_1 的二维下标 128*i0 + i1 被合并为一维的 c0,范围为 8192。
7.2 融合问题
定义 7.3(融合方案) 设依赖图为 $D = (V, E)$。$V$ 的一个划分 $\mathcal P = {P_1, \dots, P_m}$ 称为融合方案,若:
- 每个块 $P_j$ 中的节点两两具有兼容的迭代空间(定义 7.2),可以生成为同一个内核;
- 把每个块收缩为一个顶点后得到的商图 $D / \mathcal P$ 无环。
融合方案的代价为各内核与主存之间的传输量之和。
条件 2 保证各内核存在一个合法的执行顺序:若商图有环,则两个内核互为前驱,无论先执行哪一个,都有数据尚未产生。最小化代价的融合方案一般是 NP 难的 [20, 55]。下面在定义 7.3 的计价方式下给出一个完整的证明。抽去迭代空间的细节,把不能放进同一个块的节点对记为禁止融合的节点对,它们来自迭代空间的不兼容(定义 7.2)或非法的依赖距离(7.2 节后文的命题 7.3)。一个缓冲区若有使用者不在其生产者的块中,就要写出一次,并被每个包含其使用者的其他块各读入一次。
定理 7.1(融合的 NP 难性) 给定有向无环图、各节点输出的大小与一组禁止融合的节点对,判定是否存在代价不超过 $K$ 的融合方案是 NP 完全的。即使图中每条边都从一个源点指向一个汇点,且只有三对禁止融合的节点,结论仍然成立。
证明 属于 NP:给定划分,检查禁止对、商图的无环性并计算代价,都是多项式的。
NP 难:由三终端的多路割问题归约。该问题给定带非负边权 $w$ 的无向图 $H = (V, E)$ 与三个终端 $s_1, s_2, s_3$,问是否存在权和不超过 $K’$ 的边集 $E’$,使删去 $E’$ 后三个终端两两不连通;它是 NP 完全的 [41]。构造 $D$:每个顶点 $v \in V$ 对应一个汇点 $n_v$,输出大小为 0;每条边 $e = {u, w}$ 对应一个源点 $x_e$,它是一个计算节点(只读取一个大小为 0 的外部输入),输出大小为 $w(e)$,被 $n_u$ 与 $n_w$ 读取;禁止对为 ${n_{s_i}, n_{s_j}}$,$i < j$。取 $K = 2K’$。只需证明最小融合代价恰为最小多路割权和的 2 倍。
($\ge$)任取可行的融合方案。按 $n_v$ 所在的块把 $V$ 分组,三个终端分属不同的组。令 $E’$ 为两端点分属不同组的边之集,$H - E’$ 中每个连通分支都在同一组内,故 $E’$ 是多路割。对每个 $e \in E’$,$x_e$ 的两个使用者在不同的块中,至少一个不在 $x_e$ 的块中,$x_e$ 的缓冲区须写出一次、读入至少一次,代价不小于 $2w(e)$。故方案的代价不小于 $2w(E’)$,从而不小于最小多路割权和的 2 倍。
($\le$)任取多路割 $E’$,把 $H - E’$ 的连通分支任意编号为 $1, \dots, r$,记 $\mathrm{comp}(v)$ 为 $v$ 所在分支的编号。令第 $j$ 块为 ${n_v : \mathrm{comp}(v) = j} \cup {x_e : e = {u, w},\ \min(\mathrm{comp}(u), \mathrm{comp}(w)) = j}$。三个终端在不同的分支中,禁止对得到满足。跨块的边都是从 $x_e$ 指向端点 $n$,前者所在块的编号是两个端点编号的较小者,故每条跨块的边都从编号小的块指向编号大的块,商图无环。两端点在同一分支的 $x_e$ 与其使用者同块,代价为 0;两端点在不同分支的边必属于 $E’$,代价为 $2w(e)$。故方案的代价不超过 $2w(E’)$。$\square$
定理 7.1 允许任意给定的禁止对;Stax 中的禁止对由迭代空间与依赖距离决定,带有更多结构,这一受限的问题类是否仍然是 NP 难的,定理没有回答(习题 45)。实践中,Stax 采用贪心算法,每次合并一对节点,并维持条件 2。
合并一对节点何时会破坏无环性?下面的命题给出了判别方法。
命题 7.1 设 $D$ 为有向无环图,$a, b \in V$。将 $a$ 与 $b$ 合并为一个顶点后,所得的图有环,当且仅当在 $D$ 中存在一条从 $a$ 到 $b$(或从 $b$ 到 $a$)、且经过第三个顶点的有向路径。
证明 若存在路径 $a \to c \to \cdots \to b$,合并后 $c$ 既是新顶点的后继又是其前驱,构成环。反之,设合并后有环,环必经过新顶点(否则该环在 $D$ 中已存在),沿环离开新顶点、再回到新顶点的部分在 $D$ 中是一条从 ${a, b}$ 到 ${a, b}$ 的路径;它不能从 $a$ 回到 $a$ 或从 $b$ 回到 $b$($D$ 无环),也不能是单条边 $a \to b$ 或 $b \to a$(这样的边在合并后成为块的内部边,不出现在商图中),故为经过第三个顶点、连接 $a$ 与 $b$ 的路径。$\square$
命题 7.1 的条件可以化为对祖先集合的查询。记 $\mathrm{anc}(v)$ 为在 $D$ 中能到达 $v$ 的顶点集合。存在经过第三个顶点 $c$、连接 $a$ 与 $b$ 的路径,当且仅当
$$\exists\, c \notin \{a, b\}:\quad c \in \mathrm{anc}(a) \cup \mathrm{anc}(b)\ \text{且}\ \{a, b\} \cap \mathrm{anc}(c) \ne \varnothing,$$即 $c$ 是其中一个的祖先、又是另一个的后代。调度器在融合开始前为每个节点计算一次祖先集合。融合过程中,新的祖先关系只能经由已融合的节点产生,因此查询时只需沿已融合的节点向上搜索,而不必在每次合并后重算全图的传递闭包。
纵向融合还须保证合并后的执行次序仍然正确。
命题 7.2(纵向融合的正确性) 设 $a \to b$,$a$ 写出缓冲区 $B$ 时的下标为单射 $w(i)$,$i$ 为 $a$ 的外层迭代变量。若 $b$ 对 $B$ 的每次读取,其下标都等于 $w(i)$,其中 $i$ 是 $b$ 的迭代变量的前缀,则按"对每个 $i$,先执行 $a$ 的第 $i$ 次迭代,再执行 $b$ 中前缀为 $i$ 的全部迭代"的次序执行,与先执行完 $a$ 再执行 $b$ 的结果相同。
证明 $b$ 中前缀为 $i$ 的迭代只读取位置 $w(i)$。由于 $w$ 是单射,该位置只由 $a$ 的第 $i$ 次迭代写入,在融合后的次序中,这次写入先于这些读取完成,且此后不再被改写。因此 $b$ 读到的值与原次序中相同。$b$ 的写入不被 $a$ 读取(否则 $a \to b$ 与 $b \to a$ 同时成立,与无环矛盾),故 $a$ 的结果也不变。$\square$
例 7.1 正是这一情形:$a$ 为行和,$w(i) = i$;$b$ 为逐元素相除,迭代变量为 $(i, j)$,读取行和的下标为前缀 $i$。命题中的"前缀"使 $b$ 可以比 $a$ 多出内层的维度,这对应于把规约结果广播回整行。若读取的下标不等于 $w(i)$,例如 $b$ 读取 $a$ 的第 $i+1$ 个输出,融合后读取会先于写入发生,纵向融合被拒绝。
命题 7.2 只处理"读取下标恰好等于写入下标"的情形。一般情形需要依赖距离的概念,这是循环变换理论的基本工具 [29]。
定义 7.4(依赖距离) 设 $a$ 的第 $i$ 次迭代写出缓冲区 $B$ 的位置 $w(i)$,$w$ 为单射;$b$ 的第 $j$ 次迭代读取位置 $r(j)$。若 $r(j)$ 在 $w$ 的像中,记 $p(j) = w^{-1}(r(j))$ 为产生该值的 $a$ 的迭代。把 $a$ 与 $b$ 的迭代空间对齐到共同的外层维度后,称 $\delta(j) = p(j) - j$ 为 $b$ 的第 $j$ 次迭代对 $a$ 的依赖距离,按字典序比较。
命题 7.3(融合的合法性) 设 $a$ 与 $b$ 的迭代空间兼容并按共同的外层维度对齐,融合后对每个外层下标依次执行 $a$ 与 $b$ 的相应迭代。
- 若融合后的循环按顺序执行,则融合保持语义,当且仅当对一切 $j$ 有 $\delta(j) \preceq 0$,即每个被读取的值都由不晚于读取者的迭代产生;
- 若融合后的外层迭代并行执行,彼此之间没有先后保证,则融合保持语义,当且仅当对一切 $j$ 有 $\delta(j) = 0$。
证明 (1)顺序执行时,$b$ 的第 $j$ 次迭代执行之前,$a$ 的第 $0, \dots, j$ 次迭代已全部完成。若 $\delta(j) \preceq 0$,产生 $r(j)$ 的迭代 $p(j) \preceq j$ 已经执行,$b$ 读到的值与原次序相同。反之,若某个 $\delta(j) \succ 0$,则 $p(j)$ 在 $j$ 之后才执行,$b$ 读到的是写入之前的内容,与原程序不同。(2)并行执行时,不同外层迭代之间的次序任意,只有同一外层迭代内部"先 $a$ 后 $b$“的次序得到保证。$\delta(j) = 0$ 时值在同一迭代内产生,读取正确;$\delta(j) \ne 0$ 时,总存在一种调度使 $p(j)$ 晚于 $j$ 执行,读取错误。$\square$
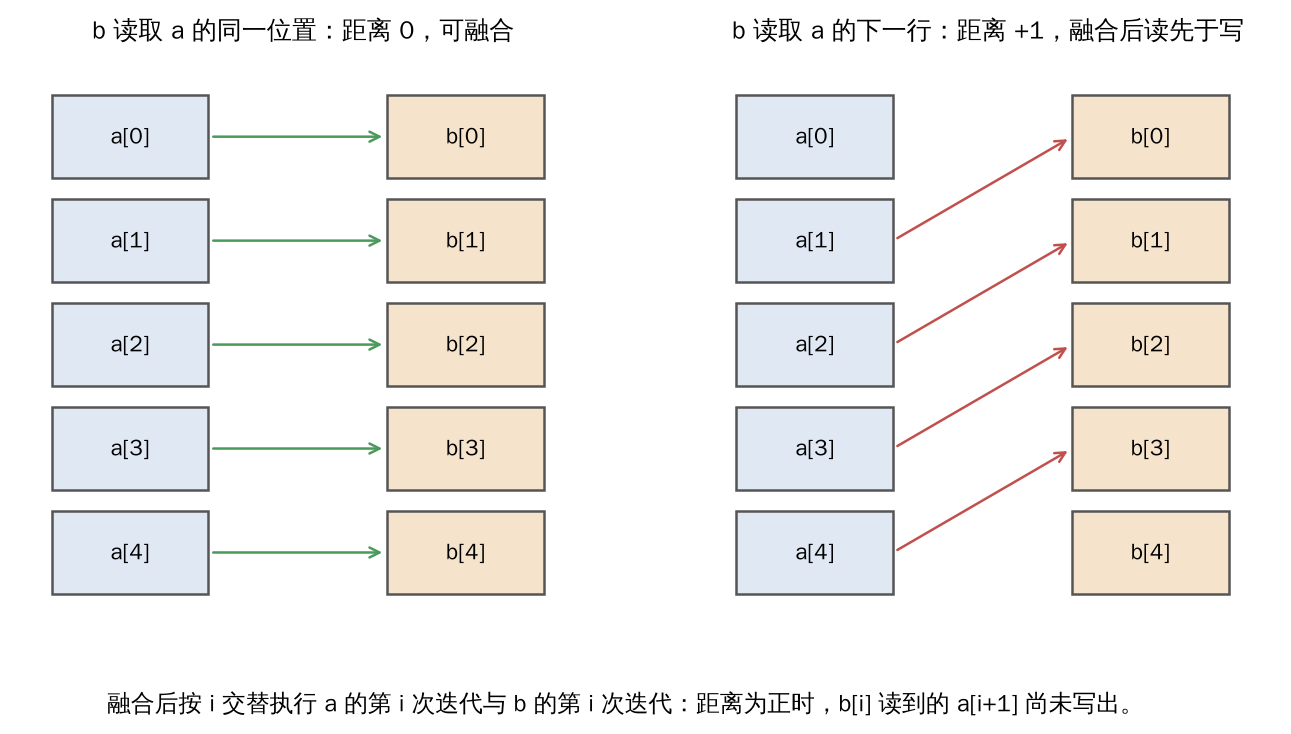
图 7.1 依赖距离。左:距离为 0,每个 $b[i]$ 只读取同一次迭代写出的 $a[i]$。右:距离为 $+1$,融合后 $b[i]$ 读取的 $a[i+1]$ 尚未写出。
命题 7.2 正是命题 7.3 第 2 条中 $\delta \equiv 0$ 的情形。Stax 生成的内核在外层维度上是并行的(CPU 上的 OpenMP 循环,GPU 上的程序实例),因此它要求读写下标在规范化之后完全相同,距离为负的依赖虽然在顺序执行下合法,也同样被拒绝。距离为负而又必须融合的情形,例如模板卷积中读取相邻位置,须在内核内部引入同步或重叠的分块,这超出了 Stax 调度器的模型。
判定 $\delta$ 的符号需要求解 $w(i) = r(j)$。下标是循环变量的仿射函数时,这是一个整数线性方程组,带有循环范围给出的不等式约束。经典的依赖测试以逐步加强的代价回答它:GCD 测试只检查方程有无整数解;Banerjee 测试在实数松弛上检查不等式;Omega 测试 [30] 以 Fourier–Motzkin 消元精确判定整数可行性,最坏情形是指数的。多面体模型 [31] 把这一做法推到极致(7.7 节给出它的基本定理):迭代空间与依赖都表示为整数多面体,循环的融合、分块、交换与偏斜统一表示为仿射调度,由整数线性规划在合法的调度中选择目标函数最优者,PLUTO [32] 以最小化依赖距离为目标同时获得并行性与局部性。
Stax 没有采用多面体模型。它的依赖判定只比较规范化后的下标表达式是否在符号意义下相等(6.8 节的化简使不同写法得到同一形式),不相等即视为不可融合。这一判定是保守的:它不会接受非法的融合,但会拒绝一部分合法的融合,例如距离为负的顺序融合,以及只有经过循环偏斜才能合法的融合。换来的是分析时间与表达式的规模成线性关系,不需要求解整数规划,这对每次编译都要处理数百个节点的即时编译器是重要的。
7.3 贪心融合算法
算法 7.1 贪心融合
输入:调度节点集合 V
输出:融合后的节点集合 V
1  for round = 1 to 10:
2      C ← 共享至少一个缓冲区的节点对
3      C ← {(a, b) ∈ C | can_fuse(a, b)}
4      将 C 按 score(a, b) 降序排列
5      for (a, b) in C:
6          若 a、b 本轮均未被合并,且由命题 7.1 合并不产生环:
7              V ← (V − {a, b}) ∪ {fuse(a, b)}
8      若 |V| 未减少,则终止
9  return V
第 2 行只在共享缓冲区的节点之间生成候选。不共享数据的两个节点融合后并不减少访存,排除它们使候选的规模远小于 $|V|^2$。
第 3 行的合法性判定区分两种融合。若 $b$ 读取 $a$ 写出的缓冲区,称为纵向融合(vertical fusion),融合后 $a$ 的结果可以不写入主存;若二者只是读取相同的输入,称为横向融合(horizontal fusion),融合后共享的输入只需读一次。判定的条件包括:迭代空间兼容(定义 7.2);纵向融合时读写下标满足命题 7.2 的条件;融合后的节点数不超过 128,涉及的不同缓冲区不超过 32 个;共享数据的字节数不低于阈值;融合不会使两者共同的输入的存活时间过度延长,从而显著抬高峰值内存;要求严格规约顺序的两个规约不能融合;二者不在不同的执行流上。
第 4 行的收益函数的核心是共享数据的字节数:两节点共享且下标相同的依赖,其字节数之和就是融合后可以省去的主存传输。收益的比较按字典序进行。设一对候选的得分为 $(\tau, \sigma, \omega, -\delta)$:$\tau$ 为类型分,两者同为规约或同为逐元素节点且共享数据时为 1,否则为 0;$\sigma$ 为可省去的主存字节数;$\omega$ 为共享缓冲区的个数;$\delta$ 为两者在原始顺序中的距离。另有一条例外:两对候选的 $\sigma$ 相差 16 倍以上时,只比较 $\sigma$。模板与其尾部的融合排在普通融合之后(9.8 节)。类型分排在字节数之前,因为类型相同的节点融合后循环结构更简单;距离排在最后,因为相距越远,融合越会延长前一节点所读数据或结果的存活时间,增加峰值内存。
贪心算法不保证最优:先合并得分最高的一对,可能使另一对得分稍低但合起来更优的组合不再合法。算法以轮为单位重复,每轮内一个节点至多参与一次合并,轮数上限为 10。
7.4 融合实例
例 7.1(续) 对 k 的两个节点,融合日志的主要内容为:
found 1 possible fusions
fusing op0 with op1
op0_op1: OuterLoopFusedSchedulerNode(SchedulerNode,SchedulerNode)
二者共享 primals_1 与 buf1,共享数据的得分为 33024,恰为 primals_1 的 32768 字节(8192 个 float)加 buf1 的 256 字节(64 个 float)。由于 op0 的迭代分组为 ((64,), (128,)),op1 为 ((64, 128), ()),二者的外层 64 次循环相同,CPU 后端判定外层循环融合深度为 1,将它们融合为一个外层循环融合节点。生成的内核如代码清单 7.1 所示。
代码清单 7.1 例 7.1 的融合内核(CPU,省略了命名空间与边界检查)
#pragma omp for
for (int64_t x0 = 0; x0 < 64; x0 += 1) {
    // op0:第 x0 行求和
    float tmp_acc0 = 0;
    Vectorized<float> tmp_acc0_vec = Vectorized<float>(0);
    for (int64_t x1 = 0; x1 < 128; x1 += 16) {
        auto tmp0 = Vectorized<float>::loadu(in_ptr0 + 128*x0 + x1, 16);
        tmp_acc0_vec = tmp_acc0_vec + tmp0;
    }
    tmp_acc0 = tmp_acc0 + vec_reduce_all<float, 1>(add, tmp_acc0_vec);
    out_ptr0[x0] = static_cast<float>(tmp_acc0);
    // op1:第 x0 行逐元素相除
    for (int64_t x1 = 0; x1 < 128; x1 += 16) {
        auto tmp0 = Vectorized<float>::loadu(in_ptr0 + 128*x0 + x1, 16);
        auto tmp1 = out_ptr0[x0];
        auto tmp2 = Vectorized<float>(tmp1);
        auto tmp3 = tmp0 / tmp2;
        tmp3.store(out_ptr1 + 128*x0 + x1);
    }
}
两个内层循环位于同一次外层迭代之内:第 $x_0$ 行先求和,紧接着对同一行做除法。一行只有 512 字节,第二次读取时该行仍在 L1 缓存中,因此 $x$ 实际只从主存读取一次。行和 buf1 仍写入一个 64 元素的缓冲区,在包装函数中分配,并在内核返回后立即释放。
例 7.2 设
def m(x):
    e = x.exp()
    return e.sum(-1), e.amax(-1)
$x$ 的形状为 $64\times128$。前端 CSE 后,exp 是一个有两个使用者的节点。在 CPU 上,降级时 exp 满足 6.6 节的第 1 条实体化规则,被写入一个 $64\times128$ 的缓冲区 buf1;sum 与 amax 成为两个读取 buf1 的规约节点。融合的过程为:
第 1 轮:op0(exp)与 op1(sum)、op2(amax)的迭代分组分别为 ((8192,), ()) 与 ((64,), (128,)),
        外层循环融合深度为 0,纵向融合被拒绝;
        op1 与 op2 的迭代分组相同,以 SAME_VARS_REDUCE 为由横向融合
第 2 轮:found 0 possible fusions,结束
生成的 CPU 内核含两个并行循环:第一个对 8192 个元素计算 exp 并写入 buf1;第二个按行读取 buf1,在同一循环中同时维护和与最大值两个累加器。在 GPU 上,该规则不适用,exp 不被实体化,而是内联到两个规约中,二者再横向融合为一个内核,如代码清单 7.2 所示。
代码清单 7.2 例 7.2 的 Triton 内核(省略了导入语句、装饰器与下标的定义)
def triton_per_fused_0(in_ptr0, out_ptr0, out_ptr1, xnumel, r0_numel, XBLOCK : tl.constexpr):
    ...
    tmp0 = tl.load(in_ptr0 + (r0_1 + 128*x0), xmask, eviction_policy='evict_first', other=0.0)
    tmp1 = libdevice.exp(tmp0)
    tmp2 = tl.broadcast_to(tmp1, [XBLOCK, R0_BLOCK])
    tmp4 = tl.where(xmask, tmp2, 0)
    tmp5 = tl.sum(tmp4, 1)[:, None].to(tl.float32)
    tmp7 = tl.where(xmask, tmp2, float("-inf"))
    tmp8 = triton_helpers.max2(tmp7, 1)[:, None].to(tl.float32)
    tl.store(out_ptr0 + (x0), tmp5, xmask)
    tl.store(out_ptr1 + (x0), tmp8, xmask)
两个规约内联了同一个 exp,内核内的 CSE 使它只计算一次。同一个程序在两种设备上得到不同的划分:CPU 上 exp 较贵,实体化以避免重算;GPU 上 exp 较廉价,而写出并读回 $64\times128$ 的中间结果更贵,故选择内联。这一差异完全来自 6.6 节的代价模型在两类设备上的不同取值,调度与代码生成没有为此作专门处理。
7.5 缓冲区的复用
调度确定后,每个中间缓冲区有一个确定的生存期:从其生产者执行开始,到其最后一个使用者执行结束。
定义 7.5(生存期与峰值内存) 设调度后的内核序列为 $k_1, \dots, k_T$,缓冲区 $v$ 的生存期为区间 $[,\mathrm{def}(v),\ \mathrm{last}(v),]$。时刻 $\tau$ 的活跃集合为 $L(\tau) = { v \mid \mathrm{def}(v) \le \tau \le \mathrm{last}(v) }$,峰值内存的下界为
$$M^\ast = \max_{\tau} \sum_{v \in L(\tau)} b(v).$$
生存期相交的两个缓冲区不能共用存储;不相交的可以。若把缓冲区看作区间图的顶点、生存期相交者之间连边,复用就是在这张图上为每个顶点分配一段地址区间,使相邻顶点的地址区间不重叠,目标是使总地址空间接近 $M^\ast$。各缓冲区大小相同时,这是区间图的着色问题,按左端点排序的贪心算法即可达到最优;大小不同时,这一问题称为动态存储分配,一般是 NP 难的 [21]。
Stax 采用一种保守的贪心规则。代码生成时,每个缓冲区在生产者处产生一条分配记录,在最后一个使用者之后产生一条释放记录。随后顺序扫描这些记录,维护一个空闲池:
- 处理释放记录时,若该缓冲区不是图的输出、也不与输入共享存储,将其放入空闲池;
- 处理分配记录时,若空闲池中有设备、数据类型与存储大小均相同的缓冲区,且复用不会使任何时刻的占用超过当前峰值,则复用之,生成形如
buf5 = buf2; del buf2 # reuse的语句。
复用只发生在大小相同的缓冲区之间,避免了一般的动态存储分配问题;对每次复用检查峰值,保证复用不会使峰值上升。形状或步长不同时,在同一存储上以新的形状与步长解释,不复制数据。
推理区域另有一种更彻底的做法:把全部中间缓冲区安排进按设备划分的存储池中,每个缓冲区在池内有一个固定的偏移。池的结构是一棵树,内部节点有两种:时间划分,表示其子节点的生存期互不相交,可以共用同一段地址;空间划分,表示其子节点并排占用不同的地址。缓冲区按大小降序、生存期长者优先插入,先尝试放入已有的时间划分,失败时再开辟新的空间。这是动态存储分配问题的一种贪心近似。
上述规则都在内核序列给定之后才起作用,而 $M^\ast$ 本身取决于序列。依赖图的不同拓扑序给出不同的生存期,从而给出不同的峰值。
命题 7.4 给定有向无环图与各节点输出的大小,判定是否存在一个拓扑序使定义 7.5 的 $M^\ast \le M$,是 NP 完全的。
证明需要一个图论概念。设 $H = (U, F)$ 为无向图,$\pi = (u_1, \dots, u_{|U|})$ 为 $U$ 的一个线性序,记前缀 $\pi_{\le i} = {u_1, \dots, u_i}$ 与
$$V_i = \{\, u \in \pi_{\le i} : u \text{ 有邻点不在 } \pi_{\le i} \text{ 中} \,\},$$称 $\mathrm{vs}(\pi) = \max_i |V_i|$ 为 $\pi$ 的顶点分隔数,$\mathrm{vs}(H) = \min_\pi \mathrm{vs}(\pi)$。顶点分隔数等于路径宽度 [43],而判定路径宽度是否不超过 $k$ 是 NP 完全的 [42]。
证明 属于 NP:给定一个拓扑序,按定义 7.5 线性扫描即可求出峰值。
NP 难:由顶点分隔数归约。给定无孤立顶点的图 $H = (U, F)$ 与整数 $k$,令 $K = |F| + 1$,构造有向无环图 $D$:每个 $u \in U$ 对应一个节点,读取同一个大小为 0 的外部输入,输出大小为 $K$;每条边 $f = {u, w} \in F$ 对应一个节点,读取 $u$ 与 $w$ 的输出,输出大小为 1,且是图的输出(存活到最后)。取阈值 $M = K(k+1) + |F|$。下面证明 $D$ 的全部拓扑序中峰值的最小值落在区间 $[,K(\mathrm{vs}(H)+1),\ K(\mathrm{vs}(H)+1) + |F|,]$ 中。
下界。任取一个拓扑序,记 $\pi$ 为其中 $U$ 类节点的先后次序。考察 $u_{i+1}$ 执行的时刻 $\tau$($0 \le i < |U|$)。对每个 $u \in V_i$,它有一个邻点 $w \notin \pi_{\le i}$,边节点 ${u, w}$ 依赖于尚未执行的 $w$,故 $\mathrm{last}(u) > \tau$,$u$ 在 $\tau$ 时刻活跃;$u_{i+1}$ 自身也活跃。于是此刻占用不少于 $K(|V_i| + 1)$。因为 $V_{|U|} = \varnothing$,对 $i$ 取最大值得峰值 $\ge K(\mathrm{vs}(\pi) + 1) \ge K(\mathrm{vs}(H) + 1)$。
上界。取使 $\mathrm{vs}(\pi) = \mathrm{vs}(H)$ 的序 $\pi$,按如下次序执行:依次执行 $u_1, u_2, \dots$,每执行一个 $u_i$,随即执行所有两个端点都已执行的边节点。执行 $u_i$ 或紧随其后的边节点时,若某个 $u \in \pi_{\le i-1}$ 的邻点全在 $\pi_{\le i-1}$ 中,则它的所有边节点在此之前都已执行,$u$ 已不再活跃;故活跃的 $U$ 类节点包含于 $V_{i-1} \cup {u_i}$,占用至多 $K(\mathrm{vs}(H) + 1)$,边节点的输出至多再占 $|F|$。
由 $K = |F| + 1$:若 $\mathrm{vs}(H) \le k$,上界给出峰值 $\le K(k+1) + |F| = M$;若 $\mathrm{vs}(H) \ge k + 1$,下界给出每个拓扑序的峰值 $\ge K(k+2) > M$。构造是多项式的,故命题成立。$\square$
与之相关的经典结果是 Sethi 关于寄存器分配的 NP 完全性 [22]。二者的计价模型不同:寄存器模型允许运算结果直接写入一个此后不再使用的操作数的寄存器,而定义 7.5 中缓冲区的生存期包含其最后一个使用者执行的时刻,输入与输出在该时刻同时占用存储。因此不能简单地把寄存器视为单位大小的缓冲区,上面的归约直接针对定义 7.5 的模型。Stax 因此采用启发式:在融合之后,以三种策略各生成一个拓扑序,连同原有的次序共四个候选,对每个候选按定义 7.5 模拟分配与释放,估计其峰值,取峰值最小者。三种策略是:每一步在就绪的节点中选择使内存增量最小者(最小峰值优先);按前驱的执行位置做广度优先;按节点及其输入的大小升序做深度优先。由于原有次序也在候选之中,重排的结果不会比原次序更差;估计一个候选的峰值只需一次线性扫描,代价为 $O(T)$。
最后是原地复用,它是 4.9 节函数化的逆变换。若一个节点读取的某个缓冲区在此之后不再被使用,且该节点的输出与它设备、数据类型相同,大小相同(或略小),读写的下标一致,则该节点可以直接把结果写入这块缓冲区,省去一次分配。下标一致的要求保证了每个位置先被读取、后被覆盖,与命题 7.2 的论证相同。函数化为中间值引入的新存储,在满足这些条件时就以这种方式被收回。
7.6 调度的完整流程
综合本节,调度器按以下顺序处理降级产生的缓冲区:
- 为每个缓冲区建立调度节点,以记录读写的处理器分析其依赖(7.1 节);
- 按依赖做拓扑排序,删除结果不被任何节点使用、且没有副作用的节点;
- 计算每个节点的祖先集合,供融合时的环检测使用(7.2 节);
- 执行至多 10 轮贪心融合(算法 7.1);
- 按峰值内存在若干拓扑序中择优重排(7.5 节);
- 逆序扫描,确定每个缓冲区的最后一个使用者,据此在代码生成时插入释放与复用的语句。
此后,每个调度节点交给对应设备的代码生成器(第 8、9 节)。在这一流程中,前两步是对依赖图的整理,第 4 步决定内核的划分,第 5、6 步决定内核的次序与存储;三者对应于融合问题的三个侧面:哪些计算放在一起,以什么次序执行,中间结果放在哪里。
7.7 仿射依赖与分块的合法性
7.2 节的依赖距离只处理了一维对齐的两个节点。本节把它推广到多重循环,给出循环变换与分块合法性的一般判据,即多面体模型 [31, 32] 的基本定理。Stax 本身不需要这套机制,节末说明原因,但它划定了 Stax 的保守判定所放弃的那部分空间。
考虑一个 $d$ 重循环嵌套,迭代向量 $i \in \mathbb Z^d$ 取值于整数多面体
$$\mathcal D = \{\, i \in \mathbb Z^d : A i + a \ge 0 \,\},$$循环按字典序 $\prec$ 执行。每条访存语句以仿射函数 $i \mapsto F i + f$ 计算数组下标。
定义 7.6(依赖多面体与距离向量) 设语句 $S$ 在迭代 $i$ 写出 $X[F_W i + f_W]$,语句 $T$ 在迭代 $j$ 读取 $X[F_R j + f_R]$。称
$$\mathcal P_{S \to T} = \{\, (i, j) \in \mathcal D \times \mathcal D : F_W i + f_W = F_R j + f_R,\ i \prec j \,\}$$为流依赖集。若 $S$ 在程序文本中先于 $T$,还须加入 $i = j$ 的循环无关依赖。若对一切依赖对,差 $j - i$ 都等于同一个常向量 $\delta$,称依赖是一致的,$\delta$ 为距离向量;循环携带的依赖有 $\delta \succ 0$,循环无关的依赖有 $\delta = 0$。反依赖(先读后写)与输出依赖(两次写)类似定义。
字典序 $i \prec j$ 是一个析取条件,故 $\mathcal P_{S \to T}$ 一般不是一个多面体,而是有限个多面体之并:按携带依赖的层次 $p = 1, \dots, d$ 分为
$$\mathcal P^{(p)}_{S \to T} = \{\, (i, j) : i, j \in \mathcal D,\ F_W i + f_W = F_R j + f_R,\ i_1 = j_1, \dots, i_{p-1} = j_{p-1},\ i_p + 1 \le j_p \,\},$$每一块都是多面体。
距离向量的第一个非零分量所在的循环称为携带该依赖的循环。例如 for i: for j: X[i][j] = X[i-1][j+1] + 1 的距离向量为 $(1, -1)$,由外层循环携带。
**变换的合法性。**以整数矩阵 $\Theta$ 对迭代空间作变换,新的执行次序是 $\Theta i$ 的字典序。$\Theta$ 为置换矩阵时是循环交换,为单位下三角矩阵时是偏斜。
定理 7.2(仿射变换的合法性) 设 $\Theta$ 为幺模矩阵(整数矩阵,行列式为 $\pm 1$)。按 $\Theta i$ 的字典序执行,保持全部依赖的先后次序,当且仅当对每个依赖多面体中的每一对 $(i, j)$ 都有 $\Theta i \prec \Theta j$。依赖都是一致的时,条件化为:对每个距离向量 $\delta$,$\Theta \delta \succ 0$。
证明 $\Theta$ 幺模,故 $i \mapsto \Theta i$ 是 $\mathbb Z^d$ 上的双射,新次序是迭代集合上的一个全序,每个迭代恰好执行一次(对次序的论证而言,$\Theta$ 是单射即已足够;幺模性还保证变换后的迭代空间仍是整数点集,便于生成循环)。程序的结果由每对依赖迭代的先后次序决定(无依赖的迭代可以任意交换),故保持全部依赖的先后次序等价于对每一对依赖 $(i, j)$ 在新次序下仍有 $i$ 先于 $j$,即 $\Theta i \prec \Theta j$。一致依赖时 $\Theta j - \Theta i = \Theta \delta$,而 $\Theta i \prec \Theta j$ 当且仅当 $\Theta j - \Theta i \succ 0$。$\square$
上例中交换两层循环对应 $\Theta = \begin{pmatrix}0&1\1&0\end{pmatrix}$,$\Theta\delta = (-1, 1) \prec 0$,交换是非法的;先偏斜 $j’ = i + j$,即 $\Theta = \begin{pmatrix}1&0\1&1\end{pmatrix}$,得 $\Theta\delta = (1, 0) \succ 0$,偏斜是合法的。
**分块。**矩形分块以块大小 $b = (b_1, \dots, b_d)$ 把迭代 $i$ 归入块 $t(i) = (\lfloor i_1/b_1 \rfloor, \dots, \lfloor i_d/b_d \rfloor)$,先按块的字典序、块内再按原来的字典序执行。分块不是幺模变换,它把一维次序改成了两级次序,需要单独的判据。
定义 7.7(完全可置换的循环带) 称循环 $1, \dots, d$ 构成完全可置换的循环带,若每个距离向量的各分量都非负:$\delta \ge 0$(逐分量)。
定理 7.3(矩形分块的合法性 [46, 47]) 若循环带是完全可置换的,则以任意块大小作矩形分块都保持全部依赖的先后次序;带内各循环也可以任意交换。
证明 设 $(i, j)$ 是一对依赖,$j = i + \delta$,$\delta \ge 0$ 且 $\delta \ne 0$。逐分量地,$\lfloor j_p / b_p \rfloor \ge \lfloor i_p / b_p \rfloor$,故 $t(j) \ge t(i)$。若 $t(j) = t(i)$,二者在同一块内按原次序执行,而 $i \prec j$。若 $t(j) \ne t(i)$,则 $t(j) - t(i) \ge 0$ 且非零,其第一个非零分量为正,$t(i) \prec t(j)$,$i$ 所在的块先执行。两种情形下 $i$ 都先于 $j$。交换带内循环对应置换矩阵 $\Theta$,$\Theta \delta$ 是 $\delta$ 的分量重排,仍然非负且非零,故字典序为正,由定理 7.2 合法。$\square$
Irigoin 与 Triolet 对一般的平行六面体分块给出了合法性条件 [46]:以超平面族 $H$(行向量为各族超平面的法向)切分时,若 $H\delta \ge 0$ 对一切距离向量成立,则块之间的依赖都从字典序较小的块指向较大的块,分块合法。定理 7.3 是 $H = I$ 的情形。距离向量有负分量时,先作偏斜使之变为非负,再分块,这是模板计算的标准做法。
**仿射调度的存在性。**更一般的问题是:给每条语句一个仿射的调度函数 $\theta_S(i) = c_S \cdot i + c_{S,0}$,作为它在迭代 $i$ 执行的逻辑时间,使每对依赖的目标严格晚于源点:
$$\theta_T(j) - \theta_S(i) - 1 \ge 0,\qquad \forall (i, j) \in \mathcal P_{S \to T}.$$这是关于未知系数 $c$ 的"对一个多面体中的所有点成立"的约束,无穷多个。下面的引理把它化为有限个线性约束。
引理 7.1(Farkas 引理的仿射形式 [48]) 设多面体 $\mathcal Q = { x \in \mathbb R^n : B x + \beta \ge 0 }$ 非空,$\psi(x) = \gamma \cdot x + \gamma_0$ 为仿射函数。则 $\psi$ 在 $\mathcal Q$ 上处处非负,当且仅当存在 $\lambda_0 \ge 0$ 与向量 $\lambda \ge 0$,使
$$\psi(x) \equiv \lambda_0 + \lambda^{\mathsf T}(B x + \beta)\quad\text{(作为 } x \text{ 的仿射函数恒等)}.$$
证明 充分性是显然的:右端在 $\mathcal Q$ 上非负。必要性:$\psi \ge 0$ 在 $\mathcal Q$ 上成立,意味着线性规划 $\min{\gamma \cdot x : Bx + \beta \ge 0}$ 有下界 $-\gamma_0$;$\mathcal Q$ 非空,由线性规划的强对偶定理,对偶问题 $\max{-\lambda^{\mathsf T}\beta : B^{\mathsf T}\lambda = \gamma,\ \lambda \ge 0}$ 有最优解 $\lambda$,且最优值 $-\lambda^{\mathsf T}\beta \ge -\gamma_0$。令 $\lambda_0 = \gamma_0 - \lambda^{\mathsf T}\beta \ge 0$,则 $\lambda_0 + \lambda^{\mathsf T}(Bx + \beta) = \gamma \cdot x + \gamma_0$。$\square$
命题 7.5(一维仿射调度的判定 [31]) 给定各依赖多面体(取其有理松弛),判定是否存在满足上述约束的一维仿射调度,可以化为一个线性规划的可行性问题,因而可在多项式时间内判定。
证明 按定义 7.6 把每个依赖集分为多面体 $\mathcal P^{(p)}_{S \to T} = {(i,j) : B(i,j) + \beta \ge 0}$(等式写成两个不等式),对其中每个非空的块分别处理;约束 $\psi(i, j) = \theta_T(j) - \theta_S(i) - 1 \ge 0$ 的系数是未知数 $c$ 的线性函数。由引理 7.1,它等价于存在 $\lambda_0, \lambda \ge 0$ 使 $\psi \equiv \lambda_0 + \lambda^{\mathsf T}(B(i,j) + \beta)$;比较两端 $i$、$j$ 各分量的系数与常数项,得到关于 $(c, \lambda_0, \lambda)$ 的有限个线性等式。全部依赖的这些等式连同 $\lambda \ge 0$ 构成一个线性规划,其可行性可在多项式时间内判定。$\square$
命题 7.5 是在有理松弛上陈述的:整数点上的调度约束比有理多面体上的弱,松弛可能拒绝一个只在整数点上成立的调度,但它接受的调度一定合法。一维调度不一定存在(例如依赖链长度随问题规模平方增长时),Feautrier 进而构造多维调度 [31];PLUTO 在同样的线性化约束下,以最小化依赖距离的上界为目标逐层求解,同时得到可分块的循环带与外层并行性 [32]。这些算法求解的是整数线性规划或参数化的线性规划,代价远高于 7.2 节的符号比较。
**Stax 为什么不需要这些。**Stax 的节点只有两种形态(定义 6.1)。逐元素节点的各次迭代之间没有依赖,任意次序、任意分块都合法。规约节点只在规约维上通过累加器形成依赖,距离向量只在规约维上为 1、其余为 0,各分量非负,循环带因而是完全可置换的;规约维本身的重排与分段不靠依赖分析,而靠 6.5 节的结合律,并且只在实数语义下成立(定理 6.3)。节点之间的依赖则由 7.2 节的符号比较处理,命题 7.3 可以看作定理 7.2 在一维对齐下的特例(注意命题 7.3 的 $\delta$ 定义为 $p(j) - j$,与定义 7.6 的 $j - i$ 方向相反,故那里的合法条件写作 $\delta \preceq 0$)。张量程序中真正需要本节理论的是带有循环携带依赖的运算,例如前缀和与模板计算;Stax 以专门的扫描节点表示前缀和,携带依赖的维与其余各维分开处理,其并行化同样依赖合并运算的结合律,不能生成时回退到框架的实现;模板计算则不做跨节点的融合。
8 CPU 代码生成
调度确定了内核的划分,代码生成把每个内核的循环嵌套翻译为目标机器上的程序。CPU 与 GPU 的代码生成共享一层 SIMD 抽象,负责统一迭代空间(逐元素维度与规约维度)、选择分块方式,并判断能否使用 32 位下标。本节讨论 CPU,第 9 节讨论 GPU。
8.1 向量化
现代 CPU 以 SIMD(single instruction, multiple data)指令在一个向量寄存器中同时处理 $W$ 个元素。512 位的寄存器容纳 16 个 float32 或 32 个 float16。把一个循环向量化,就是把其迭代按 $W$ 个一组分块(strip-mining),每组以一条向量指令完成。
命题 8.1(向量化的合法性) 设最内层循环的迭代空间为 ${0, \dots, n-1}$。(1)若各次迭代之间没有数据依赖,则按 $W$ 个一组同时执行与顺序执行的结果相同。(2)若各次迭代以交换幺半群 $(M, \oplus, e)$ 累加到同一个变量,则以 $W$ 个累加器分别累加、最后合并,与顺序累加的结果在精确算术下相同。
证明 (1)没有依赖时,每次迭代只读取循环开始前已确定的值、只写入自己的位置,执行顺序不影响结果。(2)第 $\ell$ 个累加器累加下标模 $W$ 余 $\ell$ 的项,由结合律与交换律,
$$\bigoplus_{r=0}^{n-1} a_r = \bigoplus_{\ell=0}^{W-1} \Bigl( \bigoplus_{r \equiv \ell \ (\mathrm{mod}\ W)} a_r \Bigr). \quad\square$$逐元素运算满足(1),规约满足(2)。命题 8.1(2)只在精确算术下成立,浮点情形下的误差分析见 6.5 节。代码清单 1.1 中的 acc 即 16 个累加器组成的向量,循环结束后由 vec_reduce_all 合并为标量。若迭代范围不是 $W$ 的整数倍,尾部以带元素个数的读取指令或标量循环处理。超越函数(exp、log、erf 等)的向量化实现由 SLEEF 库提供。
向量宽度由处理器支持的指令集决定。Stax 定义了 AVX-512、AVX2 与无向量扩展三个等级,编译时按从宽到窄的顺序试探,选用本机支持的最宽者。
8.2 分块与缓存
向量化要求一次读取的 $W$ 个元素在内存中连续。例 6.1 的"先转置再相加"中,一个输入沿最内层维度连续,另一个沿该维度的步长为 256,任何一维的循环顺序都只能使其中一侧连续。
设缓存行长 $L$ 字节、元素长 $b$ 字节。按不连续的一侧读取时,每读入一个缓存行只用到其中一个元素,有效带宽降为原来的 $b/L$;对 64 字节的缓存行与 float32,即 $1/16$。二维分块(tiling)把迭代空间划分为 $B \times B$ 的小块,在一个块内先沿一个方向读入、在寄存器或 L1 缓存中转置、再沿另一个方向写出。只要 $B \ge L/b$,且一个块的数据能留在 L1 缓存中,两侧的每个缓存行都被完整使用,有效带宽恢复到峰值。块的大小因此受两个约束:下限由缓存行决定,上限由 L1 缓存容量决定。
8.3 内核的形态
CPU 内核有三种形态:标量循环,用于无法向量化的运算或数据类型;向量化循环,最内层循环以 $W$ 为步长;二维分块循环,用于转置类的访存。三种形态由同一个内核代理统一生成,代码生成器按循环体中的运算与数据类型选择其一。
生成的代码须保持原程序的语义,包括错误行为。整数除以零在 C++ 中是未定义行为,若直接生成除法指令,程序可能崩溃,也可能得到任意值。生成的内核因此在除法前检查除数,为零时置位一个错误标志,内核返回后由运行时抛出与即时执行一致的异常。
8.4 并行化
外层循环以 OpenMP 的线程并行。设总工作量为 $N$ 个迭代,线程数为 $P$,每个并行区域的固定开销为 $o$,则执行时间约为
$$T \approx \frac{N}{P} \cdot t + o,$$其中 $t$ 为单次迭代的时间。并行有两个前提:可分配的并行单位足够多,使 $P$ 个线程都有工作,且负载大致均衡;每个线程分得的工作足够多,使 $o$ 可以忽略。并行深度,即从最外层起有几层循环参与并行,按算法 8.1 选择。
算法 8.1 并行深度的选择
输入:各层循环的范围 r_1, r_2, ...(从外到内),线程数 P,最小块长 m(默认 512)
输出:并行深度 d
1  seq ← 全部循环的总迭代数;par ← 1;d ← 0
2  for r in r_1, r_2, ...:
3      if par ≥ 2P 或 par = P: break        # 并行单位已足够
4      if seq / P < m: break               # 每个线程分得的工作太少
5      d ← d + 1;par ← par · r;seq ← seq / r
6  return d
第 3 行的条件出于负载均衡。设并行单位数为 $q$,静态均分时最忙的线程分得 $\lceil q/P \rceil$ 个单位,执行时间与理想值之比为 $\lceil q/P \rceil / (q/P)$。$q = P$ 时该比值为 1;$q \ge 2P$ 时,记 $x = q/P \ge 2$,有 $\lceil x \rceil / x < (x+1)/x \le 3/2$,不均衡至多使时间增加一半,且随 $q$ 增大而趋于 1。第 4 行保证每个线程至少分得 $m$ 个迭代,使固定开销 $o$ 被摊薄。
以例 1.1 为例,外层 64 行、内层 128 列,总迭代数 8192。设 $P = 4$,则 $8192/4 = 2048 \ge 512$,外层循环参与并行,$par = 64 \ge 2P$,终止,并行深度为 1。若总迭代数只有 1024,则 $1024/4 = 256 < 512$,并行深度为 0,内核串行执行。
8.5 包装函数
内核之外还需一段代码负责分配缓冲区、按序启动内核、在最后一次使用之后释放内存,即包装函数(wrapper)。例 1.1 的包装函数如代码清单 8.1 所示。
代码清单 8.1 例 1.1 的包装函数(CPU,省略了变量名前缀 GraphLowering_)
cpp__0 = async_compile.cpp_pybinding(['const float*', 'const float*', 'float*'], r'''...''')
async_compile.wait(globals())

def call(self, args):
    primals_1, primals_2 = args
    args.clear()
    assert_size_stride_grouped((primals_1, primals_2),
                               ((64, 128), (64, 128)), ((128, 1), (128, 1)), 'input')
    buf2 = empty_strided_cpu((64,), (1,), tensorplay.float32)
    cpp__0(primals_1, primals_2, buf2)
    del primals_1
    del primals_2
    return (buf2,)
assert_size_stride_grouped 在运行时检查输入的形状与步长是否符合编译时的假设:内核中的下标表达式是按编译时的步长生成的,步长不同的输入会被读错位置。整个函数只分配了一个 64 元素的输出缓冲区,与命题 1.1 的下界一致。args.clear() 与其后的 del 尽早释放对输入的引用,使输入的存储在不再需要时即可回收。
在 CPU 上,同一个包装函数中相邻的多个循环可以生成到同一个 C++ 函数中,共用一个 OpenMP 并行区域,例 7.2 的两个循环即是如此,这省去了每个循环单独进出并行区域的开销 $o$。
上一节:第二节 自动微分与降级 | 目录 | 下一节:第四节 GPU 代码生成与动态形状