目录 | 下一节:第二节 自动微分与降级
文中参考文献编号 [n] 见第六节;章节号、定理号与习题号全章统一编号,跨节引用照常有效。
本章要点
本章以 TensorPlay 的默认编译后端 Stax 为对象,讨论一个深度学习编译器从 Python 函数到机器内核的各个层次:特化与缓存、图捕获、图变换、自动微分与重物化、循环级中间表示、融合与调度、CPU 与 GPU 代码生成、注意力、动态形状,最后建立测量的统计模型,并以实测数据检验前面的模型。主要结论如下:
- 即时编译是一种程序特化。编译产物只在特化键相同的输入等价类上与原函数等价;守卫是特化键的投影,因此任何一次缓存未命中都能归结为某一分量的不等。
- 执行期代理追踪在样例输入上执行函数并记录计算图。数据相关的控制流按样例取值特化,其条件由反向程序切片抽出,并须在死代码消除之前抽取,否则特化的正确性无法维持。
- 图变换是一组保持语义的改写。在 IEEE 754 浮点语义下,许多代数恒等式并不成立,改写须同时保持值、类型、形状与别名关系;改写系统以不动点迭代组织,其终止性依赖于每条规则使图严格变小。算子级分解只展开后端没有专门实现的算子;函数化消除原地修改,使图成为纯函数。
- 反向模式求梯度的代价不超过前向的常数倍(Baur–Strassen 定理),代价是前向须保存中间值。不限存储时,保存与重算的取舍可以建模为流网络上的最小割问题,由最大流最小割定理在多项式时间内求解;限定存储时,链上的二项式检查点只需对数级的存储与重算倍数,一般图上的问题则是 PSPACE 完全的。
- 循环级中间表示将每个张量表示为从下标到值的函数。在它的指称语义下,内联、实体化、公共子表达式消除与死代码消除逐位保持语义(替换引理);规约的拆分与重排只保持实数语义,浮点结果的差别由误差界控制。视图是下标空间上的仿射映射。
- 以最小访存为目标的融合是 NP 难的(由多路割归约),使峰值内存最小的拓扑序是 NP 完全的(由路径宽度归约)。Stax 在共享缓冲区的节点对之间按节省的字节数贪心合并,并以无环条件保证调度的可行性。多重循环的变换与分块的合法性由距离向量的字典序正性与非负性判定(多面体模型);Stax 的节点形态使它只需一维的符号比较。
- CPU 内核的向量化以迭代独立或规约的结合律为合法性依据;GPU 内核以利特尔法则确定掩盖延迟所需的并发度,softmax 的单趟计算依赖于一个二元组上的幺半群。启动配置的选择是黑盒优化,坐标下降给出局部最优,随机搜索给出与维数无关的分位数保证;由 Loomis–Whitney 不等式可证矩阵乘的 I/O 下界为 $\Omega(mnk/\sqrt S)$,分块在渐近意义下达到它。
- 动态形状是对特化键的粗化,只有当编译产物对整个形状类有效时才可靠。符号形状把对大小的判断记为形状守卫,后端依赖于大小的决策须对整个范围成立。
- 编译结果的复用是纯函数的记忆化,内容寻址使缓存无需失效。语义保持是编译器的第一位承诺,回退保证它,严格模式把性能也变为可检验的契约。
- 分块注意力的正确性依据仍是在线 softmax 的结合律;它把注意力的主存访问从 $\Theta(N^2)$ 降为 $\Theta(N^2d^2/M)$,反向以保存 LSE、重算 $P$ 的方式把存储从平方降为线性。
- 测量本身也需要模型。加速比恒等于模型字节比与有效带宽之比的乘积:前者由图的结构决定,是融合的收益;后者是内核质量,字节模型对它不作断言。求和的舍入误差在独立舍入的统计模型下按 $n^{3/2}$ 或 $n$ 增长,比最坏情形的界小两到三个数量级,并随条件数放大。
本章的 CPU 代码清单为 Stax 在 x86-64(AVX-512)上的实际编译输出;GPU 代码清单为以计算能力 9.0、132 个流多处理器的 CUDA 设备为目标生成的 Triton 源码。为便于阅读,部分清单省略了命名空间、导入语句与变量名前缀,省略处均已注明。
1 引言
1.1 访存受限与算子融合
深度学习程序中有大量逐元素(elementwise)运算与规约(reduction)运算。这类运算每读入一个元素只做少量算术,执行时间主要由访存量而非计算量决定。为刻画这一点,引入以下定义。
定义 1.1(算术强度) 设一个内核执行的浮点运算次数为 $W$,与主存之间传输的字节数为 $Q$,则其算术强度(arithmetic intensity)为
$$I = \frac{W}{Q}\quad(\text{FLOP/byte}).$$
按 Roofline 模型 [1],设处理器的峰值算力为 $P$,主存带宽为 $B$,则内核可达到的性能上界为
$$\min(P,\ I \cdot B).$$当 $I < P/B$ 时,内核受访存限制,性能随 $I$ 线性增长;$P/B$ 称为脊点(ridge point)。以 H100 SXM 的标称值为例,FP32 非张量核心算力约为 67 TFLOPS,HBM3 带宽约为 3.35 TB/s,脊点约为 20 FLOP/byte。一次 FP32 加法读两个元素、写一个元素,算术强度为 $1/12 \approx 0.083$ FLOP/byte,比脊点低两个数量级以上。对于这类内核,减少访存是提高性能的唯一途径。
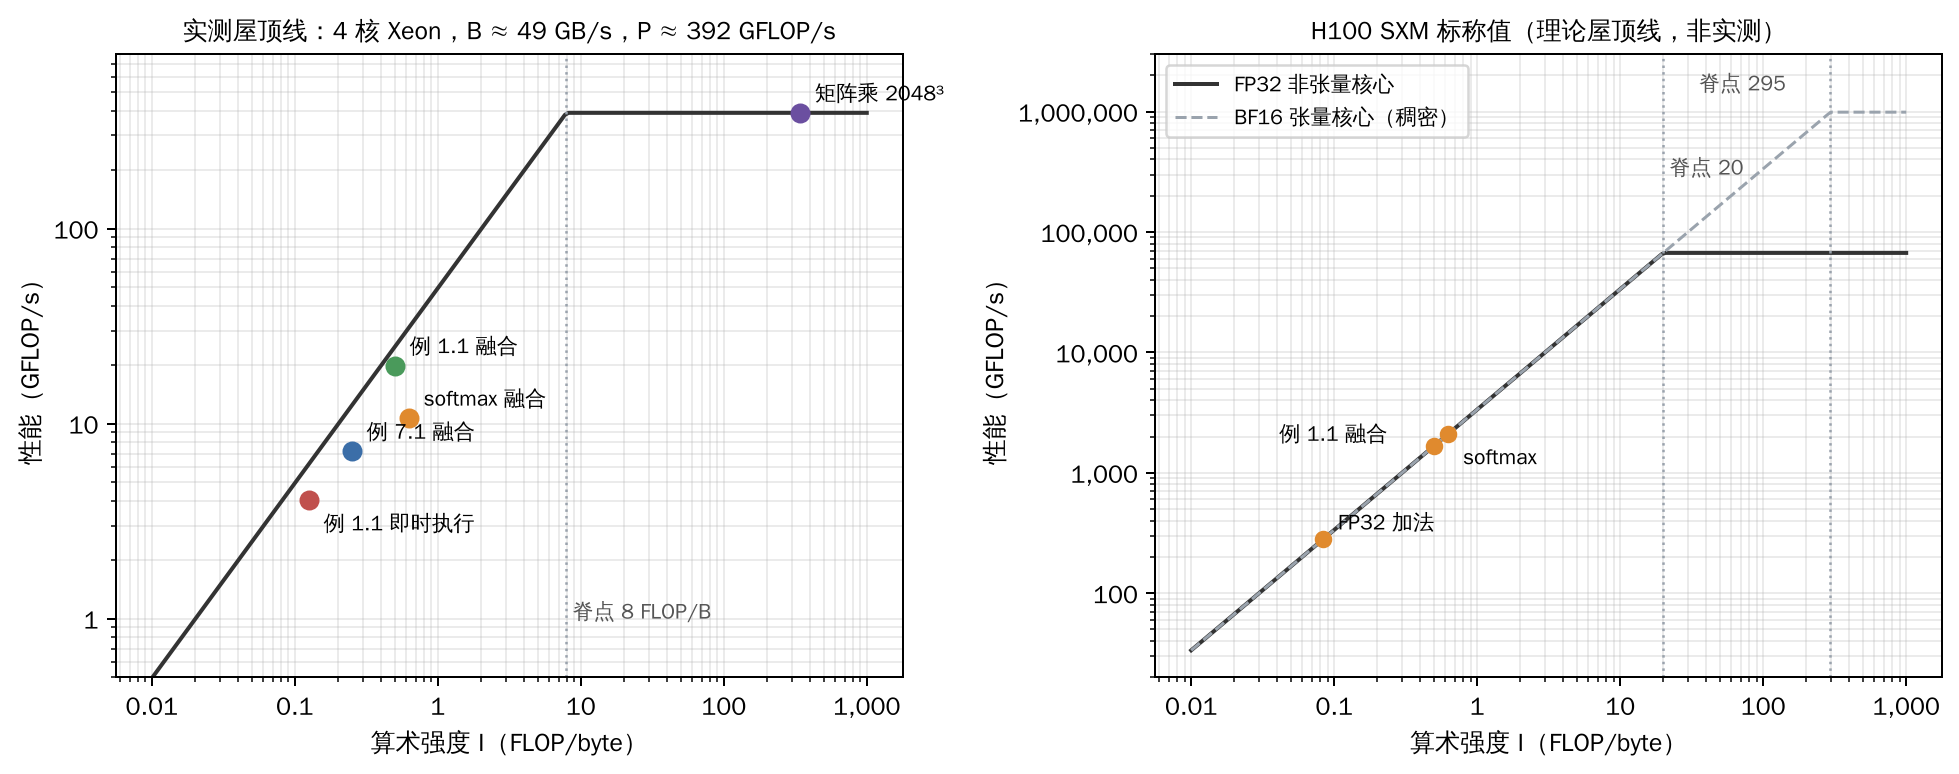
图 1.1 屋顶线模型。左:在第 13 节所用的 4 核 CPU 上实测的屋顶线,带宽与算力按命题 13.1 取多次测量中的最好值;圆点是第 13 节测得的几个内核。右:H100 SXM 的标称屋顶线,虚线为 BF16 张量核心。逐元素与规约类运算的算术强度都在 1 FLOP/byte 以下,位于两张图的斜线段上。
图 1.1 左图中,例 1.1 的即时执行与融合执行都位于斜线下方不远处,达到带宽上限的 65% 至 80%:二者的差别主要在要搬运的字节数。第 13 节给出具体数字,并把加速比分解为字节之比与带宽效率之比(命题 13.3)。
例 1.1 设
import tensorplay as tp

def f(x, w):
    return (tp.relu(x + w) * 2).sum(-1)

x = tp.randn(64, 128)
w = tp.randn(64, 128)
cf = tp.compile(f, strict_native=True)
y = cf(x, w)
设 $x$、$w$ 各含 $N$ 个 float32 元素。在即时执行(eager)模式下,f 依次启动 add、relu、mul、sum 四个内核,产生三个与输入同形的中间张量。各内核的读写量如表 1.1 所示。
表 1.1 例 1.1 在即时执行下的访存量(单位:元素)
| 内核 | 读 | 写 |
|---|---|---|
| add | $2N$ | $N$ |
| relu | $N$ | $N$ |
| mul | $N$ | $N$ |
| sum | $N$ | $N/128$ |
| 合计 | $5N$ | $3N + N/128$ |
总访存约为 $8N$ 个元素,即 $32N$ 字节;浮点运算约为 $4N$ 次,算术强度约为 $0.125$ FLOP/byte。若四个算子融合为单一内核,则只需读取 $x$、$w$ 各一次并写出 $N/128$ 个结果,访存约为 $2N$ 个元素即 $8N$ 字节,算术强度提高到约 $0.5$ FLOP/byte。融合后的内核仍受访存限制,但访存量降为原来的四分之一,在带宽受限的前提下执行时间也约降为四分之一。算子融合(operator fusion)的收益即来自消除中间张量在主存中的往返。
上述 $2N$ 并非偶然,它是一般规律的特例。
命题 1.1(访存下界) 设一个计算区域的外部输入集合为 $\mathcal I$,外部输出集合为 $\mathcal O$。假定:(1)输出的每个元素都依赖于某些输入元素,且每个输入元素都被至少一个输出元素依赖;(2)区域开始时输入只位于主存,结束时输出须全部位于主存;(3)片上存储初始为空。则任何实现与主存之间的传输量满足
$$Q \ge \sum_{v\in\mathcal I} b(v) + \sum_{v\in\mathcal O} b(v).$$若片上存储足以容纳计算每个输出元素所需的全部中间值,则将整个区域融合为一个内核、每个输入元素只读一次且不写出任何中间值的实现达到这一下界。
证明 由假定(1)与(3),每个输入元素的值必须至少一次从主存进入片上,否则依赖它的输出无法算出,故读入量至少为 $\sum_{v\in\mathcal I} b(v)$;由假定(2),每个输出元素至少写出一次。两部分传输方向不同,不能相互抵消,得到下界。对于可达性:若中间值全部留在片上,则主存传输只剩输入的读取与输出的写回,且每个元素各一次,恰为下界。$\square$
假定(1)把"只读取输入的一部分"的区域排除在外,例如只读取首行的切片;这类区域的下界应以实际被依赖的元素计算。可达性所需的片上容量条件对逐元素运算平凡成立;对规约之后再广播回原形状的运算(例 7.1),一行的全部元素须在片上停留到行和算出之后,行很长时条件不再成立,这正是 6.6 节实体化决策要处理的情形。
命题 1.1 说明了融合的上限:它把访存量压到输入与输出之和,此后进一步的加速只能来自提高带宽利用率,而不再来自减少字节数。它也说明了融合的限制:片上存储有限,若一个中间值须被远处的计算再次使用(例如规约之后的广播),或须交给无法融合的外部内核(例如矩阵乘),则它必须写回主存。第 6、7 节讨论的实体化与融合,正是在这一限制下逼近该下界。
参数 strict_native=True 要求编译失败时报错,而不退回即时执行。Stax 为例 1.1 生成的 CPU 内核如代码清单 1.1 所示。
代码清单 1.1 例 1.1 的融合内核(CPU)
#pragma omp parallel for
for (int64_t x0 = 0; x0 < 64; x0 += 1) {
    auto acc = Vectorized<float>(0);
    for (int64_t x1 = 0; x1 < 128; x1 += 16) {
        auto tmp0 = Vectorized<float>::loadu(in_ptr0 + 128*x0 + x1, 16);   // x
        auto tmp1 = Vectorized<float>::loadu(in_ptr1 + 128*x0 + x1, 16);   // w
        auto tmp2 = tmp0 + tmp1;                                     // add
        auto tmp3 = clamp_min(tmp2, decltype(tmp2)(0));              // relu
        auto tmp6 = tmp3 * Vectorized<float>(2.0f);                  // mul
        acc = acc + tmp6;                                            // sum
    }
    out_ptr0[x0] = vec_reduce_all(add, acc);
}
四个算子被合并为一个二重循环。外层 64 行由 OpenMP 并行执行;内层每次处理 16 个 float,对应 AVX-512 向量寄存器的宽度。加法、截断(relu)、乘法与累加均在寄存器中完成,每行写回一个结果,三个中间张量均未分配。与即时执行结果相比,最大绝对误差为 $1.5\times10^{-5}$,属于累加顺序不同引起的浮点舍入差异(6.5 节)。
同一函数以 CUDA 设备为目标时,Stax 生成的是代码清单 1.2 中的 Triton 内核。
代码清单 1.2 例 1.1 的融合内核(GPU,Triton;省略了导入语句与装饰器参数)
@triton_heuristics.persistent_reduction(size_hints={'x': 64, 'r0_': 128}, ...)
@triton.jit
def triton_per_fused_0(in_ptr0, in_ptr1, out_ptr0, xnumel, r0_numel, XBLOCK : tl.constexpr):
    xnumel = 64
    r0_numel = 128
    R0_BLOCK: tl.constexpr = 128
    xoffset = tl.program_id(0) * XBLOCK                      # 本实例负责的起始行
    xindex = xoffset + tl.arange(0, XBLOCK)[:, None]         # 行下标向量  [XBLOCK, 1]
    xmask = xindex < xnumel
    r0_index = tl.arange(0, R0_BLOCK)[None, :]               # 列下标向量  [1, 128]
    r0_1 = r0_index
    x0 = xindex
    tmp0 = tl.load(in_ptr0 + (r0_1 + 128*x0), xmask, eviction_policy='evict_first', other=0.0)   # x
    tmp1 = tl.load(in_ptr1 + (r0_1 + 128*x0), xmask, eviction_policy='evict_first', other=0.0)   # w
    tmp2 = (tmp0 + tmp1)                                                                          # add
    tmp3 = tl.full([1, 1], 0, tl.int32)
    tmp4 = tl.maximum(tmp3, tmp2, tl.PropagateNan.ALL)                                            # relu
    tmp5 = tl.full([1, 1], 2.0, tl.float32)
    tmp6 = (tmp4 * tmp5)                                                                          # mul
    tmp7 = tl.broadcast_to(tmp6, [XBLOCK, R0_BLOCK])
    tmp9 = tl.where(xmask, tmp7, 0)
    tmp10 = tl.sum(tmp9, 1)[:, None].to(tl.float32)                                               # sum
    tl.store(out_ptr0 + (x0), tmp10, xmask)
两份代码出自同一个循环级描述(6.3 节),算子与语句一一对应:add、relu、mul、sum 依次对应 C++ 中的 tmp2、tmp3、tmp6、acc,也对应这里的 tmp2、tmp4、tmp6、tmp10。差别在于并行的组织方式。CPU 内核以 OpenMP 分配外层的 64 行,内层循环每次处理一个 16 宽的向量;GPU 内核没有显式循环,每个程序实例以 [XBLOCK, 128] 的二维块一次处理 XBLOCK 行,由网格中的多个实例覆盖全部 64 行。xmask 屏蔽最后一个块中超出 64 行的部分,规约维恰为 128,无须掩码。第 9 节逐段解释这一内核。
1.2 编译栈的总体结构
图 1.2 给出 Stax 编译栈的总体结构。
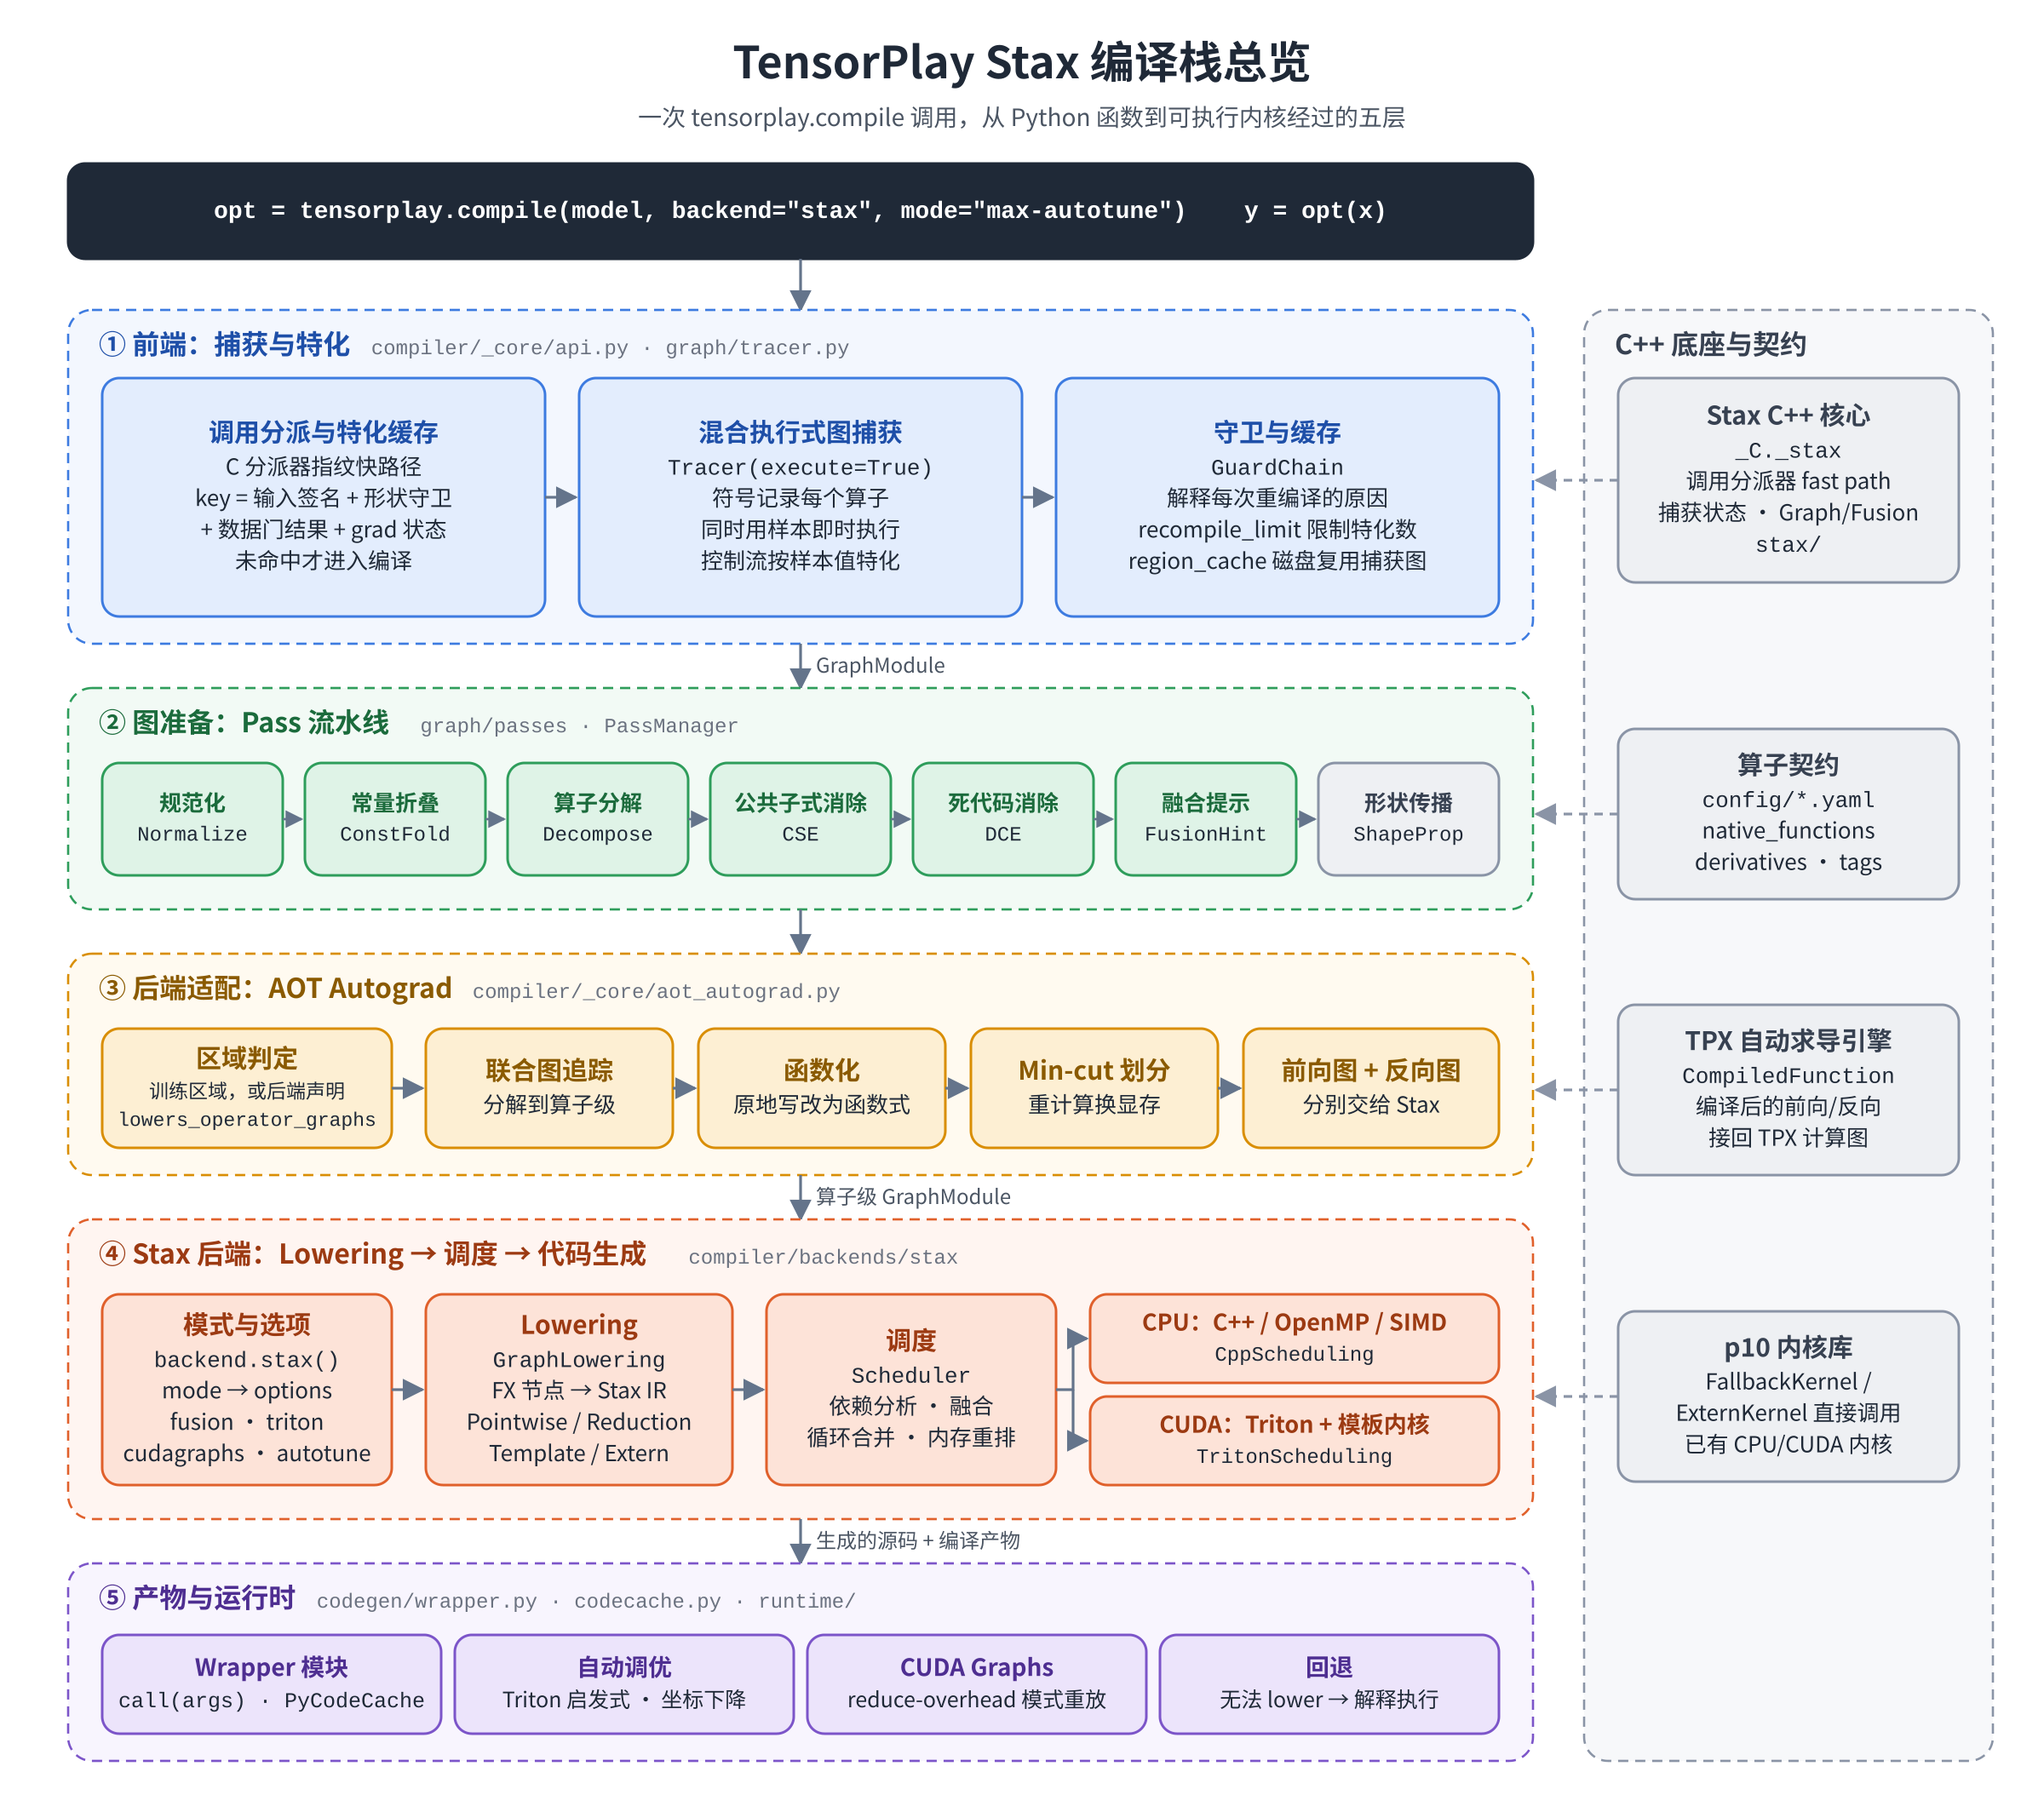
图 1.2 Stax 编译栈的总体结构。左侧为 Python 侧主流程,右侧为其依赖的 C++ 组件:调用分派器、算子定义(config 目录下的 yaml 文件)、TPX 自动求导引擎与 p10 内核库。
前端与后端之间的接口约定为
backend(graph_module, example_inputs, **options) -> callable
即后端只接收一个已捕获的 GraphModule 与一组样例输入,返回一个可调用对象。Python 的控制流全部由前端处理,后端无需感知。Stax 是注册在该接口上的默认后端,TVM、ONNX Runtime、CUDA Graphs 等后端以同样的方式接入。这一约定使前端的捕获策略与后端的实现可以独立替换:同一个捕获结果可以交给不同后端比较,同一个后端也可以接收不同前端产生的图。
1.3 中间表示的层次
一次编译依次经过五种程序表示,每一层只解决一类问题,并向下一层交付更具体的描述。表 1.2 列出各层的表示、主要决策与对应章节。
表 1.2 Stax 编译栈的中间表示
| 层次 | 程序表示 | 本层作出的主要决策 | 章节 |
|---|---|---|---|
| 调用 | Python 函数与特化缓存 | 使用哪个已编译版本,是否需要重编译 | 2 |
| 捕获 | Python 层 GraphModule(节点为 Python 调用) | 控制流走向,哪些值读取了数据 | 3、4 |
| 算子 | 算子级 GraphModule(节点为算子重载) | 前向与反向的划分,保存哪些激活 | 5 |
| 循环 | 循环级中间表示(Pointwise、Reduction、ComputedBuffer) | 哪些值写入内存,规约如何拆分,视图如何寻址 | 6 |
| 内核 | 调度节点与内核源码、包装函数 | 哪些循环合并为同一内核,如何分块、并行与分配内存 | 7 至 9 |
越往下,表示越接近机器,可作的优化越具体,但可见的程序结构也越少。例如在捕获层,F.gelu 是一个节点;在算子层,它是一个算子重载;在循环层,它已成为若干 ops 调用组成的函数,与相邻的逐元素运算不再有边界。编译器的设计要点之一,是让每个决策在信息恰好充分的那一层作出。
1.4 记号
本章使用以下记号。$N$ 表示张量的元素个数,$b(v)$ 表示值 $v$ 的字节数。$R$ 表示迭代范围(逐元素维度),$R_r$ 表示规约范围。$\mathbb V$ 表示标量值的集合。代码中的 x0、x1 为逐元素维度的循环下标,r0_ 为规约维度的下标,Triton 内核中的 xindex、yindex、r0_index 为对应维度的下标向量。XBLOCK、YBLOCK、R0_BLOCK 为各维度的分块大小。张量的布局以 size 与 stride 两个元组描述,元素 $(i_0, \dots, i_{k-1})$ 的偏移为 $\sum_j i_j \cdot \mathrm{stride}_j$。
本章的陈述分为三类。定理与命题是脱离具体实现也成立的数学结论,附有证明;其中引自文献的结论标为定理并注明出处。性质是关于 Stax 构造方式的陈述,例如"降级规则以函数复合实现融合",它的成立依赖于代码的写法,“说明"给出的是从实现读出的理由而不是证明,代码改变时须重新核对。算法与启发式规则描述 Stax 实际采用的做法,一般不带最优性保证,正文会说明它近似的是哪一个优化问题。
本章的实测数据(第 13 节)以 TensorPlay 开发分支的 CPU 构建在一台 4 核 Intel Xeon(AVX-512,2.8 GHz)上测得,代码清单中的生成代码也来自开发分支。GPU 上的结论(第 9 节)与动态形状的结论(第 10 节)以源码与测试为据,没有相应的实测数据。
2 特化与缓存
2.1 即时编译作为程序特化
Python 函数的行为可以依赖于参数的任何性质:形状、数据类型、标量参数的值,甚至张量中的数据。编译器不可能为所有输入生成同一份高效代码,它所做的是程序特化(program specialization):在一个具体的输入上确定那些影响程序结构的量,把它们当作常量,生成只对"这些量取相同值"的输入有效的代码。这是部分求值(partial evaluation)[2] 的思想:把程序的输入分为静态部分与动态部分,对静态部分预先求值,得到只接受动态部分的剩余程序(residual program)。即时编译的特点在于,静态部分不是由程序员事先声明的,而是由编译器在首次调用时观察得出。
为表述这一思想,设被编译的函数为 $f: X \to Y$。
定义 2.1(特化键与特化版本) 称映射 $\kappa: X \to \mathcal K$ 为特化键函数,$\kappa(x)$ 为输入 $x$ 的特化键。以输入 $x_0$ 捕获并编译得到的程序 $f_{x_0}$ 称为一个特化版本。若对一切满足 $\kappa(x) = \kappa(x_0)$ 的 $x$ 都有 $f_{x_0}(x) = f(x)$,则称该特化是正确的(sound)。
$\kappa$ 在输入集合 $X$ 上诱导出一个等价关系,每个等价类共用一个特化版本。$\kappa$ 越细,等价类越小,可以当作常量的量越多,生成的代码越专门,但所需的特化版本也越多;$\kappa$ 越粗,版本越少,但编译器能利用的信息越少。特化键的设计,就是在这两者之间选择一个使特化保持正确的最粗划分。
什么样的 $\kappa$ 能保证正确?追踪所得的程序只记录了张量运算,凡是在追踪中被当作常量使用的量,都必须进入键。
命题 2.1 设以 $x_0$ 追踪 $f$ 时,执行路径与生成的计算图只通过两类途径依赖于输入:(1)被记录为图中节点的张量运算;(2)有限个量 $q_1(x), \dots, q_m(x)$,其取值在追踪中被当作常量使用。若 $\kappa(x)$ 决定了 $(q_1(x), \dots, q_m(x))$,即 $\kappa(x) = \kappa(x_0)$ 蕴涵 $q_i(x) = q_i(x_0)$ 对一切 $i$ 成立,则特化是正确的。
证明 设 $\kappa(x) = \kappa(x_0)$。以 $x$ 重新执行 $f$ 时,每一个 Python 层的判断与常量都与追踪时相同,因此执行路径相同,所执行的张量运算序列也与图中记录的序列相同。图中每个节点以相同的运算作用于由 $x$ 计算出的张量,故 $f_{x_0}(x)$ 与 $f(x)$ 逐节点相等。$\square$
命题 2.1 把正确性归结为一个识别问题:编译器必须找出全部 $q_i$。第 3 节将看到,执行期追踪能够在每个 $q_i$ 被使用的地方截获它:形状读取、标量参数、按数据作出的分支判断,以及把张量转换为 Python 数值的操作。
2.2 特化键的构成
Stax 的特化键是一个四元组。
定义 2.2(特化键) 对一次调用,特化键为
$$\kappa(x) = (\sigma,\ \gamma_s,\ \gamma_g,\ \rho),$$其中 $\sigma$ 为输入签名;$\gamma_s$ 为形状分量,即追踪时被读取过形状的参数的精确形状;$\gamma_g$ 为数据门分量,即追踪时按数据值作出的各个判断在当前输入上重新求值的结果;$\rho$ 为当前的梯度模式。
输入签名 $\sigma$ 将每个参数按类型递归地映射为一个可比较的元组:
- 张量映射为(类型,形状,数据类型,设备,是否需要梯度,步长)。在动态形状模式下,形状一项只保留维数,步长一项改写为用各维大小表示的表达式(见下文);
None、布尔值、整数、浮点数与字符串映射为(类型,值),即按值特化;- 元组、列表与字典递归地映射其元素;
- 其他对象映射为(类型,对象身份)。
对照命题 2.1 可以理解各分量的来由。张量的形状与数据类型决定了每个算子的输出元数据,也决定了生成内核的循环范围与指令,因此进入 $\sigma$。Python 标量在追踪中直接参与运算,例如 x * k 中的 k 将作为常量写入内核,因此按值进入 $\sigma$。若某个标量在多次调用间频繁变化,应将其包装为 0 维张量传入,它便成为图的输入而非常量,只以元数据进入签名。
步长进入签名,是因为生成的内核按追踪时的步长写下标(8.5 节):两个形状相同、步长不同的张量(例如 x 与 x.t(),$x$ 为方阵)读取同一下标 $(i, j)$ 时访问的是不同的地址,按命题 2.1 应进入不同的等价类。具体形状模式下,签名直接记录步长元组,x 与 x.t() 分别得到 $(n, 1)$ 与 $(1, n)$,各自编译一份产物。
动态形状模式下不能照搬这一做法。连续张量的步长随形状变化(形状 $(s_0, s_1)$ 的步长为 $(s_1, 1)$),若直接记录数值,每换一个大小都会因步长不同而重新编译,动态形状便失去意义。Stax 因此把步长改写为相对于各维大小的表达式:按步长从小到大考察各维,步长为 1 记为常数 1;若某维的步长恰好等于前一维(更内层的维)的步长乘以其大小,就记为"该维大小 × 那一维的表达式”;否则记下具体数值。这样,任意大小的行主序张量都得到同一个表达式 $(\text{size}_1 \cdot 1,\ 1)$,转置得到 $(1,\ \text{size}_0 \cdot 1)$,二者不同;切片 x[:, ::2] 的内层步长为 2,扩展 expand 的步长为 0,都按数值记录。函数 _stride_signature(tensorplay/compiler/_core/api.py)实现了这一改写,测试 test/stax/test_compile_strides.py 验证了两条性质:连续、转置、扩展、切片四种布局各自编译一次,再次调用时全部命中;动态模式下大小为 4、6、8 的方阵与其转置只生成两个产物。
与此配套,追踪时为输入制作的替身也保持原有布局:编译器先按输入的形状、步长与偏移算出它在存储中覆盖的长度,复制这一段存储,再以相同的步长与偏移重新观察它。若替身总是连续的,追踪看到的布局便与调用时的实参不一致,生成的下标将对不上实参的布局。
动态模式下,各维大小与步长的具体关系仍由输入守卫逐一核对(10.4 节)。
$\gamma_s$ 的存在是因为动态形状模式只特化维数,而函数若在 Python 层读取了形状,例如 x.shape[0] 或 len(x),读到的长度已作为常量参与了计算,必须按精确值进入键。后端支持符号捕获时(Stax 即是),形状的读取保持为符号表达式,不再写入常量,$\gamma_s$ 只剩下嵌套在容器中的张量输入,对形状的判断改由形状守卫承担(10.4 节)。$\gamma_g$ 对应数据相关的控制流,其构造是第 3 节的主题。$\rho$ 进入键,是因为梯度模式开启时追踪的区域会为输出接入反向计算,在关闭时执行将产生契约不符的输出,反之亦然。
$\gamma_s$ 与 $\gamma_g$ 在首次编译之前无法确定,因为编译器事先不知道函数是否读取形状、是否依赖数据作出判断。首次追踪完成后,编译器才得知键的结构,并据此扩展键。因此键的结构由首次追踪决定,用户无需显式声明。
例 2.1 对 g(x, k) = x * k 以 k = 3 与 k = 4 各调用一次,两次调用的 $\sigma$ 在第二个参数的值项上不同,产生两个特化版本。若改为传入 tp.tensor(3.0) 与 tp.tensor(4.0),两次调用的签名相同,只产生一个版本,k 的值在运行时从张量中读取。
2.3 守卫
特化版本被调用之前,必须确认当前输入属于它的等价类。逐条检查这一条件的谓词称为守卫(guard)。
定义 2.3(守卫) 设特化键可以写为分量的元组 $\kappa(x) = (\kappa_1(x), \dots, \kappa_n(x))$,其中每个 $\kappa_i$ 对应签名结构中的一个位置。特化版本 $f_{x_0}$ 的守卫为谓词族
$$g_i(x):\ \kappa_i(x) = \kappa_i(x_0),\qquad i = 1, \dots, n.$$
由定义直接得到:所有守卫同时成立,当且仅当 $\kappa(x) = \kappa(x_0)$。这一构造称为守卫是键的投影。它有一个实用的推论。
推论 2.1(可解释性) 若输入 $x$ 在全部特化版本上都未命中,则对每个版本至少存在一个 $i$ 使 $g_i(x)$ 不成立,且不成立的守卫恰好指出了 $\kappa(x)$ 与该版本的键不相同的分量。
证明 由定义 2.3,版本 $f_{x_j}$ 命中当且仅当它的全部守卫成立,即 $\kappa(x) = \kappa(x_j)$。未命中即 $\kappa(x) \ne \kappa(x_j)$;两个元组不等,当且仅当存在分量 $i$ 使 $\kappa_i(x) \ne \kappa_i(x_j)$,而这恰是 $g_i(x)$ 不成立。因此对每个版本,不成立的守卫之集与不相等的分量之集相同,且非空。$\square$
若守卫与键分别维护,二者可能不一致:键已不同而守卫全部成立,或键相同而某条守卫失败,此时编译器既无法说明为什么重编译,也可能错误地复用版本。以投影的方式构造守卫,使这种不一致在结构上不可能发生。Stax 的每条守卫记录其在签名结构中的路径、条件表达式、期望值与实际值;开启重编译日志后,每次重编译都输出不成立的守卫(例 3.2)。
2.4 分派
每次调用都要计算特化键并在缓存中查找,这一开销须远小于内核本身的执行时间。Stax 将判定按代价由低到高分为三级,如算法 2.1 所示。
算法 2.1 调用分派
输入:实参 args、kwargs
输出:调用结果
1  if 张量对象与上次相同、版本号未变、无 kwargs、梯度模式未变、区域无数据门:
2      return 上次的编译产物(args)                     # 第一级:C 层
3  fp ← 各参数的指纹(张量取对象身份与版本号,标量取值)
4  if fp = 上次的指纹: (σ, γs, γg) ← 上次的键分量      # 第二级:指纹
5  else:               (σ, γs, γg) ← 计算签名与形状分量,重放数据门
6  K ← (σ, γs, γg, ρ)
7  fn ← cache[K]                                        # 第三级:特化缓存
8  if fn 不存在:
9      对每个已有版本检验守卫,记录不成立者
10     fn ← 编译(args, kwargs);cache[K] ← fn
11 记录 fn 为下一次调用的第一级入口
12 return fn(args)
第一级的判定条件比特化键严格得多:它要求参数是同一批对象,而不仅是键相同。之所以可以只检查对象身份与版本号,是因为张量的元数据在对象的生存期内不变,数据的任何原地修改都会使版本号递增;在区域没有数据门时,同一对象、同一版本的张量必然具有相同的特化键。这一级适用于以同一组缓冲区反复调用的场景。训练中的输入批次与参数持续变化,调用通常经由第二或第三级完成。
特化版本的个数设有上限(默认 8),总编译次数另有上限(默认 256)。前者防止缓存无限增长,后者防止在键持续变化的程序中反复编译。达到上限通常意味着键过细,应检查是否有按值特化的标量(2.2 节)或数值的消费(3.6 节)可以改写。
2.5 自由变量的提升
函数常常通过全局变量、闭包或模块属性访问张量,典型情形是模型参数。这些张量不在参数列表中,却在每次调用时才被读取:两次调用之间,它们可能被原地修改,名称也可能被重新绑定到另一个张量。若追踪时把它们当作常量写入编译产物,后续调用将读到过期的值,违反命题 2.1 的前提。
处理方法是把自由变量改写为显式参数,这一变换在函数式语言的编译中称为 lambda 提升(lambda lifting)[3]。Stax 从函数的字节码中收集以全局变量方式读取、当前绑定为张量的名称,遍历闭包单元与函数可达的模块,收集其中的张量、参数与缓冲区,然后构造一个新函数,其参数为这些自由张量加上原有参数。每次调用时,包装器从原位置读取这些张量的当前值,作为前导参数传入。经过提升,函数对外部状态的全部依赖都显式地出现在参数中,特化键与第一级分派中的版本号检查也就覆盖了它们。
例 2.2 设
scale = tp.ones(128)

def f(x):
    return x * scale

cf = tp.compile(f)
cf(x)
scale.mul_(2)      # 原地修改
cf(x)              # 结果反映修改后的 scale
scale 被提升为参数。第二次调用时,scale 的版本号已改变,第一级判定不成立;包装器读取 scale 的当前值传入,其签名未变,命中已有的特化版本,结果反映了修改后的值。
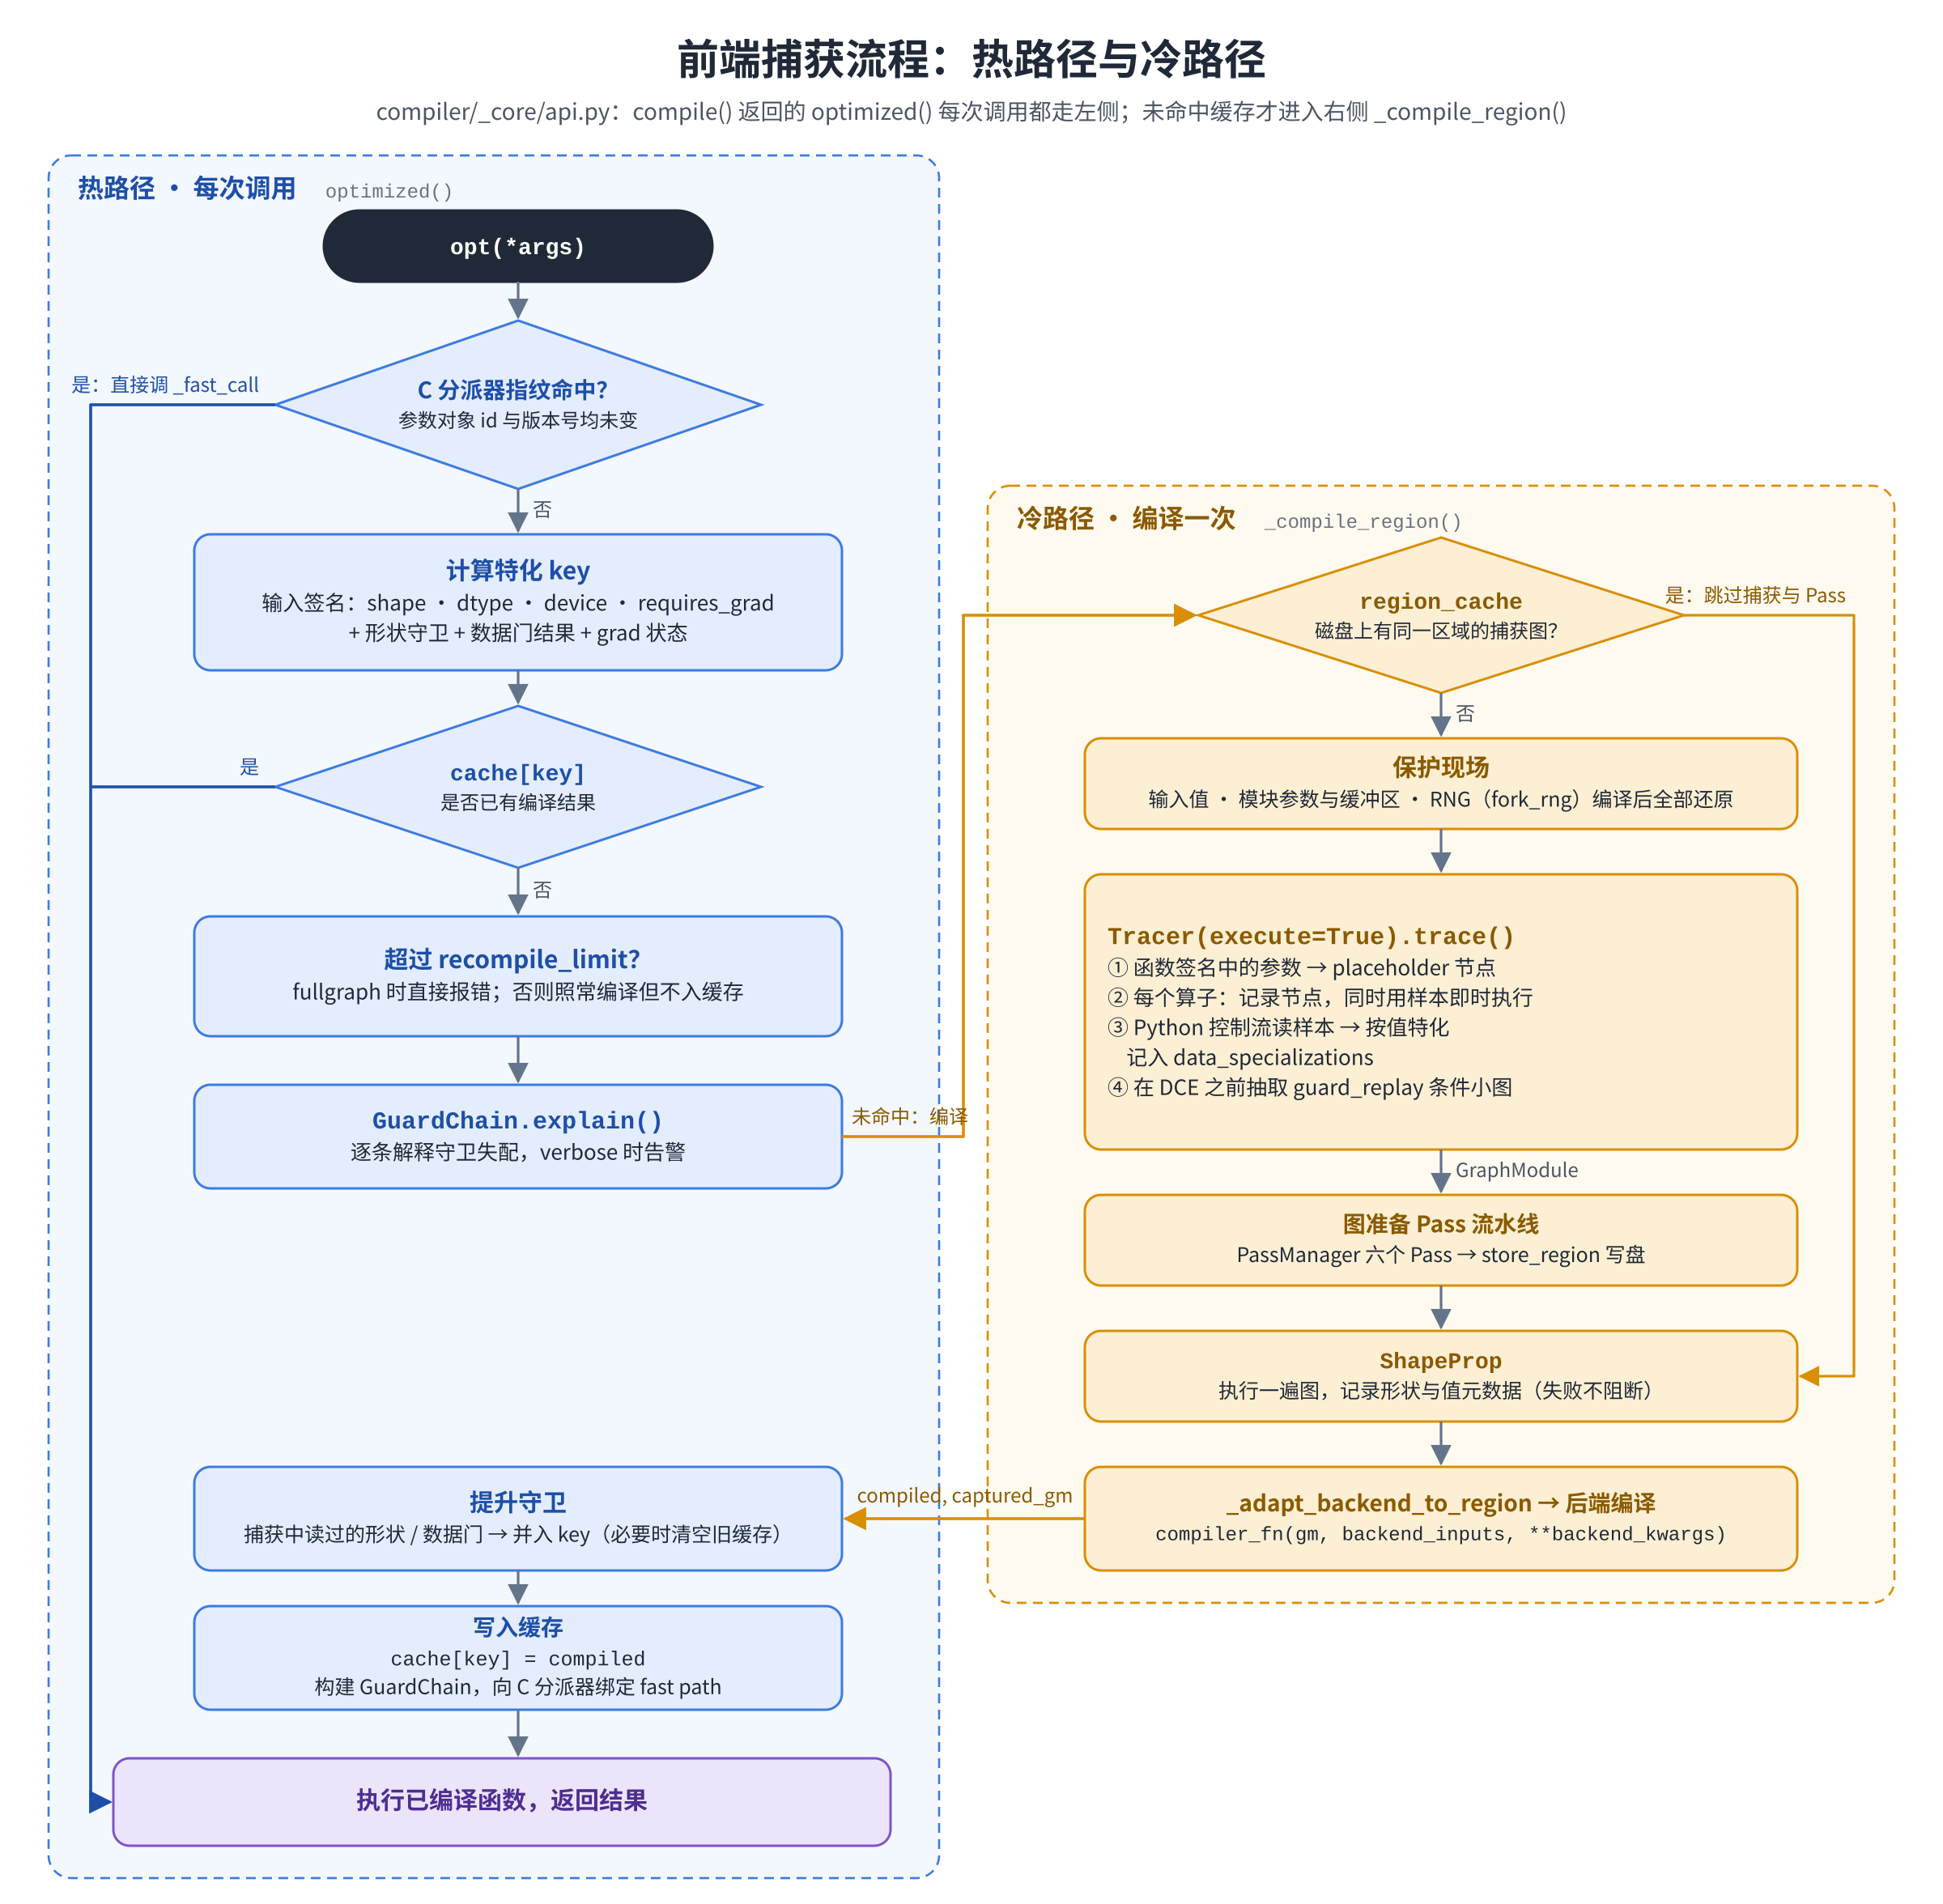
图 2.1 调用路径。左侧为每次调用均经过的分派路径,右侧为缓存未命中时进入的编译路径。
3 图捕获
3.1 计算图
捕获的结果是一个 GraphModule:它持有一张计算图,并由该图生成一段等价的 Python 源码作为其 forward。
定义 3.1(计算图) 计算图是一个有向无环图 $G = (V, E)$,连同 $V$ 上的一个全序。每个节点 $v \in V$ 代表一次运算,记录其操作码、目标(被调用的函数、方法或属性名)与参数;参数中出现的其他节点构成入边 $u \to v$,表示 $v$ 使用 $u$ 的值。全序须与边的方向相容,即为一个拓扑序。
每个节点恰好定义一个值,且该值在定义之后不再改变,因此计算图是静态单赋值形式(static single assignment,SSA)[4] 在无控制流程序上的特例。这一性质使数据依赖完全由边表达:一个值的全部使用者就是它的出边端点,判断一个值能否删除、能否合并、能否与使用者融合,都只需考察图的局部结构。
操作码共六种,见表 3.1。
表 3.1 节点的操作码
| 操作码 | 含义 | 目标 |
|---|---|---|
| placeholder | 函数的一个输入 | 参数名 |
| get_attr | 读取模块的属性(参数、缓冲区、常量) | 属性的限定名 |
| call_function | 调用一个自由函数,如 operator.add、tp.relu | 函数对象 |
| call_method | 调用张量的方法,如 x.sum(-1) | 方法名 |
| call_module | 调用一个子模块 | 子模块的限定名 |
| output | 函数的返回值 | 无 |
节点还带有一个元数据字典,其中最重要的一项是 val,即该节点在样例输入上的取值(3.3 节)。后续的图变换依赖它判断改写前后的类型与形状是否一致(4.2 节),自动微分层依赖它估计张量的字节数(5.3 节)。
例 1.1 的捕获结果如代码清单 3.1 所示。
代码清单 3.1 例 1.1 的捕获图
graph(
    %x : [num_users=1] = placeholder[target=x]
    %w : [num_users=1] = placeholder[target=w]
    %add shape=(64, 128) : [num_users=1] = call_function[target=operator.add](args = (%x, %w), kwargs = {})
    %relu shape=(64, 128) : [num_users=1] = call_function[target=tensorplay.functional.relu](args = (%add,), kwargs = {})
    %mul shape=(64, 128) : [num_users=1] = call_function[target=operator.mul](args = (%relu, 2), kwargs = {})
    %sum_0 shape=(64,) : [num_users=1] = call_method[target=sum](args = (%mul, -1), kwargs = {})
    return sum_0
)
捕获图中的节点仍是 Python 层的调用:operator.add 对应源码中的 +,sum 为张量方法调用。这一层不涉及算子重载与分派,第 5 节才将其改写为算子级的图。
3.2 代理追踪
构造计算图有两条途径:分析程序的源码或字节码,或者执行程序并记录它做了什么。TensorPlay 采用后者,即追踪(tracing)。追踪的结果是程序沿一条执行路径展开得到的直线程序(straight-line program):循环被展开,函数调用被内联,分支只保留实际走过的一侧。
追踪以运算符重载实现,这与运算符重载式的自动微分工具采用同一技术。追踪器为每个参数建立一个 placeholder 节点,并以代理对象(proxy)代替实参调用用户函数。代理重载了 Python 的算术与比较运算符,并实现了函数分派协议,使 tp.relu(p) 这类以代理为参数的库函数调用也被拦截。每次拦截都在图中新建一个节点,并返回包装该节点的新代理。函数返回时,返回值中的代理被收集为 output 节点的参数。
追踪默认进入子模块的 forward,记录其中的张量运算,而不是记录一个 call_module 节点。内联使后续各层看到完整的算子序列,融合因此可以跨越模块的边界。
3.3 执行期采样
纯符号的追踪只知道每个值如何计算,不知道它等于多少,因而无法回答 Python 层提出的任何关于值的问题。TensorPlay 的追踪器以混合模式运行:每记录一个节点,即在样例输入上实际执行该节点所代表的调用,并将结果保存在元数据 val 中。于是每个代理同时携带一个符号(图中的节点)与一个具体值(样例上的结果)。
执行在关闭梯度记录的状态下进行,不为样例计算构造反向图。执行是辅助性的:若某个节点在样例上执行失败,该节点保持符号状态,追踪本身不受影响,只有后续的控制流确实需要它的值时才报错。
3.4 数据相关的控制流
例 3.1 设
def f(x):
    if x.sum() > 0:
        return x * 2
    return x - 1
x.sum() > 0 的结果是一个代理,if 语句调用其 __bool__ 方法,要求一个 Python 布尔值。纯符号的追踪在此处无法继续,torch.fx [5] 的 symbolic_trace 即在此处报错。
在混合模式下,__bool__ 返回样例上的结果,追踪沿相应的分支继续。这一选择使追踪所得的图只对"走同一分支"的输入有效。借用符号执行 [6] 的术语,沿一条执行路径收集的全部分支条件的合取称为路径条件(path condition),追踪所得的图在路径条件成立的输入上与原程序等价。
定义 3.2(数据门) 追踪过程中,凡是 Python 层从张量数据得到一个具体值并据以决定后续执行的位置,称为一个数据门(gate)。设第 $k$ 个数据门的值为 $c_k = h_k(x)$,其中 $h_k$ 可由图中的节点计算,追踪时的取值为 $c_k^0 = h_k(x_0)$。数据门分量定义为
$$\gamma_g(x) = \bigl(h_1(x), \dots, h_m(x)\bigr).$$
数据门正是命题 2.1 中第二类依赖的一个来源:$c_k$ 被当作常量决定了执行路径,必须进入特化键。除 __bool__ 外,代理上还有其他几个把张量值转换为 Python 值的入口,处理方式见表 3.2。
表 3.2 数据特化的种类
| 种类 | 触发方式 | 处理方式 |
|---|---|---|
| bool | if、while、and、or、not | 取样例上的真假,记为数据门 |
| index | 以张量作下标或范围,如 x[:n]、range(n) | 取整数值,记为数据门 |
| int、float | int(t)、float(t) | 取样例上的值作为常量,记为数据门(3.6 节) |
| iter | 迭代一个样例为非张量序列的值 | 取序列内容,记为数据门 |
| 形状读取 | len(t)、t.shape | 记为元数据读取,形状进入 $\gamma_s$ |
形状读取与数据门的区别在于,形状可以直接从输入的元数据中取得,判断时无需执行任何计算;数据门的值则须由输入数据计算得出。
3.5 程序切片与守卫回放
数据门的值 $h_k(x)$ 须在每次调用时、在真实输入上重新计算,才能判断输入是否落在已有版本的等价类中。重新执行整个函数显然不可取,所需的只是计算各个 $h_k$ 的那部分程序。这在程序分析中称为程序切片(program slicing)[7]。
定义 3.3(反向切片) 在计算图 $G$ 中,节点集合 $D$ 的反向切片是 $D$ 中各节点及其全部祖先构成的子图,即
$$\mathrm{slice}(D) = \{\, u \in V \mid \text{存在从 } u \text{ 到某个 } d \in D \text{ 的有向路径} \,\} \cup D.$$
在有向无环图上,反向切片就是从 $D$ 出发沿入边的可达集合,可以用一次图遍历求得,如算法 3.1 所示。
算法 3.1 守卫回放子图的抽取
输入:计算图 G,数据门节点集合 D
输出:子图 M,数据门在样例上的取值 c⁰
1  needed ← ∅;pending ← D
2  while pending 非空:
3      n ← pending.pop()
4      if n ∈ needed: continue
5      needed ← needed ∪ {n}
6      将 n 的全部参数节点加入 pending
7  按 G 的拓扑序复制 needed 中的节点,得到 M;M 的输出为 D 中各节点
8  c⁰ ← 各数据门在样例上的取值
9  return M, c⁰
每个节点至多进入 needed 一次,每条边至多被考察一次,算法的时间复杂度为 $O(|V| + |E|)$。所得的子图 $M$ 称为守卫回放子图,每次调用时在真实输入上执行 $M$,即得 $\gamma_g(x)$。
回放所得的向量与追踪时的向量相等,是否恰好刻画了"走同一条路径"?下面的命题给出肯定的回答。
命题 3.1 设追踪路径上依次经过数据门 $1, \dots, m$。对任意输入 $x$,$\gamma_g(x) = \gamma_g(x_0)$ 当且仅当以 $x$ 执行 $f$ 时依次经过同样的 $m$ 个数据门、且每个数据门的取值与追踪时相同。
证明 对数据门的序号作归纳。设以 $x$ 执行 $f$ 时,前 $k$ 个数据门的取值与追踪时相同,则执行到第 $k+1$ 个数据门之前的路径与追踪路径一致,此时 $f$ 计算第 $k+1$ 个数据门的方式与图中记录的相同,其值等于 $M$ 在 $x$ 上算出的 $h_{k+1}(x)$。因此,若 $\gamma_g(x) = \gamma_g(x_0)$,归纳可推至全部 $m$ 个数据门;反之,若 $f$ 在 $x$ 上依次以相同取值经过这些数据门,则每个 $h_k(x)$ 都等于追踪时的取值。$\square$
命题 3.1 中的切片只依赖于图的结构,因此其抽取的时机至关重要。
推论 3.1 守卫回放子图必须在死代码消除之前抽取。
证明 数据门的值只被 Python 的 if 语句消费,并不流向图的输出。死代码消除删除一切不可达输出的节点(4.6 节),因此会删去计算数据门的节点。在其后抽取,切片中缺少这些节点,回放无法得到 $\gamma_g(x)$,命题 3.1 不再适用,编译产物将无法察觉分支的变化。$\square$
例 3.2 对例 3.1 的 f 依次调用:
cf = tp.compile(f, strict_native=True)
cf(tp.ones(4, 8))         # 输出全为 2
cf(-2 * tp.ones(4, 8))    # 输出全为 -3
cf(tp.ones(6, 8))         # 输出全为 2
三次结果均正确,缓存中最终有三个特化版本。本例的回放子图只含 sum 与比较两个节点。开启重编译日志后,输出的重编译原因为:
recompiling 'f': control-flow gate outcomes match the traced branch
recompiling 'f': inputs[0][0][2][0] == 4; inputs[0][0][2][0] == 4; control-flow gate outcomes match the traced branch
第一条对应第二次调用:签名相同,但数据门的取值不同。第二条对应第三次调用,它与两个已有版本分别比较:与第一个版本相比形状不同;与第二个版本相比形状与数据门均不同。这正是推论 2.1 所述的可解释性。路径 inputs[0][0][2][0] 依次指位置参数部分、第一个参数、张量签名中的形状项、形状的第 0 维。
3.6 数值的消费
int(x.max())、float(...) 等把张量转换为 Python 标量的操作同样是数据门,而且比 bool 型的数据门更细:其取值空间可能很大,每个不同的值都对应一个特化版本。这类转换不能返回符号值,因为 CPython 要求 __int__ 与 __float__ 返回精确的 int 与 float。
若一个数值只参与后续的张量运算,而不决定控制流,就没有必要特化它。tensorplay.graph.gate 用于显式声明这一点:被声明的值保持为 0 维张量的代理,作为图的运行时输入,只有显式调用 int() 或 float() 时才被固化。
例 3.3 比较以下两种写法:
def f1(x):
    n = int(x.sum())            # 数值进入特化键
    return x * n

def f2(x):
    n = tp.graph.gate(x.sum())  # 数值保持为张量
    return x * n
以形状为 $2\times3$ 的全 1 与全 2 张量各调用一次,两种写法的结果相同(首元素分别为 6 与 24),但 f1 有两个特化版本,f2 只有一个。若 f2 中再出现 if n > 3:,该比较的真假仍是数据门,但 n 本身不再进入键。按 2.1 节的说法,gate 把一个量从静态部分移到了动态部分。
3.7 副作用的隔离
追踪实际执行了用户函数。为使编译与否对调用方不可观察,追踪产生的副作用须予以隔离:
- 函数若原地修改了输入,追踪前先复制,追踪后恢复,调用方观察到的输入与未编译时一致;
- 模块状态(如归一化层的滑动统计量)作同样处理;
- 随机数生成器在追踪前分叉,追踪与编译过程消耗的随机数不推进调用方的生成器,编译版本与即时执行版本因而产生相同的随机序列。
纯 Python 的副作用,如打印、向外部列表追加元素,不在计算图中,只在追踪时发生一次。这是追踪这一构图方式的固有性质(12.1 节)。
4 图变换
捕获所得的图在交给后端之前,经过一组前端变换。这些变换的目的不是生成更快的代码,而是把图整理为规范、精简的形式,使后续各层面对的写法更少、节点更少。本节先给出图变换的一般框架,再逐一讨论各变换成立的条件。
4.1 改写系统与不动点迭代
一个图变换由若干改写规则组成。
定义 4.1(改写规则) 改写规则是一对图模式 $l \Rightarrow r$。若图 $G$ 中有一个子图与 $l$ 匹配,将其替换为 $r$ 的相应实例,所得的图记为 $G’$,称 $G$ 一步改写为 $G’$。若对一切输入 $x$ 都有 $\llbracket G’ \rrbracket(x) = \llbracket G \rrbracket(x)$,称该改写保持语义,其中 $\llbracket G \rrbracket$ 表示图所计算的函数。
保持语义是对每条规则的要求,4.2 至 4.6 节将逐一讨论。除此之外,一组规则作为整体还须满足终止性:改写不能无限进行。
TensorPlay 的前端依次执行六个变换:规范化(NormalizeOperators)、常量折叠(ConstFold)、分解(DecomposePass)、公共子表达式消除(CSE)、死代码消除(DCE)与逐元素区域标注(PointwiseFusionHint),称为一轮。若一轮中有任何变换改动了图,就再执行一轮,直到某一轮完全没有改动。换言之,变换序列被迭代到不动点。迭代是必要的,因为一个变换的输出可能为排在它前面的变换创造新的机会(例 4.2)。
命题 4.1(终止性) 设存在从图到良基集合的度量 $\mu$,使每个变换要么不改动图,要么使 $\mu$ 严格下降。则不动点迭代在有限轮内终止。
证明 每一轮若改动了图,则至少有一个变换改动了图,$\mu$ 至少下降一次,其余变换不使 $\mu$ 上升。良基集合中不存在无限下降链,故有改动的轮数有限。$\square$
对上述六个变换,可以取字典序的度量
$$\mu(G) = (\text{组合算子节点数},\ \text{节点总数},\ \text{常数位于左侧的二元运算数}).$$分解使第一个分量下降(分解产生的原语不再被分解),尽管它使节点总数增加;CSE、DCE 与恒等式消去使第二个分量下降;把常数移至右侧使第三个分量下降;区域标注只写入元数据,第二轮起不再改动图。实现中另设了 16 轮的上限,作为对规则集合将来被扩充时的保护。
需要注意,不动点迭代只保证终止,不保证结果与变换的执行顺序无关。改写系统若满足合流性(confluence),即任意两条改写路径最终可以汇合,则结果唯一;一般的规则集合并不满足这一性质。因此变换的顺序本身是设计的一部分:规范化排在最前,使后续的模式只需处理一种写法;CSE 排在分解之后,使不同组合算子分解出的相同子链得以合并;区域标注排在最后,使它看到的是最终的图。
4.2 代数恒等式与浮点语义
规范化变换实施三类改写:交换运算的标量常数移至右侧,如 2 * x 改写为 x * 2;消去代数恒等式,如 x * 1 改写为 x;无其他使用者的原地运算改写为非原地形式。前一类与后一类显然保持语义,问题集中在恒等式上。
在实数上,$x + 0 = x$、$x \cdot 1 = x$、$x \cdot 0 = 0$ 都是恒等式。但张量中的数是 IEEE 754 浮点数 [8],其值域包含 $\pm 0$、$\pm\infty$ 与 NaN,且运算的结果须经舍入。在这一语义下,恒等式是否成立须逐一检验,结果见表 4.1。
表 4.1 常见恒等式在 IEEE 754 语义下的成立情况
| 改写 | 是否精确成立 | 反例或说明 |
|---|---|---|
| $x \cdot 1 \Rightarrow x$ | 是 | 对一切 $x$,包括 $\pm 0$、$\pm\infty$、NaN |
| $x / 1 \Rightarrow x$ | 是 | 同上 |
| $x - 0 \Rightarrow x$ | 是 | $(-0) - (+0) = -0$ |
| $x + 0 \Rightarrow x$ | 否 | $(-0) + (+0) = +0$,零的符号改变 |
| $x + (-0) \Rightarrow x$ | 是 | 加法的真正单位元是 $-0$ |
| $-(-x) \Rightarrow x$ | 是 | 取负只翻转符号位 |
| $x \cdot 0 \Rightarrow 0$ | 否 | $\infty \cdot 0 = \mathrm{NaN}$,$\mathrm{NaN} \cdot 0 = \mathrm{NaN}$,$(-1) \cdot 0 = -0$ |
| $(x + y) + z \Rightarrow x + (y + z)$ | 否 | 舍入误差依赖于求和顺序(6.5 节) |
$x + 0 \Rightarrow x$ 只在零的符号上与原程序不同,而 $+0$ 与 $-0$ 在比较中相等,只有经过 $1/x$、copysign 或 atan2 才能区分。深度学习编译器通常接受这一改写,TensorPlay 亦然。$x \cdot 0 \Rightarrow 0$ 则会把 NaN 与无穷变为 0,掩盖数值异常,因此被排除在外。最后一行说明了一个更一般的事实:浮点运算不满足结合律,凡是改变运算顺序的变换都只在近似意义下保持语义,这一点在规约的拆分与向量化中尤为重要。
除了值以外,恒等式的消去还须保持张量的其他属性:
- 类型。整数张量加
0.0的结果为浮点张量,x + 0.0不能改写为x; - 形状。广播可能使
x + 0的形状大于x,例如当右端为形状 $4\times1$ 的零张量时; - 别名。若被改写的值是图的输出,而
x是图的输入,改写后输出与输入将共享存储,调用方对其中一个的修改会影响另一个,而原程序中二者是不同的张量。
前两点由节点元数据中的样例值判定,缺少样例值时不作改写;第三点由图的结构判定。
例 4.1 设 n(x) = (2 * x + 0).exp(),规范化前后的图如下(省略了节点元数据):
改写前:
    %mul = call_function[target=operator.mul](args = (2, %x))
    %add = call_function[target=operator.add](args = (%mul, 0))
    %exp = call_method[target=exp](args = (%add,))
改写后:
    %mul = call_function[target=operator.mul](args = (%x, 2))
    %exp = call_method[target=exp](args = (%mul,))
常数 2 移至右侧,+ 0 被消去。mul 的结果是图的中间值而非输出,类型与形状均不变,三个条件都满足。
4.3 常量折叠
常量折叠在编译时计算所有参数均为常量的运算。TensorPlay 只折叠 Python 标量之间的算术、比较与取下标运算,张量运算一律留给后端。原因在于,折叠一个张量运算意味着把其结果作为常量嵌入编译产物:若结果是大张量,编译产物随之膨胀,且每次调用都要从常量区读取它,而在运行时计算它往往同样快。Python 层的标量算术大多在追踪时已由解释器直接求值,因此这一变换主要处理其他变换新产生的常量表达式。
4.4 组合算子的分解
组合算子(composite operator)是可以表示为若干原语之组合的算子,如 selu、gelu、log1p。分解的收益在于:分解后的原语可以与相邻的逐元素运算融合,相同的子链可以由 CSE 合并。但分解也有代价。
其一是数值精度。以 $\log(1+x)$ 为例,设单位舍入误差为 $u$(float32 中 $u = 2^{-24}$)。先计算 $1 + x$ 得到 $\mathrm{fl}(1+x) = (1+x)(1+\delta)$,$|\delta| \le u$,再取对数,
$$\log \mathrm{fl}(1+x) = \log(1+x) + \log(1+\delta) \approx \log(1+x) + \delta.$$当 $|x|$ 很小时 $\log(1+x) \approx x$,故相对误差约为 $|\delta| / |x|$,可达 $u/|x|$。取 $x = 10^{-10}$,float32 中 $1 + x$ 舍入为 1,结果为 0,相对误差为 100%。专用的 log1p 实现避免了这一抵消,因此不应分解。$e^x - 1$ 与双曲函数同理。
其二是自动微分中的存储。在训练的联合图中,分解产生的每个中间值都可能被反向读取,而组合算子的专用求导规则往往只需要其输入(第 5 节)。
其三,组合算子本身往往已是一个融合的内核。只有当分解后的原语能与图中其他运算进一步融合时,分解才有收益。
据此,TensorPlay 对组合算子的处理如表 4.2 所示。保持原样的算子在第 6 节的降级阶段仍会展开为循环体中的标量运算,并在那里与相邻运算融合,因此不分解并不意味着放弃融合,只是推迟到了数值实现可控的那一层。
表 4.2 组合算子的处理
| 处理方式 | 算子 |
|---|---|
| 分解 | selu、relu6、mish、tanhshrink、hardshrink、softshrink、clamp、lerp、addcmul、addcdiv、logit、exp2、square、squared_difference、sec、csc、cot、deg2rad、rad2deg |
| 保持原样 | silu、gelu、elu、leaky_relu、hardtanh、hardsigmoid、threshold、softplus、log1p、expm1、log10、sinh、cosh、asinh、acosh、atanh |
| 可选分解 | softmax、log_softmax、group_norm(默认不分解) |
例 4.2 设
def s(x):
    y = x * 3
    return F.selu(y) + F.selu(y * 1) * 2
各变换的作用如下(只列出改动了图的变换,省略了节点元数据):
[第 1 轮] NormalizeOperators:y * 1 被消去,两处 selu 的参数都成为 %mul
[第 1 轮] DecomposePass:两处 selu 各展开为一条链
    %exp   = call_method[target=exp](args = (%mul,))
    %sub   = call_function[target=operator.sub](args = (%exp, 1))
    %mul_0 = call_function[target=operator.mul](args = (1.6732632423543772, %sub))
    %gt    = call_function[target=operator.gt](args = (%mul, 0))
    %where = call_function[target=tensorplay.functional.where](args = (%gt, %mul, %mul_0))
    %mul_2 = call_function[target=operator.mul](args = (1.0507009873554805, %where))
    %exp_0 = call_method[target=exp](args = (%mul,))
    ...(第二条链,结构相同)
[第 1 轮] CSEPass:两条链合并为一条,%mul_2 的使用者数变为 2
[第 1 轮] PointwiseFusionHint:全部节点标为同一个逐元素区域
[第 2 轮] NormalizeOperators:分解产生的 1.6732632423543772 * sub 与
          1.0507009873554805 * where 中的常数移至右侧
[第 3 轮] 无改动,迭代结束
此例说明了变换之间的相互作用:规范化消去 y * 1 之后,两处 selu 的参数才相同,CSE 才能合并;分解产生的常数位于左侧,需要第二轮的规范化才移到右侧。用命题 4.1 的度量来看,第 1 轮的分解使组合算子数由 2 降为 0,CSE 使节点总数下降,第 2 轮使左侧常数的个数下降,第 3 轮各分量均不再变化。
4.5 公共子表达式消除
公共子表达式消除(CSE)合并计算相同值的节点。在计算图上,它等价于编译原理中的值编号(value numbering):为每个节点计算键(目标,各参数的代表节点),键相同的节点计算同一个值,保留先出现者,其余节点的使用者改为指向它。
命题 4.2 按拓扑序处理节点,并以散列表记录已出现的键,则一遍扫描即可合并全部在语法上相同的节点,期望时间为 $O(|V| + |E|)$。
证明 处理节点 $v$ 时,其参数均已处理过,已被替换为各自的代表节点。若两个节点的目标相同、参数的代表节点相同,它们的键相同,在散列表中命中;否则它们的某个参数计算不同的值,或目标不同,不应合并。每个节点计算一次键,键的长度为其入度,故总时间与节点数和边数之和成正比。$\square$
值编号的前提是运算具有引用透明性,即相同的参数总是给出相同的结果,且运算没有可观察的副作用。随机算子(dropout、randn 等)违反前者,两次调用的结果不同;原地算子(add_、mul_ 等)违反后者,两次修改的效果会叠加。二者均被排除在 CSE 之外。CSE 也不识别交换律,x + y 与 y + x 只有在规范化统一了写法之后才能合并,这是规范化须先于 CSE 的另一个原因。
4.6 死代码消除
一个节点若其值不能到达任何输出,删除它不改变图所计算的函数,这样的节点称为死代码。在有向无环图上,活跃节点的集合就是从输出节点出发沿入边的可达集合,即输出节点集合的反向切片(定义 3.3)。DCE 求出这一集合,删除其余的节点,时间复杂度为 $O(|V| + |E|)$。
输入节点一律保留,即使未被使用,因为删除它会改变函数的调用约定。此外,有副作用的节点不论其值是否被使用都须保留。推论 3.1 正是从 DCE 的这一定义得出的:数据门的计算不能到达输出,在 DCE 看来就是死代码。
4.7 逐元素区域的标注
最后一个变换识别图中极大的逐元素区域,为区域内的节点写入区域编号。设可融合的逐元素算子构成节点子集 $P \subseteq V$,所求的区域即 $P$ 所诱导的子图在忽略边方向后的连通分量。算法采用并查集:每个 $P$ 中的节点初始为一个集合,对每条两端均在 $P$ 中的边合并两端的集合。按路径压缩与按秩合并实现时,总时间为 $O\bigl((|V| + |E|),\alpha(|V|)\bigr)$,其中 $\alpha$ 为反阿克曼函数。
例 1.1 的标注结果为
[('add', 'pointwise', 0), ('relu', 'pointwise', 0), ('mul', 'pointwise', 0), ('sum_0', None, None)]
add、relu、mul 构成区域 0,sum 不是逐元素算子,不在区域之内。这一标注供需要融合信息的后端使用。Stax 在循环级中间表示上另行判断融合(第 6、7 节),并能把规约也纳入融合的范围,这是图层面的连通分量所不能表达的。
4.8 算子级分解
4.4 节的分解作用于 Python 层的图,以方法名或函数名为键,目的是把组合算子展开为可融合的原语。图进入自动微分层后,还要在分派器层重新追踪一次(5.1 节),此时每个调用都已落到确定的算子重载上,分解也就可以在算子一级进行。TensorPlay 维护一张算子级的分解表,其中约有五百条规则,覆盖归一化、损失函数、填充、插值、激活函数的反向等算子。追踪时每遇到一个算子重载,分派器先查这张表:若有规则,就执行规则而不执行算子本身,记录下的是规则展开后的各个算子。
分解表并不全部生效。对一个后端而言,算子可以分为两类。
定义 4.2(后端的基) 称算子集合 $\mathcal B$ 为后端的基,若 $\mathcal B$ 中的每个算子都有该后端自己的实现,即降级规则(第 6 节)、模板或库调用。
Stax 由分解表与基构造实际使用的分解集合:一个算子只有在不属于 $\mathcal B$、且不产生随机数时才被分解。属于 $\mathcal B$ 的算子保持原样,交给后端以专门的方式实现;产生随机数的算子保持原样,因为随机算子不满足引用透明性(4.5 节),展开后各部分对随机数状态的消耗方式须另行保证一致。
命题 4.3 设对每个算子 $o$ 定义深度 $d(o)$:$o \in \mathcal B$ 或 $o$ 无分解规则时 $d(o) = 0$,否则 $d(o)$ 比其规则右端各算子的深度的最大值大 1。若深度对一切算子有定义(即规则之间不存在循环引用),则递归分解在有限步内终止,结果中的每个算子或属于 $\mathcal B$,或没有分解规则。
证明 对 $d(o)$ 归纳。$d(o) = 0$ 时 $o$ 不被分解。$d(o) = k > 0$ 时,$o$ 被替换为有限个深度小于 $k$ 的算子,由归纳假设每个都在有限步内分解完毕。$\square$
没有分解规则、又不属于 $\mathcal B$ 的算子成为回退内核(6.1 节),由框架原样执行。命题 4.3 与命题 4.1 是同一种论证:前者的度量是深度,后者的度量是字典序的三元组。
为什么属于 $\mathcal B$ 的算子不分解?以方差与均值为例。分解表把 var_mean 写为先求均值、再求偏差平方的均值,降级后是两次规约;Stax 的降级规则则以 6.5 节的 Welford 合并一次规约同时求出二者,访存减半,数值上也避免了 $\sum x^2 - n\bar x^2$ 式的抵消。layer_norm、softmax 的反向、gelu 的反向同理。分解是缺少专门实现时的退路,而不是首选。
例 4.3 分别编译 F.layer_norm(x, (8,), w, b) 与 F.mse_loss(x, y),交给 Stax 的算子级图如下(省略了元数据):
layer_norm:
    native_layer_norm = tp.native_layer_norm.default(primals_1, [8], primals_2, primals_3, 1e-05)
    getitem = getitem(native_layer_norm, 0)
mse_loss:
    sub  = tp.sub.Tensor(primals_1, primals_2)
    mul  = tp.mul.Tensor(sub, sub)
    mean = tp.mean.default(mul)
native_layer_norm 属于基,原样保留;mse_loss 没有降级规则,被分解为减法、乘法与均值三个原语,此后可以融合为一个规约内核。
4.9 函数化
前面的变换都假定图是纯函数:每个节点由其参数唯一确定,不修改任何已有的值。用户程序却可以含有原地修改,例如 x.mul_(2),以及对视图的原地修改,例如 y[0].add_(1) 修改的是 y 的第 0 行。原地修改使值编号与死代码消除的前提失效:同一个名字在不同时刻代表不同的值,删除一个"结果未被使用"的原地运算会改变程序的行为。
定义 4.3(函数化) 把一个含原地修改的图改写为不含原地修改的等价图,称为函数化(functionalization)。改写后,每个原地修改产生一个新值,此后对原值的使用都改为使用新值;若被修改的是图的输入,在图的末尾以一次复制把最终的值写回输入。
函数化与 SSA 构造 [4] 是同一个思想在存储上的推广:SSA 为每次赋值引入一个新名字,函数化为每次对张量的修改引入一个新值。困难之处在于视图。对视图 $v = \mathrm{view}(b)$ 的修改实际上修改了 $b$ 的一部分,因此函数化须同时产生 $b$ 的新值。设视图运算 $\mathrm{view}$ 有一个"散射逆"$\mathrm{scatter}(b, v’)$,它返回一个与 $b$ 相同、只在视图覆盖的位置取 $v’$ 的值的张量,则对视图的修改 $v \leftarrow g(v)$ 可以改写为
$$v' = g(\mathrm{view}(b)),\qquad b' = \mathrm{scatter}(b, v').$$命题 4.4 设视图运算与其散射逆满足 $\mathrm{view}(\mathrm{scatter}(b, v’)) = v’$,且 $\mathrm{scatter}(b, v’)$ 在视图未覆盖的位置与 $b$ 相同。则按上式改写对视图的原地修改后,$b’$ 与原程序执行修改后 $b$ 的内容逐元素相同。
证明 原程序中,视图覆盖的位置被写为 $g$ 作用于原内容的结果,即 $v’$ 的对应元素,其余位置不变。$b’$ 在视图覆盖的位置取 $v’$,其余位置取 $b$,二者一致。$\square$
切片、选择、转置等视图都有这样的散射逆,例如选择 select 对应 select_scatter。没有函数式重载的原地算子无法这样改写,此时把它整个包装为一个节点,标明其修改的参数;Stax 在降级之前把这种节点展开为"复制被修改的参数,再在副本上原地执行"的形式。
例 4.4 设
def f(x, y):
    x.mul_(2)
    y[0].add_(1)
    return x + y
函数化后的算子级图为(省略了元数据):
mul            = tp.mul.Scalar(primals_1, 2)
select         = tp.select.int(primals_2, 0, 0)
add            = tp.add.Scalar(select, 1, 1)
select_scatter = tp.select_scatter.default(primals_2, add, 0, 0)
add_0          = tp.add.Tensor(mul, select_scatter)
copy_          = tp.copy_.default(primals_1, mul)
copy__0        = tp.copy_.default(primals_2, select_scatter)
return (add_0,)
x.mul_(2) 成为函数式的 mul,此后对 x 的使用都改为使用 mul。y[0].add_(1) 成为三步:取视图 select,在其上计算 add,再以散射逆 select_scatter 得到 y 的新值。末尾的两个 copy_ 把新值写回输入,使调用方观察到的副作用与即时执行一致。图的主体此时是纯函数,4.5 与 4.6 节的变换可以安全地施加于其上。
函数化的代价是可能多出复制:原程序中原地完成的修改,函数化后需要一块新的存储。这一代价在调度阶段收回:若一个缓冲区在被某个内核读取之后不再被使用,且该内核的输出与它大小、类型相同、下标一致,该内核可以直接把结果写入这块缓冲区(7.5 节)。函数化与原地复用因此是一对互逆的变换:前者为了分析的方便消除原地修改,后者在分析完成后把它恢复。
4.10 变换的全景
至此可以把编译路径上的全部图变换按层次列出,如表 4.3 所示。
表 4.3 编译路径上的图变换
| 层次 | 变换 | 作用 | 节 |
|---|---|---|---|
| Python 层的图 | 规范化、常量折叠、分解、CSE、DCE、区域标注 | 统一写法,展开组合算子,删除冗余 | 4.1 至 4.7 |
| 算子级的图 | 算子级分解 | 把不属于后端基的算子展开为原语 | 4.8 |
| 算子级的图 | 函数化 | 消除原地修改与视图别名 | 4.9 |
| 联合图 | 最小割划分 | 决定保存与重算 | 5.4 |
| 循环级中间表示 | 降级、实体化 | 以函数复合完成逐元素融合 | 6.2、6.6 |
| 循环级中间表示 | 循环与下标的化简、值域分析 | 合并循环,化简下标,选择下标位宽 | 6.8 |
| 调度节点 | 拓扑排序、死节点消除、融合、按峰值内存重排、原地复用 | 决定内核的划分与次序 | 第 7 节 |
| 内核 | 内核内 CSE、分块选择、向量化 | 生成目标代码 | 第 8、9 节 |
越往下,变换所依据的信息越具体:Python 层只看到调用关系,算子级的图知道每个算子的确切语义,循环级中间表示知道每个元素的下标,调度节点知道每块缓冲区的大小与生存期。每一层只做在该层信息下能够证明保持语义的变换,这是变换被分散到各层而不是集中在一处的原因。图 4.1 给出了这些变换的执行顺序。
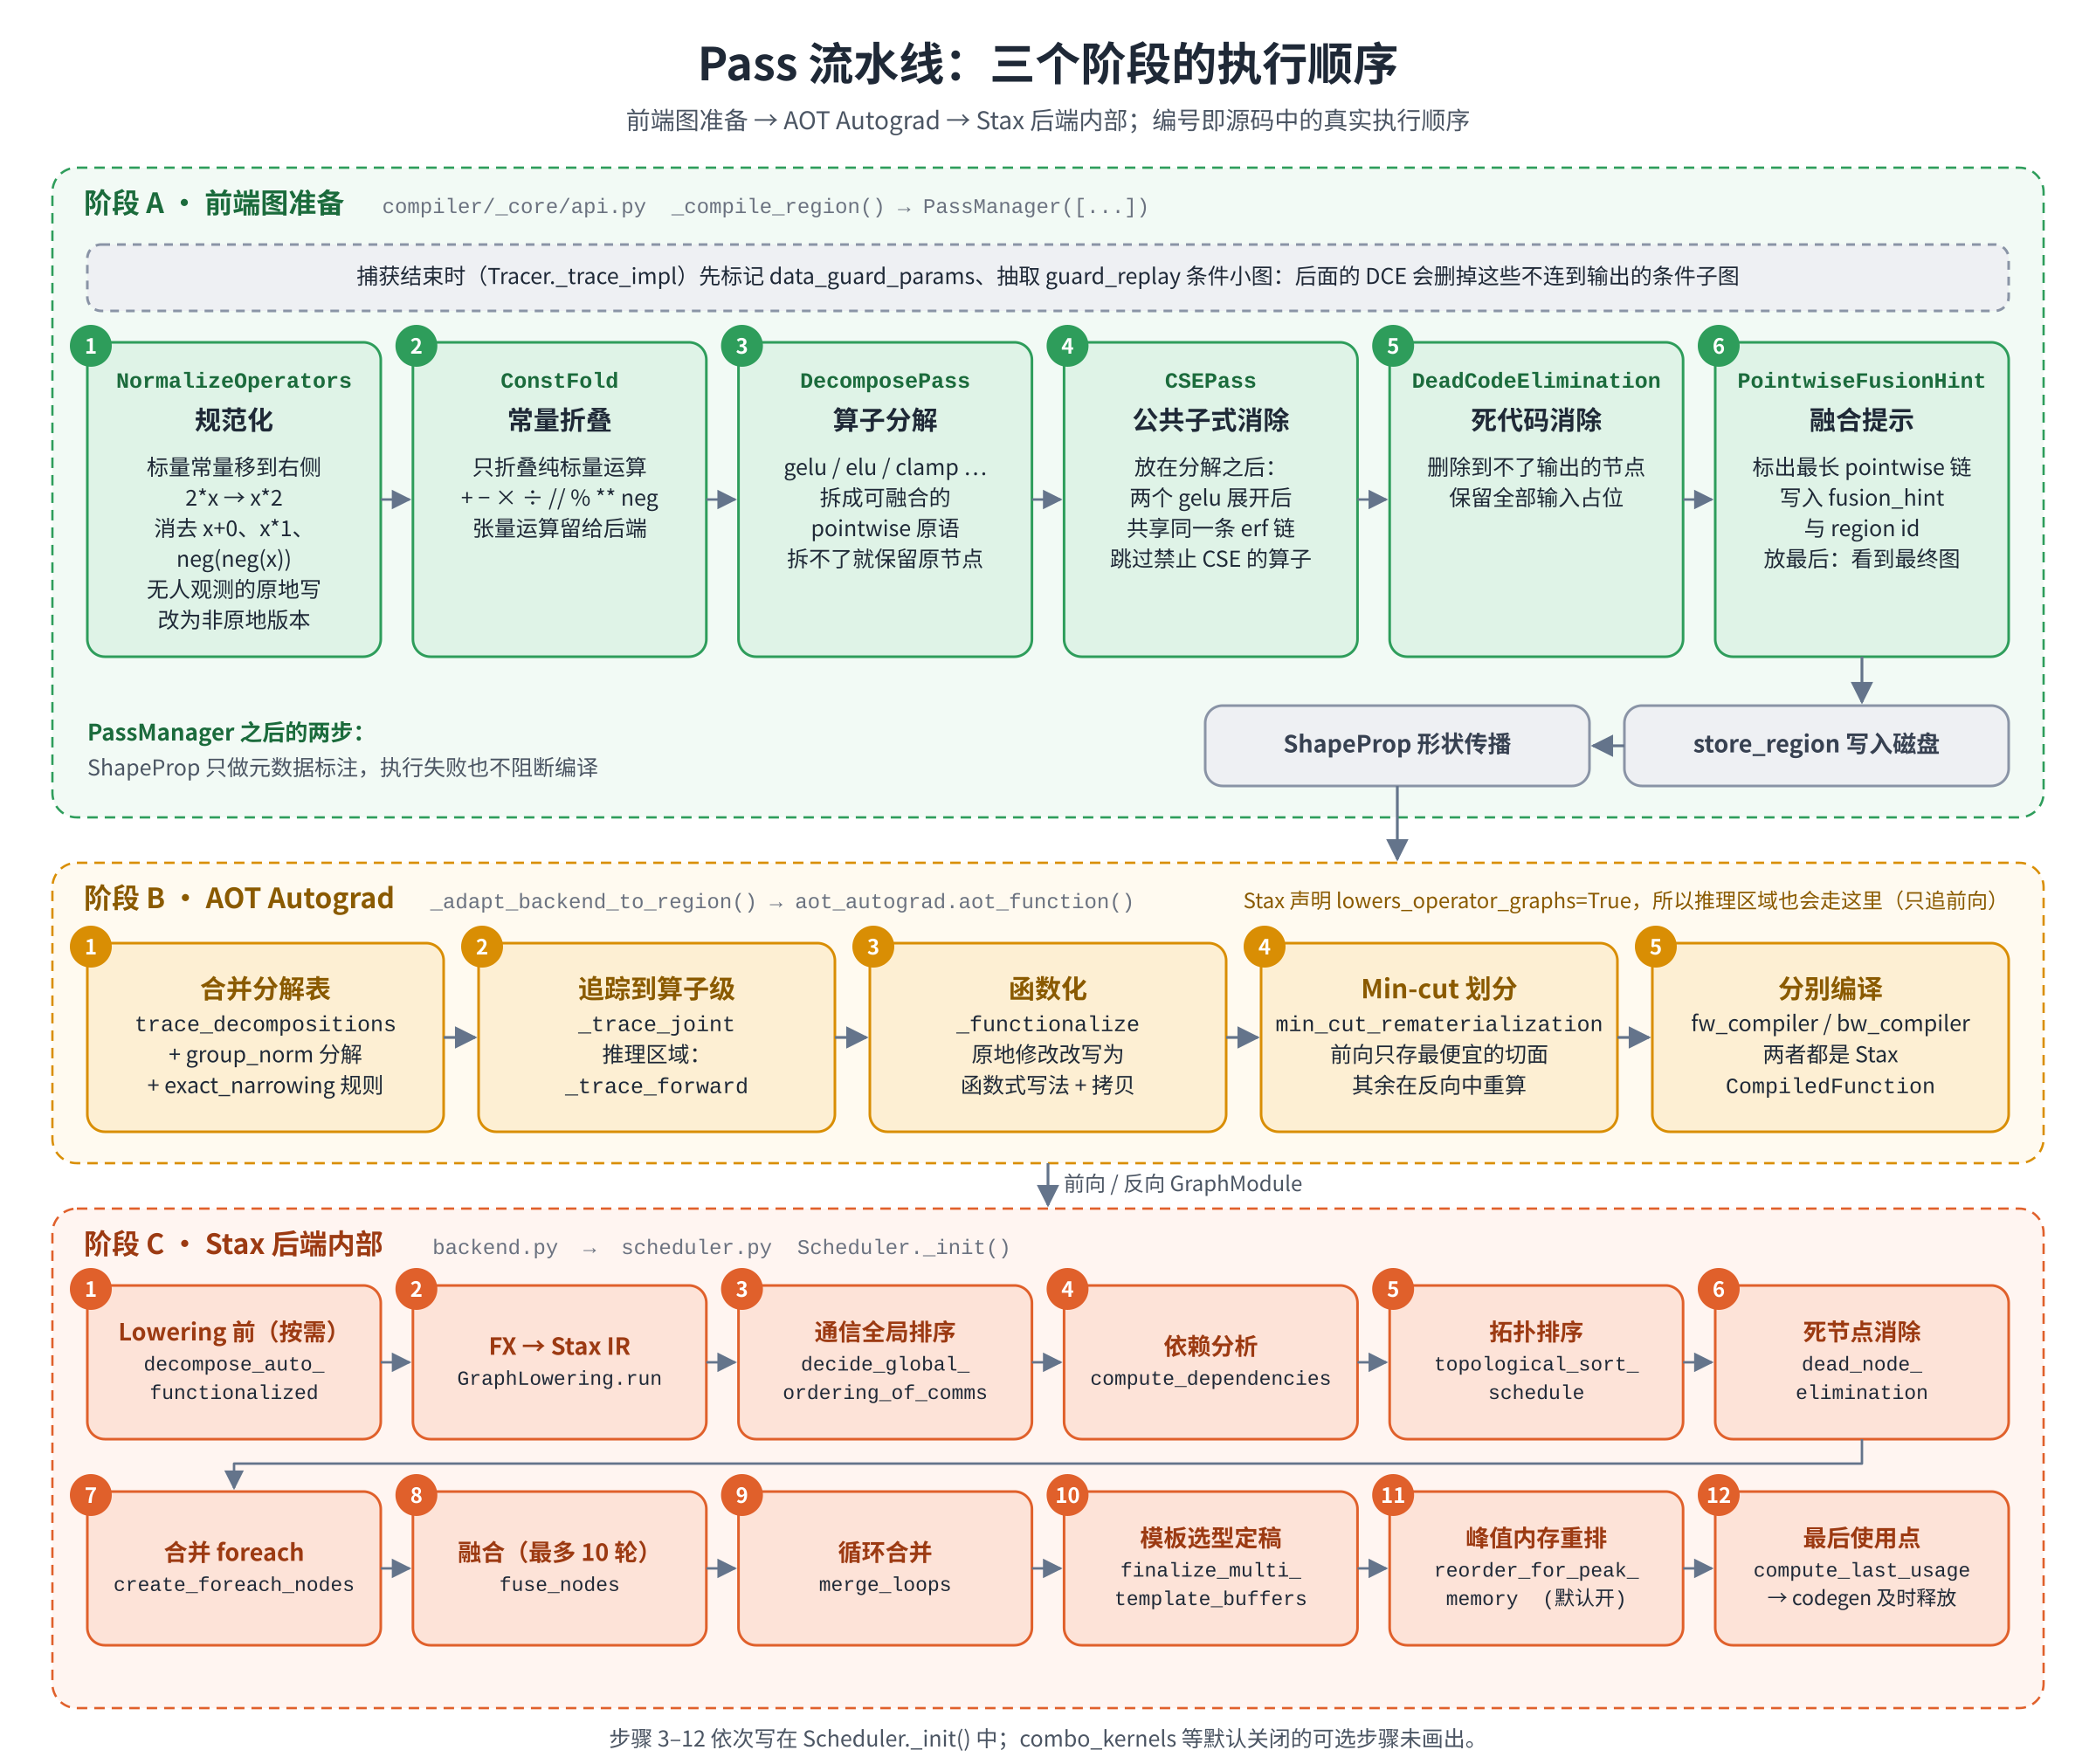
图 4.1 三个阶段的变换顺序。A 为本节的前端变换,B 为第 5 节的自动微分层,C 为调度器内部的步骤(第 7 节)。
目录 | 下一节:第二节 自动微分与降级