写一行 a + b,回车就有结果了。可这一行和真正做加法的那些指令之间,还隔着一套契约、一段代码生成,和一个运行时的分发器。
上一篇讲的是张量内存怎么来、怎么共享、怎么守版本。这一篇讲算子怎么跑起来:你调一个算子,框架怎么找到该干活的那个内核。简单说,通用逻辑交给机器生成,算子之间的差异写进契约,运行时靠一张分发表认路。写算子的人只管那行数学,参数校验、设备对齐、类型提升、梯度记录、版本更新这些碎活,框架顺手代办。
为什么不全程手写
逐元素算子的差异,本质就是一行数学公式。可一个能用的算子远不止这一行:执行前得先校验入参个数、确认所有张量在同一块设备上、必要时做类型提升,要判断是否记录求导链路,就地运算还得更新版本号,顺便给 Profiler 留个埋点。
这些要是全靠手写,新增一个 relu 就得同步改四处:Tensor 类声明方法、分发器注册内核、绑定层暴露 Python 接口、自动微分层补求导公式。多端同步改容易漏,而且这种 bug 不崩——只是某个后端静默调了错的内核,结果算错。
TensorPlay 把这四处的共性交给代码生成器,差异写进统一契约,运行时的内核路由靠分发表自动完成。新增一个算子,落笔的地方只有两处:在契约文件里定义函数签名,再给对应的硬件内核写一行数学。
契约:两份 YAML 说了算
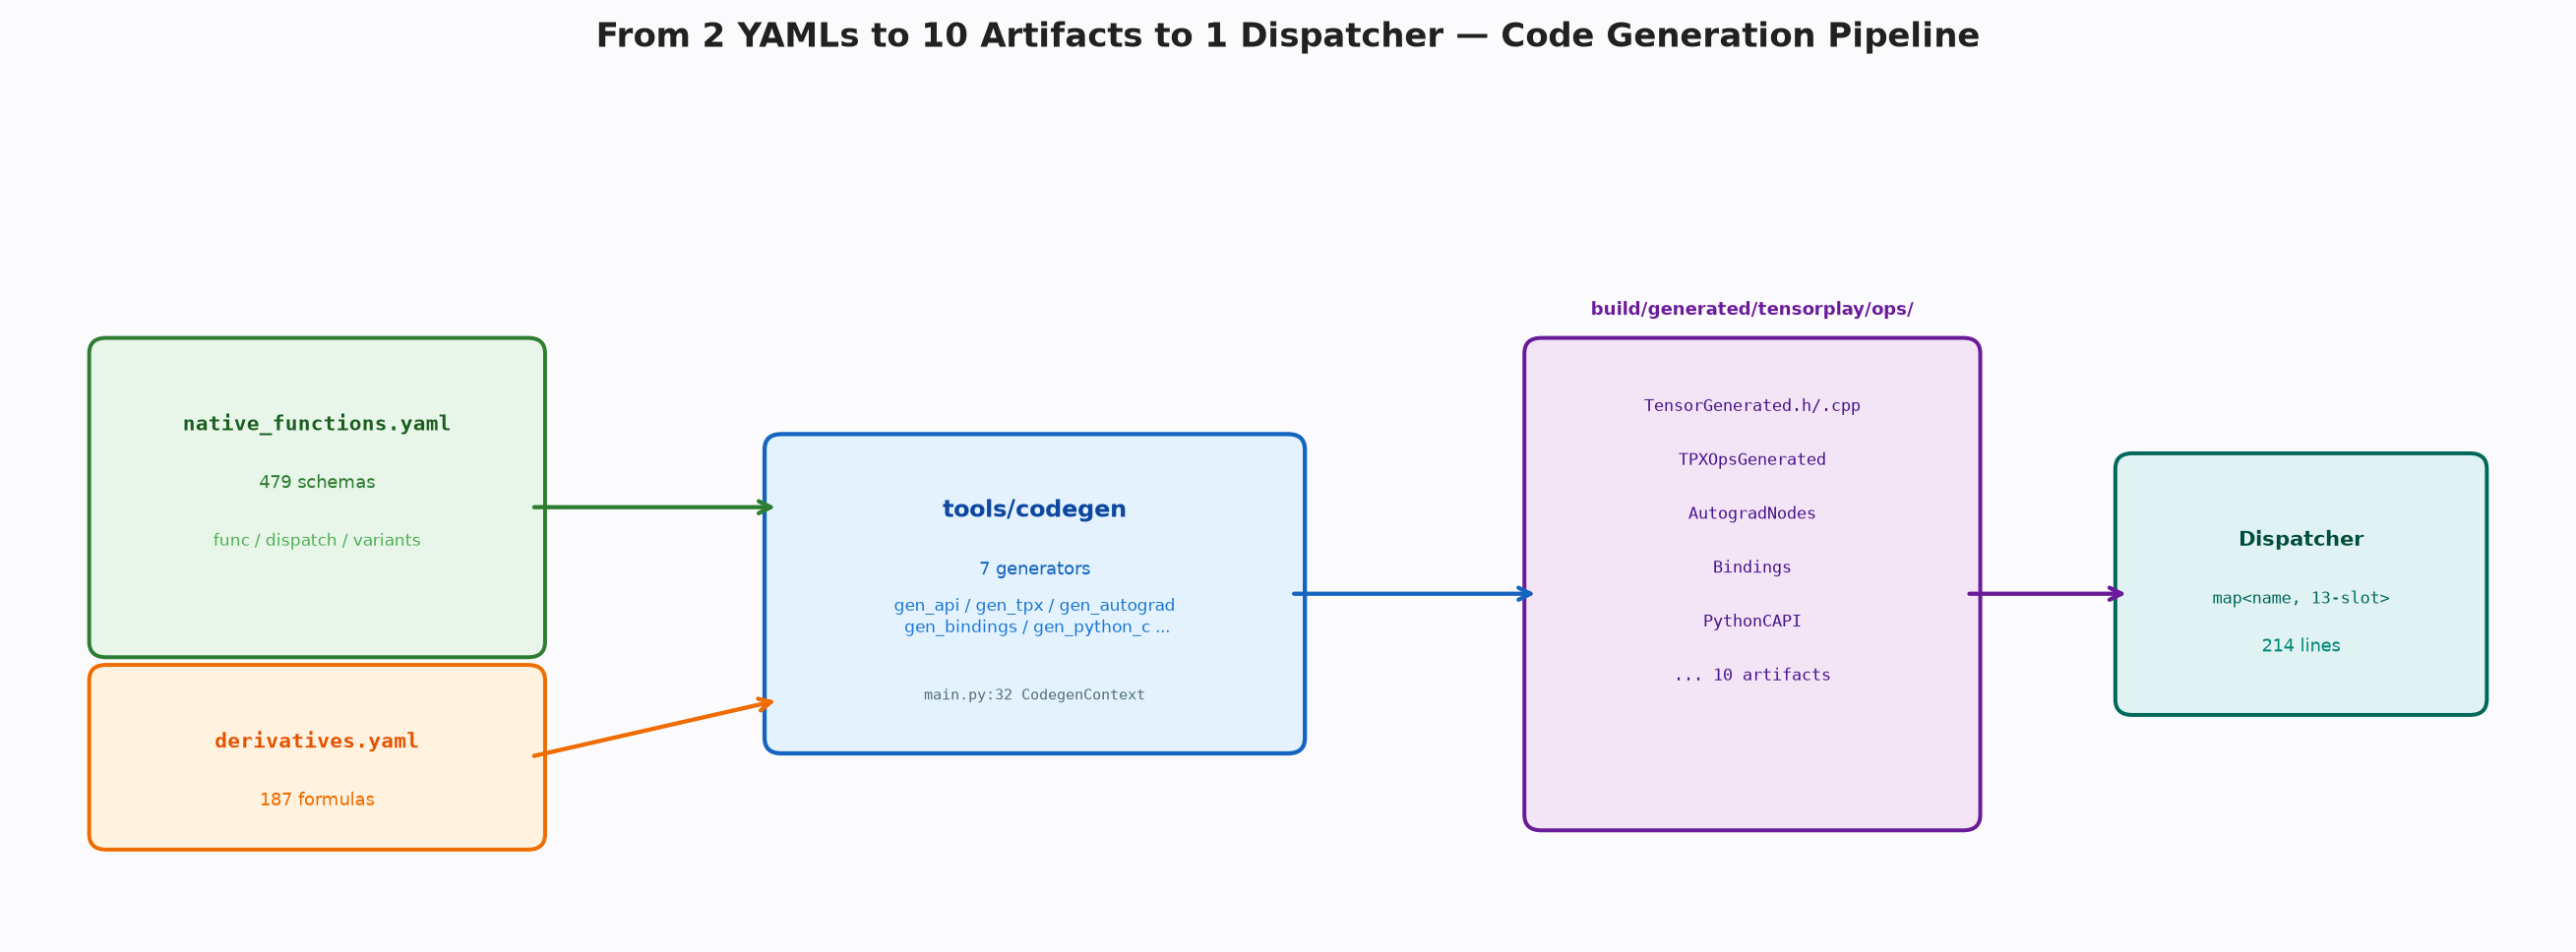
TensorPlay 用两份 YAML 存所有算子的信息。接口、内核分发、梯度逻辑都从这两份文件长出来,不另手写——少一个要「记得同步」的地方,就少一处能忘。
第一份是 config/native_functions.yaml,算子的「身份档案」,写清签名、变体、硬件分发:
# config/native_functions.yaml
- func: convolution(Tensor input, Tensor weight, Tensor? bias, int[] stride,
                    int[] padding, int[] dilation, bool transposed,
                    int[] output_padding, int groups) -> Tensor
  variants: function
  dispatch:
    CPU: convolution_cpu
    CUDA: convolution_cuda
  tags: core
三个字段各管一事:func 是完整签名,C++ 接口、Python 绑定、分发键表都从它拼出来;variants 控制接口形态,function 对应静态工厂方法(如 Tensor::zeros),method 对应实例方法(如 tensor.view);dispatch 指定各硬件后端的内核,没配置 CUDA/Vulkan 的算子,默认走通用的 Composite 兜底实现。
第二份 config/derivatives.yaml 管梯度,不用重复写完整签名,只关联算子名、给出求导公式:
# config/derivatives.yaml
- name: add(Tensor self, Tensor other, Scalar alpha=1) -> Tensor
  self: grad
  other: grad * alpha
self、other 是输入名,grad 是反向传来的梯度,右边是该条边上的公式。生成器不搞字符串替换——它把公式当表达式编译,分词加优先级爬升解析成 AST,走一遍就知道反向节点要存哪些中间量。节点结构、构造参数、grad_fn 的调用点因此是同一份推导出来的,不会各写各的。
改一行 YAML,C++ 接口、Python 绑定、类型提示、梯度节点、自动类型转换注册,跟着一起变。这份文件收了近三千条 - func: 记录。
注意:生成产物第一行都写着
// Generated by tools/codegen/main.py -- DO NOT EDIT。编译报错时,改的是 YAML 或生成器,不是生成出来的文件——否则下一次构建就把你的手改冲掉了。
生成器:一个上下文,多处产出
生成器的入口是 CodegenContext,装着函数列表、梯度表、自动转换集合、输出目录。所有生成模块共享同一个上下文,读的是同一份数据,参数名、默认值、分发键想不一致都难:
# tools/codegen/main.py
@dataclass
class CodegenContext:
    funcs: list
    native_by_opname: dict
    derivatives: dict
    autocast_ops: set[str]
    autograd_ops: dict[str, str]
    out_dir: str
    pkg_out: str | None = None
    ...
整套生成逻辑分成十余个目标模块,各管一片:TensorMethods 写 Tensor 的方法声明与实现,Redispatch 写重分发头,AutogradNodes 写反向节点,Bindings 写绑定,Autocast 写自动转换注册。一次运行,十余份产物落到生成目录。
# tools/codegen/main.py
DEFAULT_TARGETS = ["TensorMethods", "Redispatch", "AutogradNodes", "TPXOps",
                   "AutogradRegistration", "Bindings", "Autocast",
                   "InplaceOrView", "Structured", "PythonFunctional",
                   "PythonCAPI", "PythonDispatch"]
还有个不起眼的小函数 _write_if_changed,决定了改一份 YAML 时到底重编多少翻译单元:
# tools/codegen/main.py
def _write_if_changed(path, content):
    try:
        with open(path) as fh:
            if fh.read() == content:
                print(f'Unchanged "{path}"')
                return
    except FileNotFoundError:
        pass
    with open(path, "w") as fh:
        fh.write(content)
    print(f'Generated "{path}"')
内容没变就不重写,原时间戳留着,只有被改动的 .cpp 会重编,不至于每次都惊动全部产物。
分层:薄 Tensor + 混入方法
Tensor 类尽量薄,底层就一枚自研的侵入式引用计数指针 intrusive_ptr<TensorImpl>(计数嵌在对象自己身上,不是 std::shared_ptr)握着一块张量内存。像 dim()、numel() 这类手写方法只有十来个,其余算子方法都由生成头文件「混入」类里,省掉几百行方法声明:
// p10/include/Tensor.h
class P10_API Tensor {
    // ... dim()、numel()、device() 等手写基础方法 ...
#include "tensorplay/ops/TensorGenerated.h"
};
因为 #include 落在类定义内部,生成头文件里的 static Tensor zeros(...) 就成了 Tensor 的静态成员,Tensor add(const Tensor& other) const 就成了带 const 的实例方法。生成的 .cpp 单独编译。框架顺手在做冲突检测:C++ 不能只靠返回类型或默认值来重载,plan_members 会比对参数类型前缀——两个成员共享同一段前缀、而前缀之后的参数又都带默认值,就算冲突(只给前缀的调用对两者都成立),这种变体提前标成「不发射」,省得编译期报一串 “ambiguous overload”。
分发器:键值定优先级
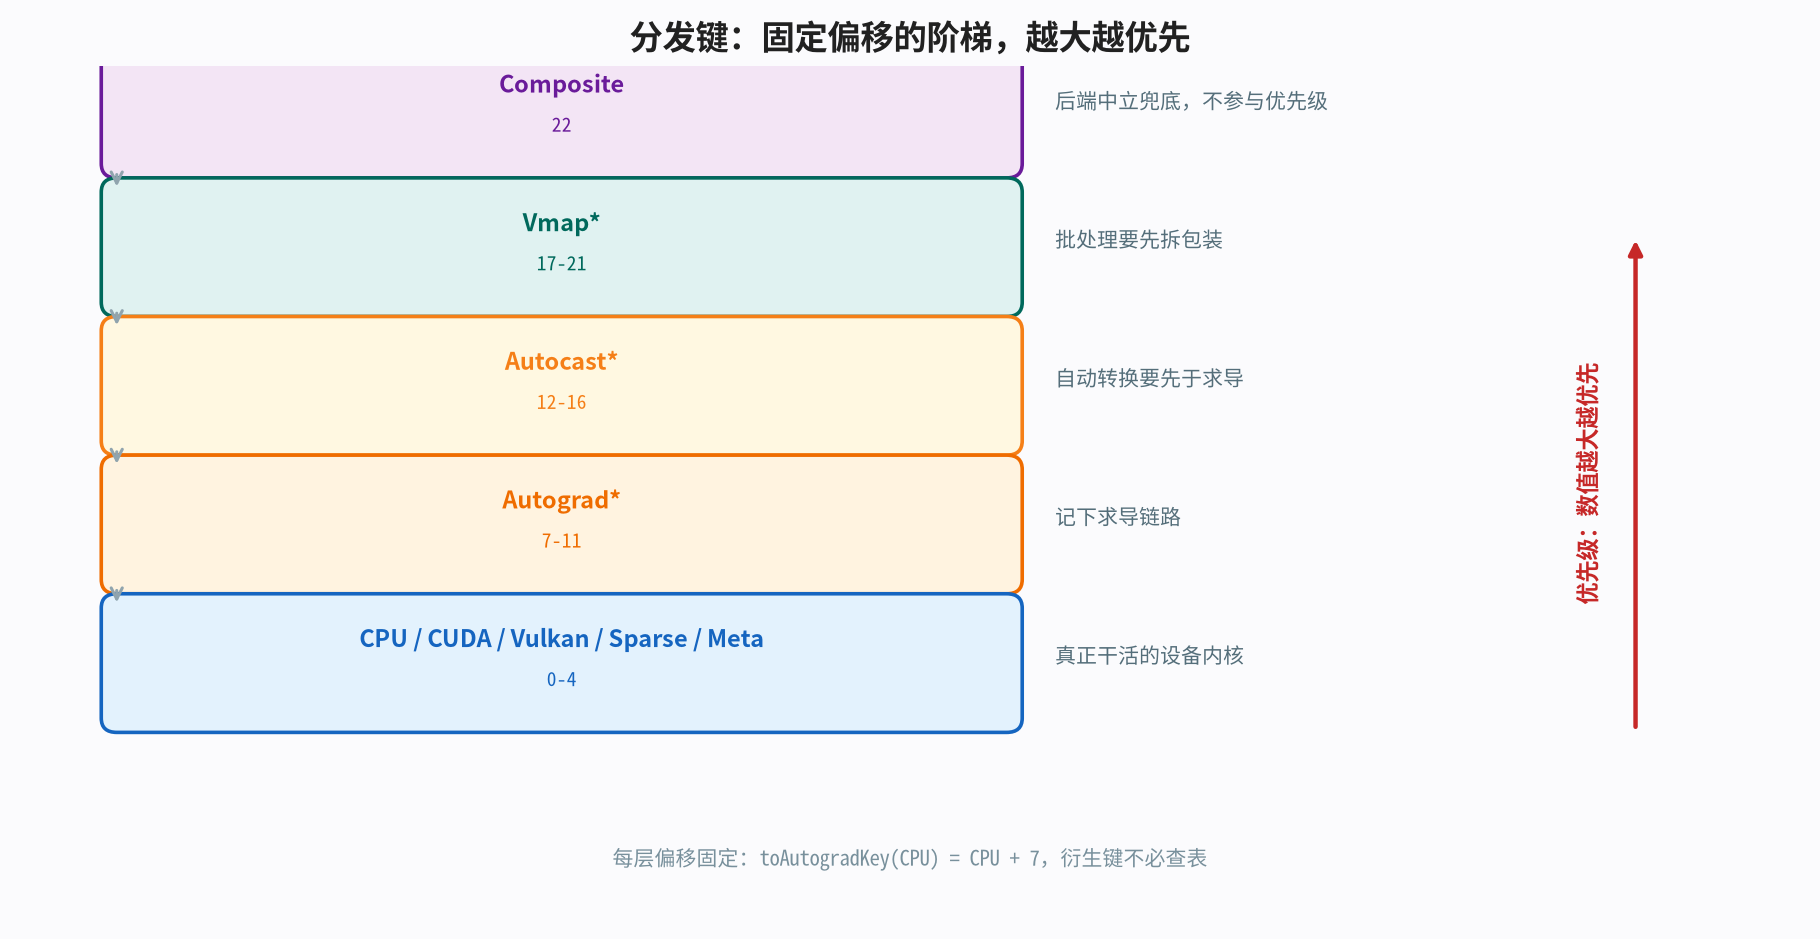
算子运行的路由逻辑,就靠 DispatchKey 这个枚举。框架把设备类型、梯度模式、自动转换、批处理这些运行时属性,编码成固定数值的分发键,数值越大优先级越高:
// p10/include/DispatchKey.h
enum class DispatchKey : uint8_t {
    CPU = 0, CUDA = 1, Vulkan = 2, Sparse = 3, Meta = 4,   // 硬件后端
    Python = 5,
    DynamicLayerBackMode = 6,
    AutogradCPU = 7, ... AutogradMeta = 11,                 // 自动微分(固定偏移+7)
    AutocastCPU = 12, ... AutocastMeta = 16,                // 自动类型转换(固定偏移+12)
    VmapCPU = 17,  ... VmapMeta = 21,                       // 批处理(固定偏移+17)
    Composite = 22,
    VmapMode = 23, DynamicLayerFrontMode = 24,
    EndOfKeys = 25
};

constexpr size_t kAutogradKeyOffset = 7;
constexpr size_t kAutocastKeyOffset = 12;
constexpr size_t kVmapKeyOffset = 17;
这么排有两个顺手的用处。衍生键拿基础键加固定偏移就算出来,toAutogradKey(CPU) 就是 CPU + 7,纯算术,不查表;找当前最高优先级也不用挨个比较,键集是个 32 位位图,highest_priority_key() 找最高的那个置位就行。
键集合不存字段里,每次调用现算:
// p10/include/TensorImpl.h
DispatchKeySet key_set() const {
    const DispatchKey backend =
        sparse_state_ ? DispatchKey::Sparse : computeDispatchKey(device_);
    DispatchKeySet ks;
    ks.add(backend);                       // 稀疏张量优先走稀疏键
    if (is_batched()) {
        ks.add(toVmapKey(backend));        // 批处理场景仅启用Vmap键,跳过梯度
        return ks;
    }
    if (!inference_tensor_) ks.add(toAutogradKey(backend));  // 推理模式关闭梯度
    return ks;
}
不存字段,就少一份存储、也少一件要维护一致的事,付出的只是一次设备查询加两次位运算——比从字段里原子加载一个位集还便宜。
分发表:无锁查找,通用内核兜底
每个算子一张独立分发表,表里按分发键下标放两组原子数组,一组存内核函数指针,一组存签名类型。查询全程无锁:
// p10/include/Dispatcher.h
using KernelFunction = void*;

struct P10_API DispatchTable {
    std::string name;
    std::array<std::atomic<KernelFunction>, kDispatchKeyCount> kernels;
    std::array<std::atomic<const std::type_info*>, kDispatchKeyCount> signatures;
};
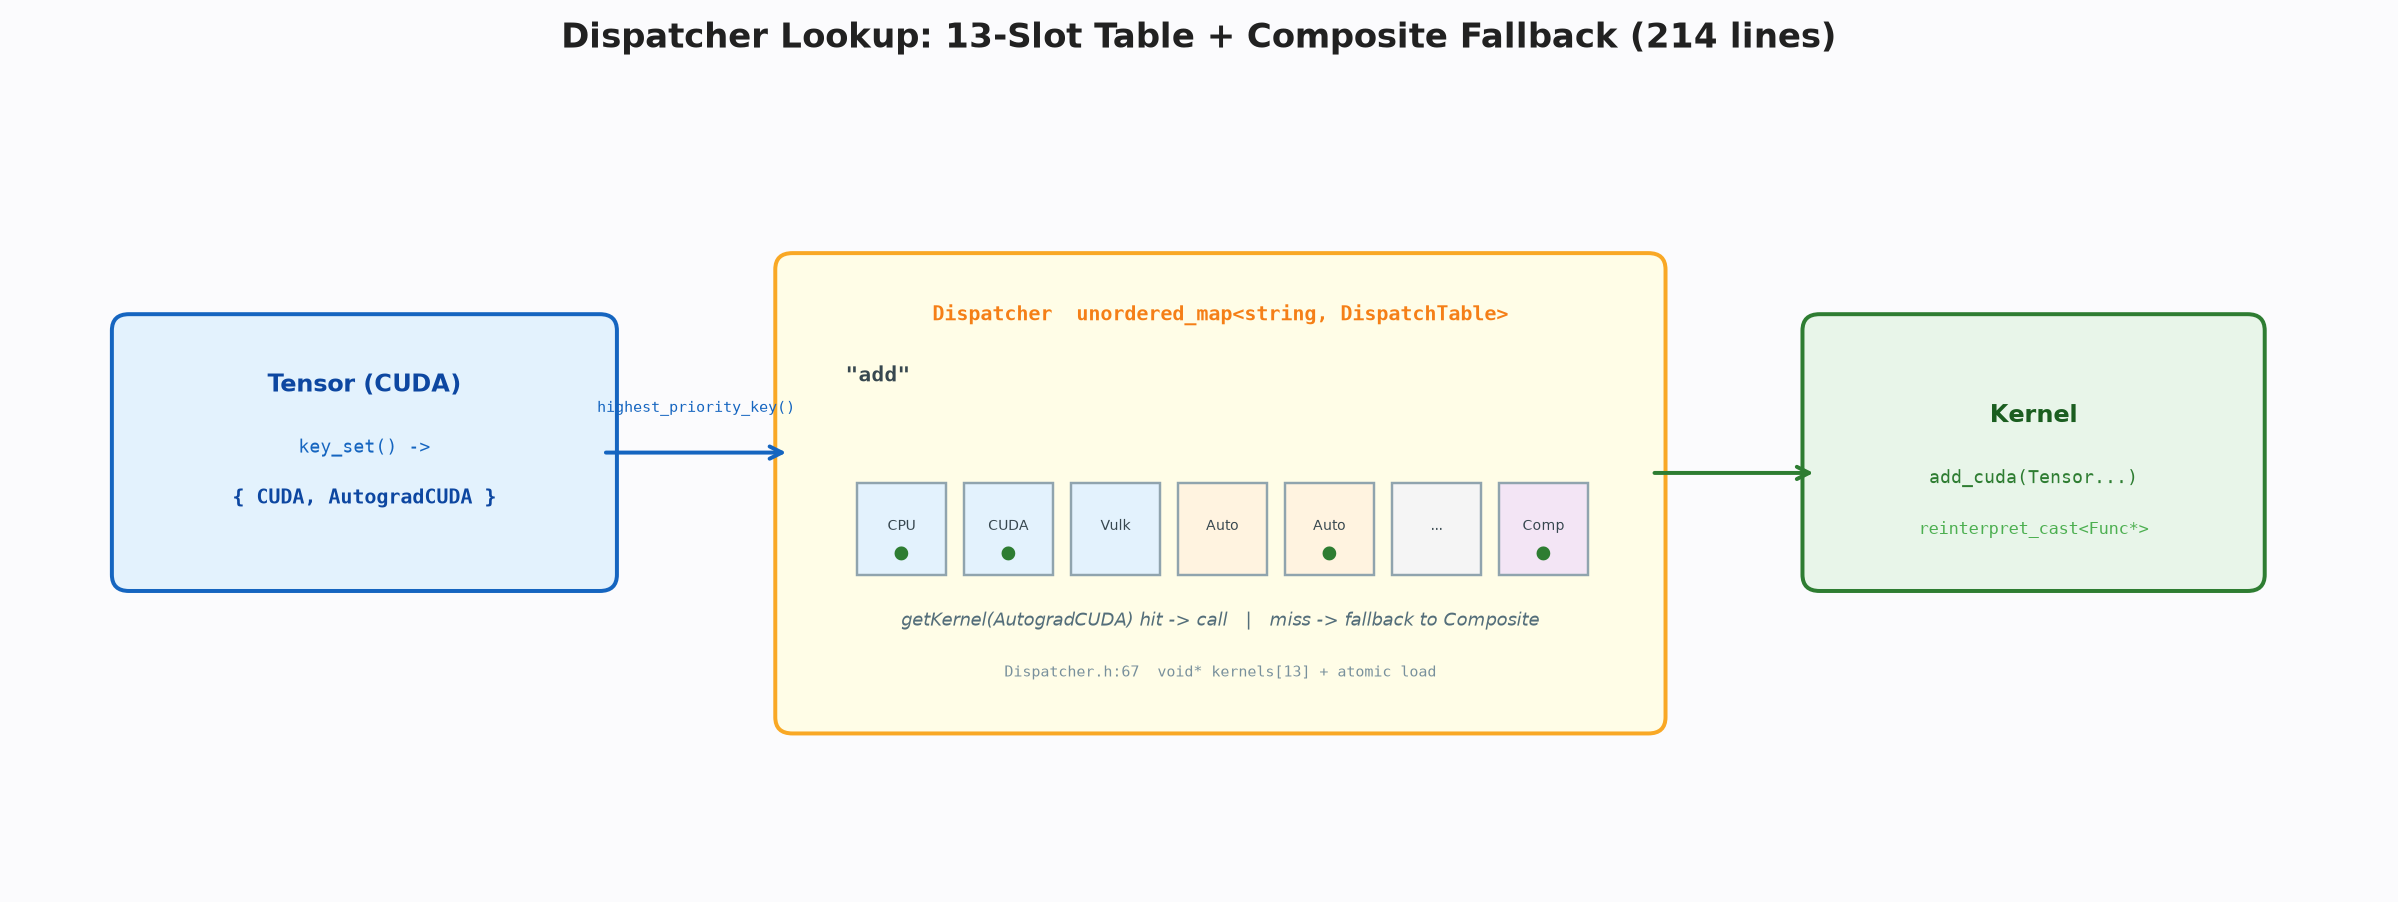
注册用 release 写、查找用 acquire 读。多出来的 signatures 数组是给类型安全兜底的:每个内核注册时记下精确的函数指针类型,调用者把槽位强转回桩签名时如果对不上,就属于未定义行为;记了这一份,好歹能在运行期把这类错揪出来,不至于悄悄执行一段错的内存。
核心的内核查找自带 Composite 兜底:某一后端没注册专属内核,就用通用的组合实现顶上;一旦该后端注册特化内核,直接覆盖,不用先注销:
// p10/include/Dispatcher.h
KernelFunction getKernel(DispatchKey key) const noexcept {
    if (!table_ || dispatchKeyIndex(key) >= kDispatchKeyCount) return nullptr;
    auto kernel = table_->kernels[dispatchKeyIndex(key)].load(std::memory_order_acquire);
    if (!kernel && is_backend_key(key)) {
        constexpr auto kCompositeIdx = dispatchKeyIndex(DispatchKey::Composite);
        kernel = table_->kernels[kCompositeIdx].load(std::memory_order_acquire);
    }
    return kernel;
}
说白了:通用内核让每个后端都跑得起来,特化内核让它跑得快一点。a + b 要是还没给 CUDA 写特化内核,就走 Composite 的组合实现,算出来的东西一样,只是可能慢些。
类型安全:强转收到一处
生成代码不会在调用点自己强转。类型恢复只发生在 DispatchStub::call 这一个地方,整个分发的类型擦除都收在这个模板里:
// p10/include/Dispatcher.h
template<typename Return, typename... Args>
class DispatchStub {
public:
    static Return call(const OperatorHandle& handle, DispatchKey key, Args... args) {
        const auto local = impl::tls_local_dispatch_key_set();
        auto keys = DispatchKeySet::make(key);
        keys = (keys | local.included) - local.excluded;
        DispatchKey selected = keys.highest_priority_key();
        // 处理 Vmap 层、Python 层、变换层的分流
        key = selected;
        if (is_autocast_key(key) && !autocast::is_enabled(key)) [[unlikely]] {
            TP_THROW(NotImplementedError, "Autocast kernel dispatched while autocast is disabled");
        }
        auto kernel_void = handle.getKernel(key);
        if (!kernel_void) {
            if (getenv("TP_TRACE_KERNEL_MISS") != nullptr) {
                // 打印算子、分发键、32 层栈回溯,定位内核缺失
            }
            TP_THROW(NotImplementedError, "Kernel not found for op on backend");
        }
        using FuncType = Return(*)(Args...);
        auto kernel = reinterpret_cast<FuncType>(kernel_void);
        return kernel(std::forward<Args>(args)...);
    }
};
有两处值得提一句。autocast::is_enabled 是前向声明的,为的是不把 Tensor.h 拉进每一个使用者;即便上层调度已经跳过了自动转换键,这里还是再拦一次——「禁用自动转换就当没命中」这条约定,就靠它兜住。分支标了 [[unlikely]],正常路径预测得准。内核找不到时,设上 TP_TRACE_KERNEL_MISS,stderr 里会打出算子名、键和 32 帧栈回溯——排查「某个后端怎么没注册」多半就靠它。
重分发:打点、采形状、动版本号都在这儿
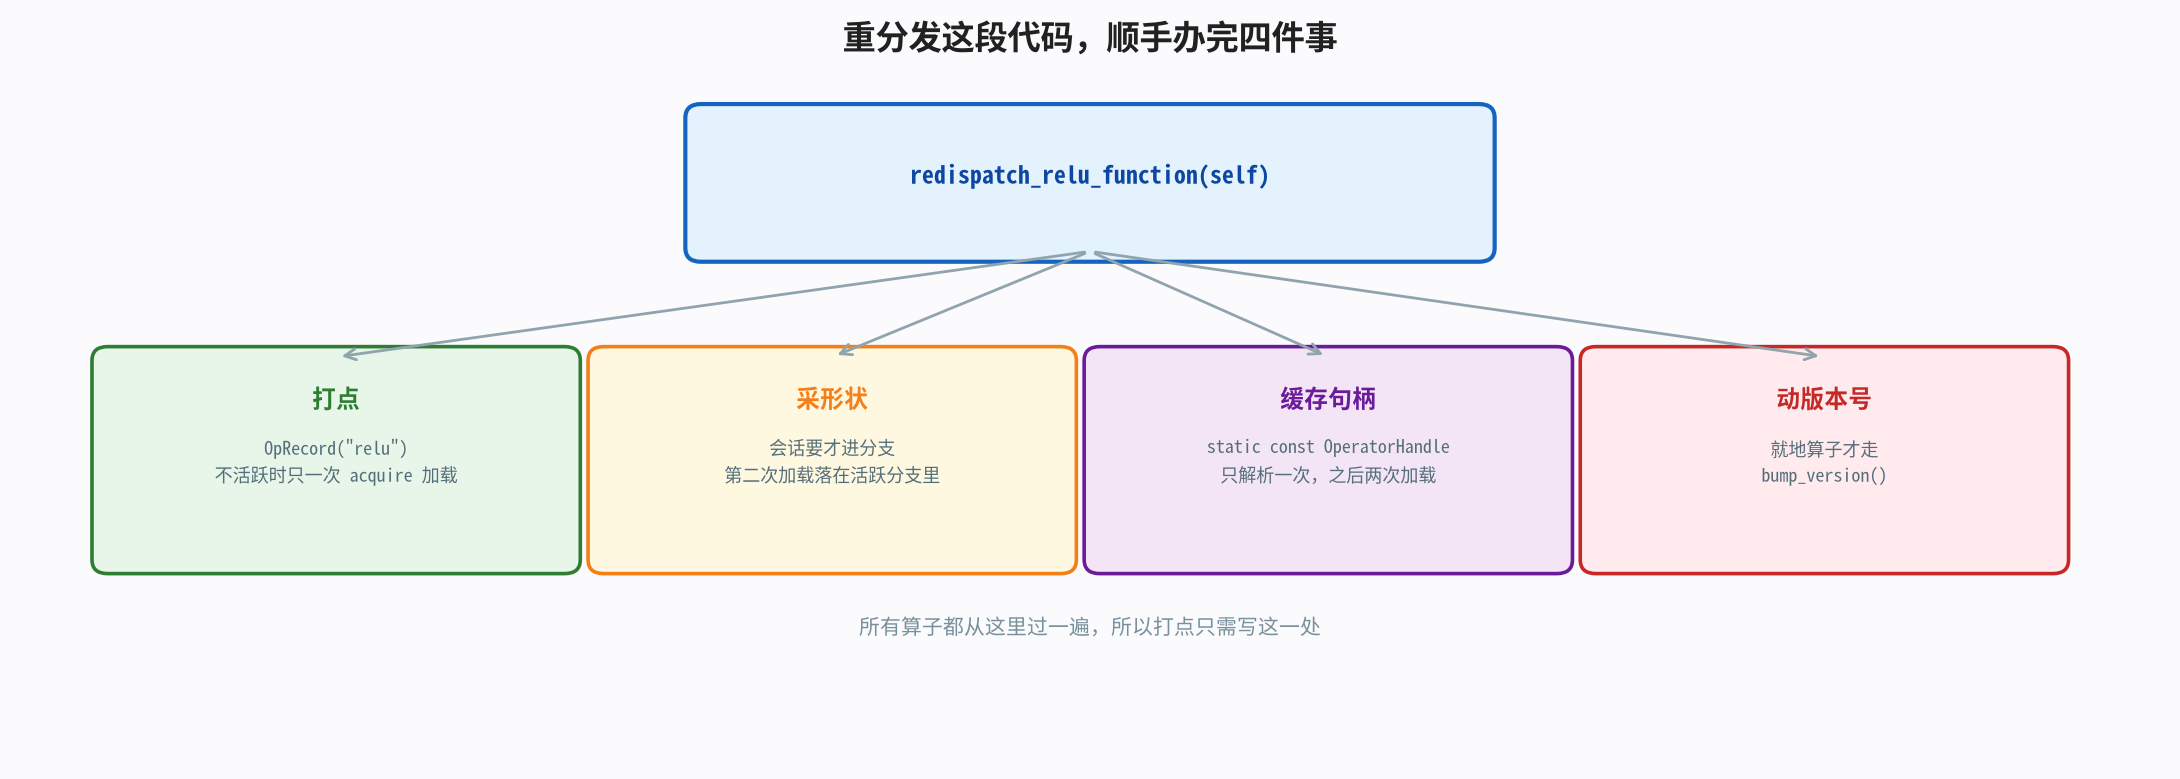
每个算子执行都得从这段生成代码里过一遍,所以打点只需做这一处:
// build/generated/tensorplay/ops/TensorGenerated.cpp (示意)
TENSORPLAY_API Tensor redispatch_relu_function(const Tensor& self) {
    tensorplay::prof::OpRecord __tp_prof_rec("relu");
    if (tensorplay::prof::g_capture_shapes.load(std::memory_order_acquire)) {
        // 按需采集张量形状、数据类型,供性能分析用
    }
    static const OperatorHandle op_handle = Dispatcher::singleton().findHandle("relu");
    DispatchKey __tp_arg_key = dispatchKeyForTensorArgs(self);
    DispatchKey dispatch_key = (is_vmap_key(__tp_arg_key) ? __tp_arg_key : toBackendKey(__tp_arg_key));
    auto&& __tp_result = DispatchStub<Tensor, const Tensor&>::call(op_handle, dispatch_key, self);
    return std::move(__tp_result);
}
这段代码顺手办了几件事:每个算子一个 OpRecord 打点,不活跃的时候只是一次 acquire 加载;形状采集等会话真要了才进分支,第二次加载就落在活跃分支里;static const OperatorHandle 只解析一次,之后热路径是两次 acquire 加载加一次分支预测。就地算子还要 if (!InferenceMode::is_enabled()) self.unsafeGetTensorImpl()->bump_version(); 动一下版本号——这正是上一篇那个版本计数器。
注册:从「一算子一静态对象」到「一键一块」
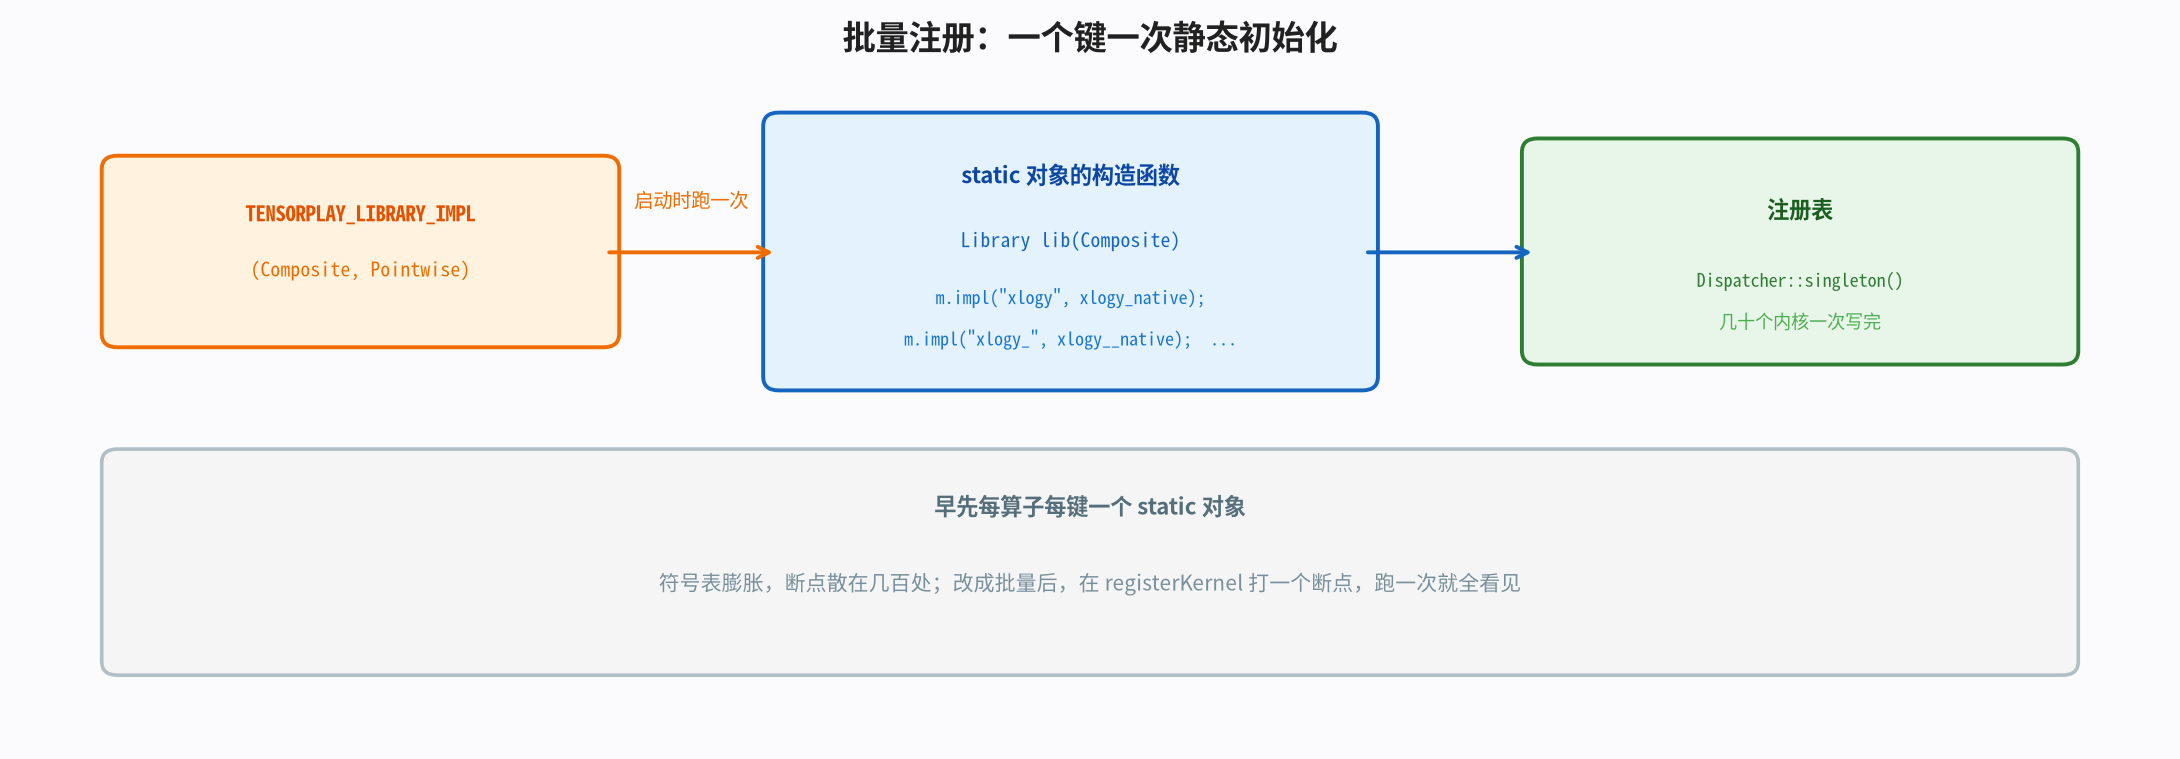
早期注册是每算子每键一个静态对象,每个宏展开一个全局变量,符号表膨胀,断点还散布在几百处。批量宏把同一键下的几十个注册收进一次静态初始化:
// p10/include/Dispatcher.h
#define TENSORPLAY_LIBRARY_IMPL(KEY, NAME) \
    static void TP_CONCAT(tensorplay_library_init_, NAME)(::tensorplay::Library&); \
    static struct TP_CONCAT(TensorPlayLibraryInit_, NAME) { \
        TP_CONCAT(TensorPlayLibraryInit_, NAME)() { \
            ::tensorplay::Library lib(::tensorplay::DispatchKey::KEY); \
            TP_CONCAT(tensorplay_library_init_, NAME)(lib); \
        } \
    } TP_CONCAT(tensorplay_library_init_instance_, NAME); \
    static void TP_CONCAT(tensorplay_library_init_, NAME)(::tensorplay::Library& m)
用起来就是一组 m.impl(...):
// p10/src/backend/composite/Pointwise.cpp
TENSORPLAY_LIBRARY_IMPL(Composite, PointwiseComposite) {
    m.impl("xlogy", xlogy_native);
    m.impl("xlogy_", xlogy__native);
    m.impl("xlog1py", xlog1py_native);
    // 批量注册更多通用算子
}
好处是符号数从算子级降到库级,Debug 也省事些——在 registerKernel 上打一个断点,跑一次就把这个键下所有批量注册都捞出来,不用再挨个去几百个分散的静态对象上设点。
端到端走一遍:一次加法
tp.add(a, b) 整条链:a、b 是 CPU 浮点张量,a 开了梯度,自动转换关闭、无批处理、非推理模式。
- Python 绑定层用快速参数数组拆包入参,调用生成的算子包装;
key_set()现算出键集合{CPU, AutogradCPU},梯度键优先级更高;- 优先命中
AutogradCPU梯度包装,记录反向节点AddBackward; remove_autograd后二次分发到基础CPU键;- 匹配到
add_cpu原生内核,执行真正相加。
这一趟只摸到二十几个槽位里的两个。切换到推理模式,张量不需要梯度,键集只有 {CPU},一次分发就到内核,链路一下子变短。
Python 绑定层:手写占先,生成补位
生成的 Python 入口走 METH_FASTCALL 参数数组,不搭临时 tuple。它和手写的 pybind11 路径靠「手写占先、生成补位」共存:安装时某个名字若已被手写绑定占了,生成的就跳过,不会盖掉手写的语义。两条路在桥上会合,一个算子名只留一个绑定。
设计对比:和主流框架的取舍
主流框架在算子分发上思路大体同源,只是取舍不同。
主流框架把类型提升、别名分析、元张量一并交给生成器管,产物多、键也多;TensorPlay 只做核心链路,稀疏、量化这类低频轴不进核心分发,代价是几个空指针,或者一个组合键。
分发键,两边都用键做运行期路由、按数值大小选内核、用组合实现兜底。主流框架用位图存键集,键一多就得位运算;TensorPlay 把键编成固定偏移、现算键集,几次分支判断,比一次原子位图加载还便宜。
类型安全,主流框架是一整套类型擦除体系;TensorPlay 把类型擦除收进 DispatchStub 一个模板,代码不裸强转,靠 signatures 数组在运行期核对签名。
参考资料
- 仓库:github.com/lexing-2026/TensorPlay(Apache 2.0)
- 文档与教程:tensorplay.cn
- 源码导读:deepwiki.com/bluemoon-o2/TensorPlay