Tensor 简单来讲就是「一块内存,附带形状、步长、设备等属性」。
Tensor 系统的核心思想是:底层字节必须共享,但视图必须各自独立。b = a[0] 可以是同一块内存,不一样的形状;反过来 a + 1 就是新内存。视图+克隆,这两件事很难在「张量类」同时兼顾。
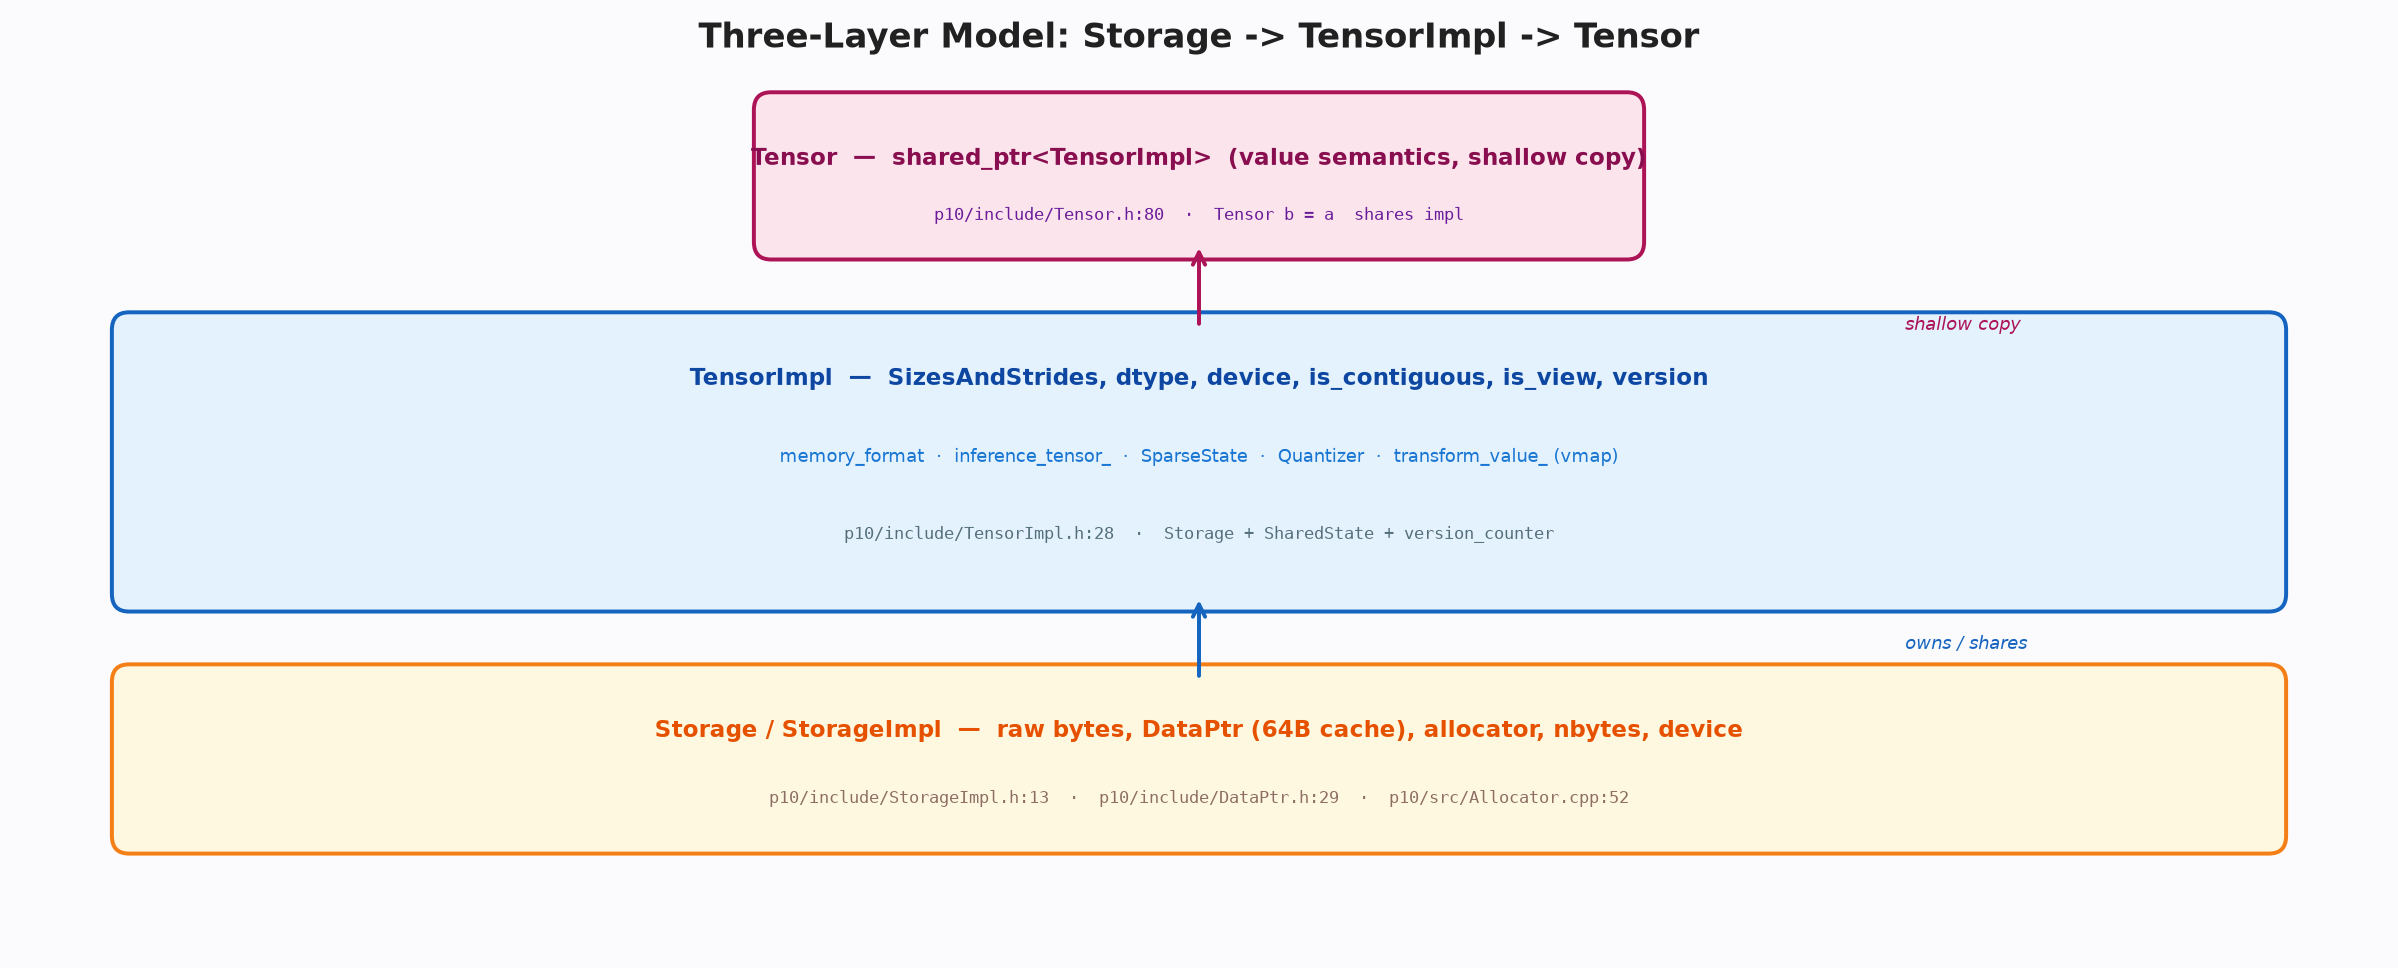
TensorPlay 设计了三层表示模型。
为什么是三层
假设只有一层:Tensor 类直接持有 malloc 获取的指针,以及形状、步长、设备。很难兼顾以下情形:
b = a[0]共享字节、但形状不同。- CPU 上内存来自缓存分配器,CUDA 上来自 cudaMalloc,还有包外部 buffer 的场合。释放逻辑异构。
- 自动微分的梯度历史,拷贝时丢弃。一个张量类管理逻辑复杂。
先看最底下的 DataPtr:
class DataPtr {                        // move-only 句柄
  void*        data_;                  // 交给调用者的数据指针
  void*        ctx_;                   // 传给删除器的上下文(未必等于 data_)
  DeleterFnPtr deleter_;               // void(*)(void*):裸函数指针,无捕获
  Device       device_;                // 设备随分配一起走

  DataPtr(const DataPtr&) = delete;            // 拷贝被显式删除
  DataPtr& operator=(const DataPtr&) = delete;
  DataPtr(DataPtr&& other) noexcept : DataPtr() { swap(other); }
  ~DataPtr() { clear(); }
  void clear() { if (deleter_) deleter_(ctx_);
                 data_ = ctx_ = nullptr; deleter_ = nullptr; }
  void* release() { void* p = data_;          // 调用者接管所有权
                    data_ = ctx_ = nullptr; deleter_ = nullptr; return p; }
};
删除器:同一段字节,malloc 来的要 free,new[] 来的要 delete[],cudaMalloc 来的要交回显存的释放接口,外部传进来的内存则根本不能动。销毁方式和分配相关,所以做成 deleter_,装进同一个句柄,跟 data_ 一起移动、一起消失;ctx_ 是销毁时传给它的参数,大多数时候就是数据指针本身,需要附带额外状态时再单独传。
拷贝:删除器带着所有权,拷贝一次就是 double free 一次。要转移就 release();包外部内存,就挂一个什么都不做的删除器。张量可以被随便分享,但销毁责任只有一份,而且它挂在 DataPtr 上。
分配器。训练时的内存形态极其单调:分配、释放、再来一块一样大的。直接 malloc/free 的话,尺寸复用完全交给系统库,无法满足「释放后立刻再要同尺寸」高频模式。所以分配器自己维护一张空闲表:每块多切出 64 字节头部记尺寸,释放时把块按尺寸还回去,下次同尺寸请求直接拿走。
class CachingAllocator : public Allocator {
  struct Header { size_t size; };                    // 记录整块分配的尺寸
  static constexpr size_t HEADER_SIZE = 64;          // 头部 64 字节,保住对齐
  std::unordered_map<size_t, std::vector<void*>> free_blocks_;  // 尺寸桶 -> 空闲块

  DataPtr allocate(size_t nbytes) const override {
    size_t total = (nbytes + HEADER_SIZE + 63) & ~63; // 请求+头部,取整到 64 的倍数
    void* ptr = nullptr;
    auto it = free_blocks_.find(total);               // 先查桶
    if (it != free_blocks_.end() && !it->second.empty()) {
      ptr = it->second.back();                       // 有块:拿最近还回来的一块
      it->second.pop_back();
    }
    if (!ptr) ptr = alloc_aligned(total);             // 桶空:才向系统要一块
    reinterpret_cast<Header*>(ptr)->size = total;     // 实际尺寸写进头部
    return DataPtr(static_cast<char*>(ptr) + HEADER_SIZE,
                   deleter, Device(DeviceType::CPU)); // 数据指针 = 头部地址 + 64
  }

  static void deleter(void* ptr) {                    // 释放侧:不用查任何表
    char*  raw  = static_cast<char*>(ptr) - HEADER_SIZE;
    size_t size = reinterpret_cast<Header*>(raw)->size;
    instance()->free_blocks_[size].push_back(raw);    // 直接回桶,不碰系统调用
  }
};
桶怎么分:取整到 64 的倍数。请求 100 字节和 124 字节进同一个桶,尺寸相近的分配共享同一批块;不取整,每种尺寸一个桶,空闲表又大又散,碎片多。桶只给实际用过的尺寸开,所以是 unordered_map 而非定长数组。
拿块的方向:back(),后进先出。刚还回来的块大概率还热在 CPU 缓存里,再分配时拿走它最划算,push_back/pop_back 都是 O(1)。
分配和释放不对称的:分配要查表(find(total)),释放完全不查——块头上写的就是取整后的尺寸,减 64 读出来,直接回桶。
分配策略是按设备的。核心代码不写死分配器,按设备类型取分配器的入口:CPU 是上面的缓存分配器单例,CUDA 构建下换成自己的实现,另有 pinned memory 分配器可取。上层(Storage 构造、克隆、拷贝)一律写 getAllocator(device.type()),换分配器实现不用碰核心;跨设备拷贝也有统一入口,目标侧分配、按双方设备选拷贝路径。
class Allocator {
 public:
  virtual DataPtr allocate(size_t nbytes) const = 0;
  virtual DataPtr allocate(size_t nbytes, const Device& device) const {
    (void)device; return allocate(nbytes);      // 单设备后端的默认实现
  }
};
Allocator* getAllocator(DeviceType t);   // 按设备类型分发
Allocator* getCPUAllocator();            // CPU 单例
设备「键」:分配按它选策略,后面调度器还会按它选内核。同一个字段,两层用途。
Storage :数据指针、字节数、分配器、可变长标志,套一层自研的侵入式引用计数指针 intrusive_ptr<StorageImpl>(计数嵌在 StorageImpl 里),就「可以被多个 TensorImpl 安全地共享」。判断两个 Storage 是不是同一个,就是比 StorageImpl 指针。
intrusive_ptr 是引用计数指针的一种,它的计数不放在指针旁边,而是嵌在被指的对象自己身上。StorageImpl 继承一个基类,这个基类里就存着计数。于是句柄本身只有一个机器字——一个裸指针;拷贝一次,就是对嵌在对象里的计数做一次松弛原子自增,不用像 std::shared_ptr 那样再带一个指向「控制块」的指针、多一次间接跳转。强引用和弱引用合在同一个 64 位原子字里,高位是弱计数、低位是强计数,一次原子操作能同时看到两者;计数归零时对象自己 delete,所以对象必须是堆分配的,用 make_intrusive 创建。TensorPlay 没用现成的库,而是自己造了一份——因为框架里到处都要对 TensorImpl、StorageImpl 做引用计数,这份东西值得自己写。
注意区分:主所有权链(Tensor → TensorImpl → Storage → StorageImpl)用的是这份自研指针;而 autograd_meta_、quantizer_ 这类辅助元数据用的仍是 std::shared_ptr。原因很简单:这些元数据不是「被共享的字节」,而是一段可选的额外状态,生命周期短、从不参与视图别名,用现成的控制块指针省心,不必为它们再把计数嵌进对象里。
TensorImpl:扁平、内联
SparseTensor、QuantizedTensor 这些变体,做成子类还是做成字段?
继承方案面向对象,实际是挖坑:每种变体一套虚函数,内核代码里到处 dynamic_cast;头文件层次一旦立起来,改一个字段牵动整棵继承树重编;而绝大多数张量根本不是稀疏也不是量化。TensorPlay 选扁平类——所有状态在一个 struct 里,稀疏、量化、vmap 都做成可空字段,非稀疏张量为这些能力只付几个空指针的开销。
class TensorImpl {                          // 一个扁平类,八组字段
  size_t          storage_offset_;          // ① 元素级偏移(视图从中间开始看)
  SizesAndStrides sizes_and_strides_;       // ② 形状与步长
  DType dtype_; Device device_;             // ③ 类型与放置
  VariableVersion version_counter_;         // ④ 原子版本计数器
  bool      inference_tensor_;              //    推理张量:整体禁用计数
  bool      is_contiguous_;
  MemoryFormat memory_format_;              // ⑤ 布局标签
  std::shared_ptr<AutogradMetaBase> autograd_meta_;  // ⑥ 梯度历史(从不拷贝)
  bool      is_view_;
  Storage   storage_;                       // ⑦ 引用计数的字节
  intrusive_ptr<TensorImpl> transform_value_;  // ⑧ vmap 批处理包装(自研指针)
  std::shared_ptr<Quantizer>  quantizer_;   //    量化器(普通共享指针)
};
形状步长再单独拆出一个 SizesAndStrides,省掉 new 的代价。new 的代价大部分不在系统调用上——小块分配走分配器快路径,几十纳秒的事;真正吃亏的是后面:每次分配要进分配器的地址簿找块、摘块、记一笔账;新块是冷的,跟旁边的对象不挨着,之后遍历、比较、拷贝 sizes 时大概率缓存未命中;再加上两次分配、两次析构。所以秩不超过 5 就用两个定长数组内联在对象里,构造、拷贝、销毁全部绕开堆——多出来的代价只是 TensorImpl 本体大了 80 字节;超过 5 才落堆,缩回去自动释放。
class SizesAndStrides {
  static constexpr size_t kInlineSize = 5;   // 秩 ≤5 全内联
  size_t  size_ = 0;                          // 秩
  int64_t inline_sizes_[5]   = {};            // 定长内联数组
  int64_t inline_strides_[5] = {};
  std::unique_ptr<int64_t[]> heap_sizes_, heap_strides_;  // 超过 5 维才落堆

  const int64_t* sizes_data() const {
    return is_heap() ? heap_sizes_.get() : inline_sizes_;  // 一次分支
  }
};
连续步长的生成公式就一行:strides[i] = strides[i+1] * max(size[i+1], 1),末维步长为 1。形状 (2,0) 算出来是 (1,1),不会除零。
Tensor 本体很薄:唯一的数据成员是自研的 intrusive_ptr<TensorImpl>,外加代码生成的方法。
版本计数器
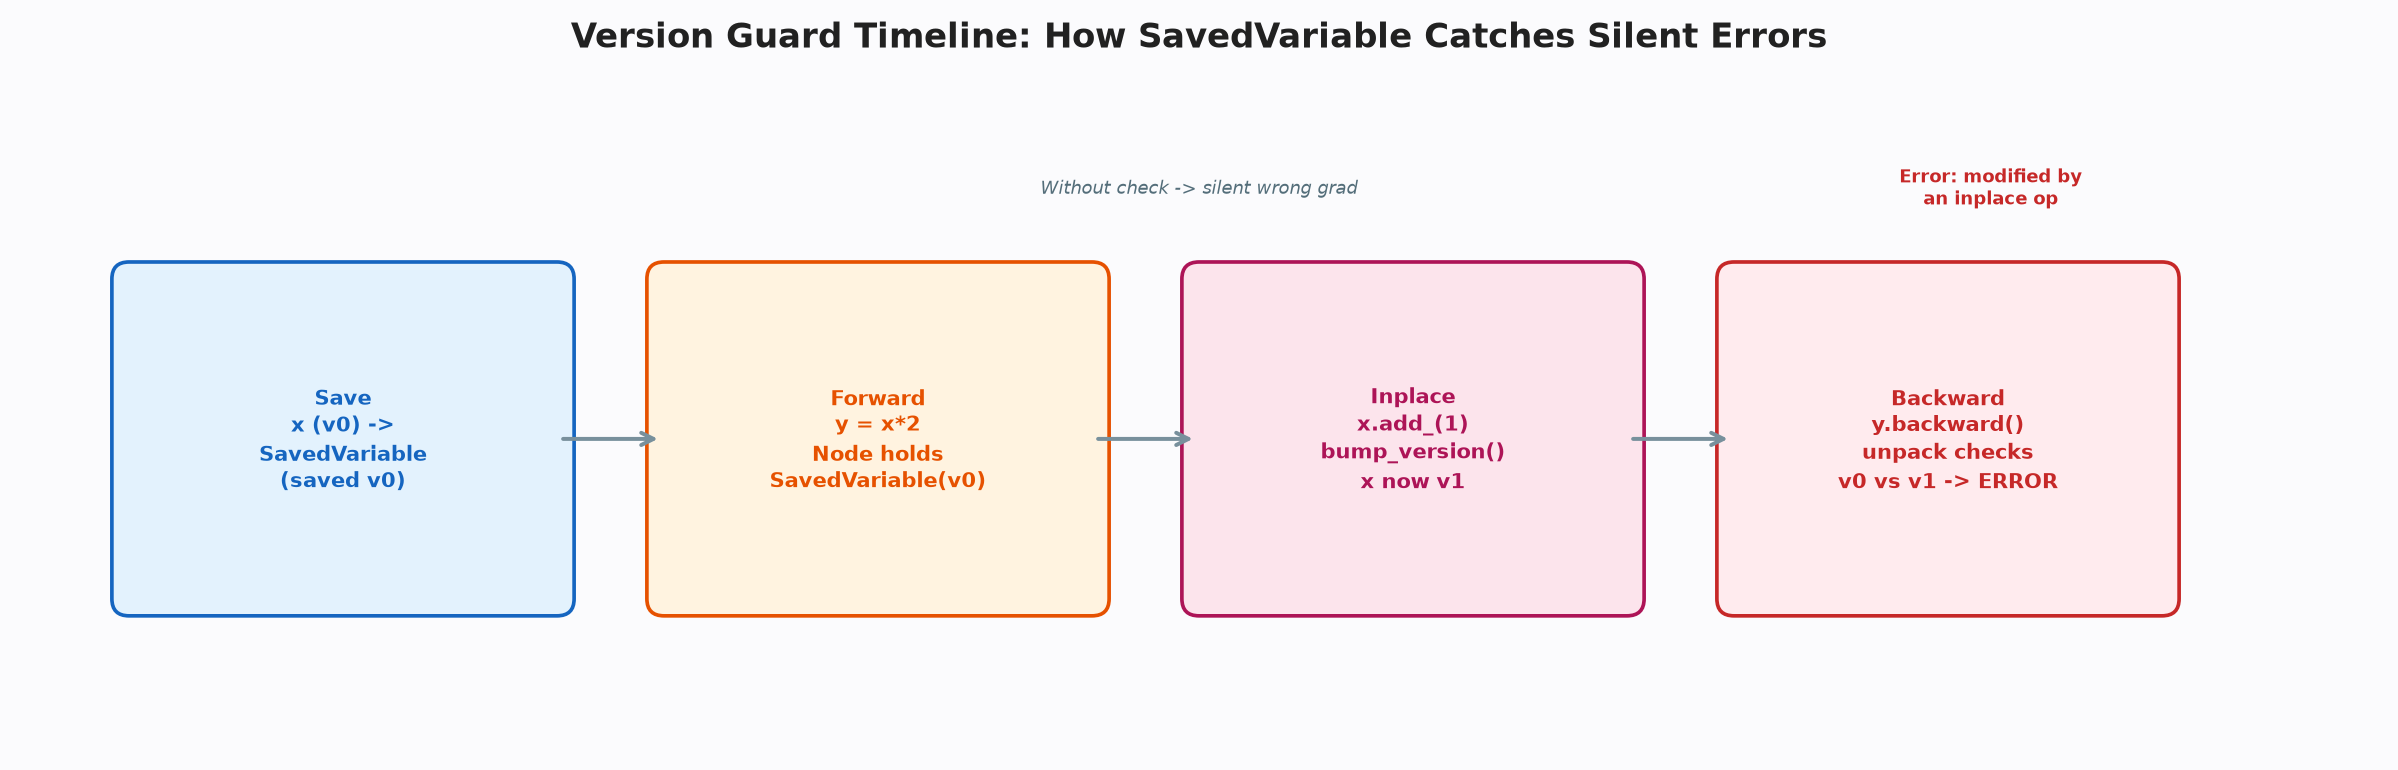
张量为什么需要知道「自己被改过几次」?
因为 backward :反向传播要用前向时的中间值。y = x.exp() 的反向需要重放 exp 的输出,这个输出被保存下来。如果用户在 backward 之前原地改了它,框架只有两个选择:用错值,静默算出错的梯度;或者拒绝。TensorPlay 选后者——保存时记下版本号,解包时对不上就抛异常。。
struct VersionCounter {
  std::atomic<uint32_t> version_{0};
  void    bump()             noexcept { version_.fetch_add(1, std::memory_order_relaxed); }
  uint32_t current_version() const noexcept { return version_.load(std::memory_order_relaxed); }
};

class VariableVersion {                      // 别名之间共享同一个计数器对象
  std::shared_ptr<VersionCounter> counter_;
  bool enabled_ = true;
public:
  VariableVersion()                          // 急切分配:构造即建计数器
    : counter_(std::make_shared<VersionCounter>()) {}
  void bump() { if (!enabled_) return; counter_->bump(); }
  bool shares_counter(const VariableVersion& o) const {
    return counter_ && counter_ == o.counter_;             // 指针同一性
  }
};
容易觉得构造函数里的 make_shared 多此一举——等第一次修改再建不行吗?不行,问题出在视图。视图必须和基张量共享计数器(改视图就是改基张量),而共享靠的是两个 VariableVersion 里的 shared_ptr 指向同一个对象。懒分配的话,先创建的视图会各拿各的计数器,之后原地改基张量,视图那边版本纹丝不动。守卫还在,但已经守不住任何东西了——这类错误不会崩,只会偶尔给出错梯度,是最难查的一类。所以计数器宁可白付一次分配,也要保证「创建即同源」。
推理模式下计数器整体禁用,省掉原子操作;但在推理模式外改推理张量会直接抛异常。
跑一下这个守卫:
import tensorplay as tp

x = tp.Tensor([1.0, 2.0], requires_grad=True)
h = x.exp()         # 反向传播需要重放 h 的前向输出
print(h._version)   # 0
h.add_(1.0)         # 原地修改,版本 0 -> 1
y = h.sum()
y.backward()
# RuntimeError: one of the variables needed for gradient computation
# has been modified by an inplace operation
拷贝构造
TensorImpl 的拷贝构造函数,是整个类里信息密度最高的十几行。它要回答一个问题:TensorImpl b = a,哪些东西是「数据本身」要跟着走,哪些是「这段数据的来历」不能跟着走?
答案全在初始化列表的取舍里:
TensorImpl::TensorImpl(const TensorImpl& other)
    : storage_offset_(other.storage_offset_),
      sizes_and_strides_(other.sizes_and_strides_),   // 形状步长:拷贝
      dtype_(other.dtype_), device_(other.device_),
      version_counter_(other.version_counter_),        // 计数器:共享同一对象
      is_contiguous_(other.is_contiguous_),
      memory_format_(other.memory_format_),
      storage_(other.storage_),                        // 存储:共享(拷贝即别名)
      sparse_state_(other.sparse_state_),              // 稀疏组件:共享
      transform_value_(other.transform_value_),        // 批处理包装:共享
      quantizer_(other.quantizer_) {}                  // 量化器:共享
// autograd_meta_ 刻意不在列表里 —— 拷贝从“零历史”开始
存储被共享了,所以 b = a 是别名,改 b 的数据就是改 a 的数据。版本计数器也被共享了。
而 autograd_meta_ 不在列表里:拷贝出来的张量没有梯度历史,因为历史描述的是「这个值怎么来的」。设想它被顺走了——b = a 之后 b.backward() 会把梯度灌进 a 的父节点,等于在用户看不见的地方替他消费了 a,而且不报任何错。detach() 被做成「拷贝 + 清空历史」而不是一种新视图,也是同一个判断:共享 TensorImpl 就会共享不该共享的东西。
视图
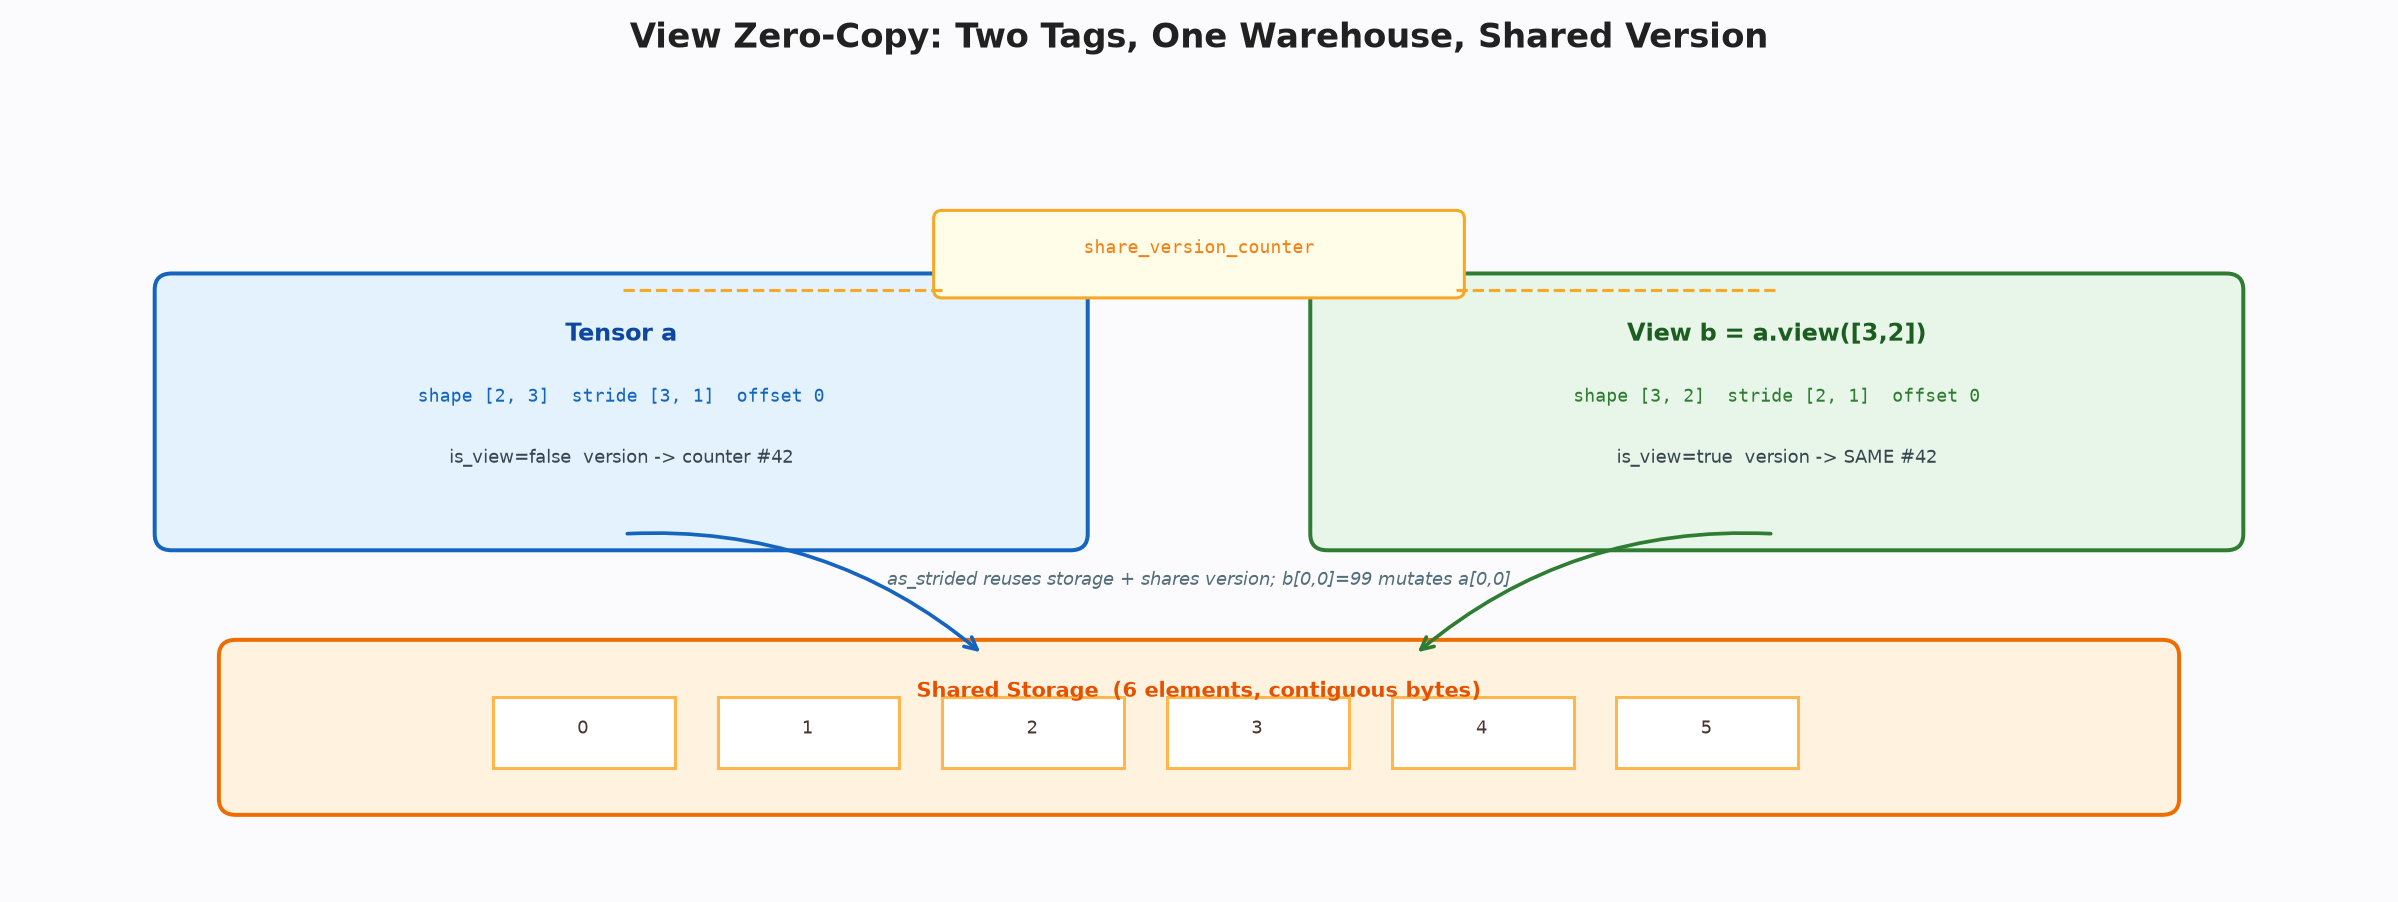
视图语义有三条不变式:复用基张量的 Storage、别名它的版本计数器、有量化器就顺路带上。麻烦在于视图操作有一大家子——view、transpose、select、slice、permute、跨 dtype 视图。不变式要是写在六七个算子里,每个各写一遍,总有一天有人加新视图时漏掉一条——比如忘了共享计数器,版本守卫从此对这种视图静默失效,而这在测试里几乎不会暴露。
TensorPlay 的做法是把所有别名操作收口到一个 as_strided,不变式只写一次:
Tensor Tensor::as_strided(const std::vector<int64_t>& size,
                          const std::vector<int64_t>& stride,
                          std::optional<int64_t> storage_offset) const {
  const int64_t offset =
      storage_offset.value_or(impl_->storage_offset());   // 缺省沿用基偏移
  if (impl_->device().is_vulkan()) {
    /* Vulkan 无步长寻址:唯一走内核物化的分支 */
  }
  Tensor out = Tensor(impl_->storage(), size, stride,
                      impl_->dtype(), offset);            // ① 复用基张量 Storage
  out.unsafeGetTensorImpl()->share_version_counter(*impl_); // ② 别名版本计数器
  if (impl_->has_quantizer())
    out.unsafeGetTensorImpl()->set_quantizer(impl_->quantizer()); // ③ 携带量化器
  return out;
}
于是每个具体视图薄到只剩偏移算术,算完交给 as_strided:
select(dim, i):新偏移 =storage_offset + i * stride[dim],删掉一个维度slice(start, step):偏移前进start * stride[dim],步长缩放stepview:推断 -1 维,计算兼容步长,块结构对不上就报错
Vulkan 是唯一绕开这条路的:shader 里的数据没有步长寻址,视图只能物化成真实拷贝。
克隆是视图的对照面,它的不变式只有两条:字节全新、版本从零。默认策略下,不重叠且稠密的输入保留原步长(转置克隆出来还是转置布局),否则退回行优先;CPU 上两端都行主时直接 memcpy。最容易漏看的一行:结尾的 reset_version。内部那次 copy_ 会碰目标计数器,而克隆出来的是个从未被改过的新值,版本必须归零——不然第一次对账就会误报。
Tensor detail::clone_impl(const Tensor& self, std::optional<MemoryFormat> fmt) {
  const auto format  = fmt.value_or(MemoryFormat::Preserve);
  const auto sizes_v = static_cast<std::vector<int64_t>>(self.shape());
  std::vector<int64_t> strides;
  if (format == Preserve &&
      SizesAndStrides::is_non_overlapping_and_dense(sizes_v, self.strides()))
    strides = static_cast<std::vector<int64_t>>(self.strides()); // 转置克隆出转置
  else
    strides = SizesAndStrides::compute_contiguous_strides(sizes_v); // 落回行优先

  Storage storage(numel(self) * itemsize(self),          // 全新字节
                  getAllocator(self.device().type()), self.device());
  Tensor t(std::make_shared<TensorImpl>(storage, sizes_v, strides, self.dtype(), 0));

  if (self.device().is_cpu() && row_major(strides) && row_major(self.strides()))
    std::memcpy(t.data_ptr(), self.data_ptr(), numel(self) * itemsize(self)); // 快路径
  else
    t.copy_(self);                                       // 感知布局的拷贝

  t.unsafeGetTensorImpl()->reset_version();              // 克隆从“未被修改”开始
  return t;
}
这些行为实测:
import tensorplay as tp

a = tp.Tensor([[1., 2., 3.], [4., 5., 6.]])
v = a[0]                                # 视图
print(a.data_ptr() == v.data_ptr())     # True —— 同一块存储
c = a.clone()                           # 克隆
print(a.data_ptr() == c.data_ptr())     # False —— 新存储
v[0] = 99.0                             # 改视图,a 跟着变
c[0] = -1.0                             # 改克隆,a 不动
print(a)
# tensor([[99.,  2.,  3.],
#         [ 4.,  5.,  6.]])
绑定层:Python 对象怎么变成 C++ Tensor
先澄清一件事:开头那行 b = a,在 Python 里其实什么都没发生——b 和 a 是同一个 PyObject,引用计数加一,C++ 层连拷贝构造都没被惊动。前面四个问题问的是 C++ 层 Tensor b = a 的拷贝构造;Python 里真正穿过绑定层的,是 a[0]、a.clone() 这些操作,参数拆进去、结果包回来,都在这一层。
回包(C++ → Python):tpx_py_wrap 拿 TensorImpl 指针当键查一张缓存表,命中就返回已有的那个 Python 对象——同一个 impl 永远不会被包成两个对象,Python 身份的同一性和 C++ 身份的同一性一一对应。包装身上挂着一个胶囊属性,Python 端垃圾回收把它收走时,胶囊的析构函数顺手抹掉缓存条目,不留脏引用。
拆包(Python → C++):tpx_py_tensor 系按值、按引用、按可变引用三种:按引用省一对引用计数操作,原地算子必须走可变引用,不然写的是副本。进内核前还有一次整体探测,版本号和 requires_grad 一次调用直接从 C++ 侧读出来,不是合法包装就返回 -1,不抛异常。
入口:双路径。pybind11 桥+代码生成的 FASTCALL 入口——参数数组直达,不搭临时 tuple;生成表注册时先查重,pybind11 已经装好的名字直接跳过。参数解析在生成的入口里做:多重重载先用不抛异常的类型探测挑候选(16 种类型加一个 optional 标志位),命中后再做正式检查。内核执行期间 GIL 是放开的,大矩阵运算不占着解释器。
这些取舍的落点
上面每道选择题都在同一个地方收口:引用计数嵌在被指对象里,代价是自己造一个指针类型,换来句柄只有一个机器字。
- 扁平实现类:
TensorImpl不走继承树。稀疏、量化不是子类,而是同一类上的几个空指针——布局独立的稀疏张量与量化张量只在用到时才付代价,稠密路径上多出来的只是一次指针判空。 - 计数合并进一个字:
intrusive_ptr把强计数放低位、弱计数放高位合成一个 64 位原子字,一次原子操作同时看到两者。句柄拷贝是一次松弛原子自增,句柄本身一个机器字,没有「另放一份计数」的第二个机器字,也没有控制块的额外间接跳转。代价是make_intrusive要求堆分配,这是p10/include/IntrusivePtr.h里写下来的交换。 - 绑定层:Python 入口叠在 pybind11 上,但热路径走生成的 FASTCALL 入口——参数数组直达,回包有身份缓存,拆包有不抛异常的类型探测,尽量不在 Python 层造中间对象。
参考资料
- 仓库:github.com/lexing-2026/TensorPlay(Apache 2.0)
- 文档与教程:tensorplay.cn